

大模型的去噪训练通过从含噪数据中提取纯净信号,显著提升模型在复杂场景下的泛化能力与鲁棒性,是构建高质量AI应用的关键技术路径。
在人工智能领域,数据质量直接决定了模型的上限,想象一下,如果让一个学生每天阅读大量错别字连篇、逻辑混乱的书籍,他的理解能力必然受损,大模型的去噪训练正是为了解决这个问题,它像一位严苛的编辑,从海量杂乱的信息中筛选出最有价值的部分,帮助模型建立更清晰的世界观。
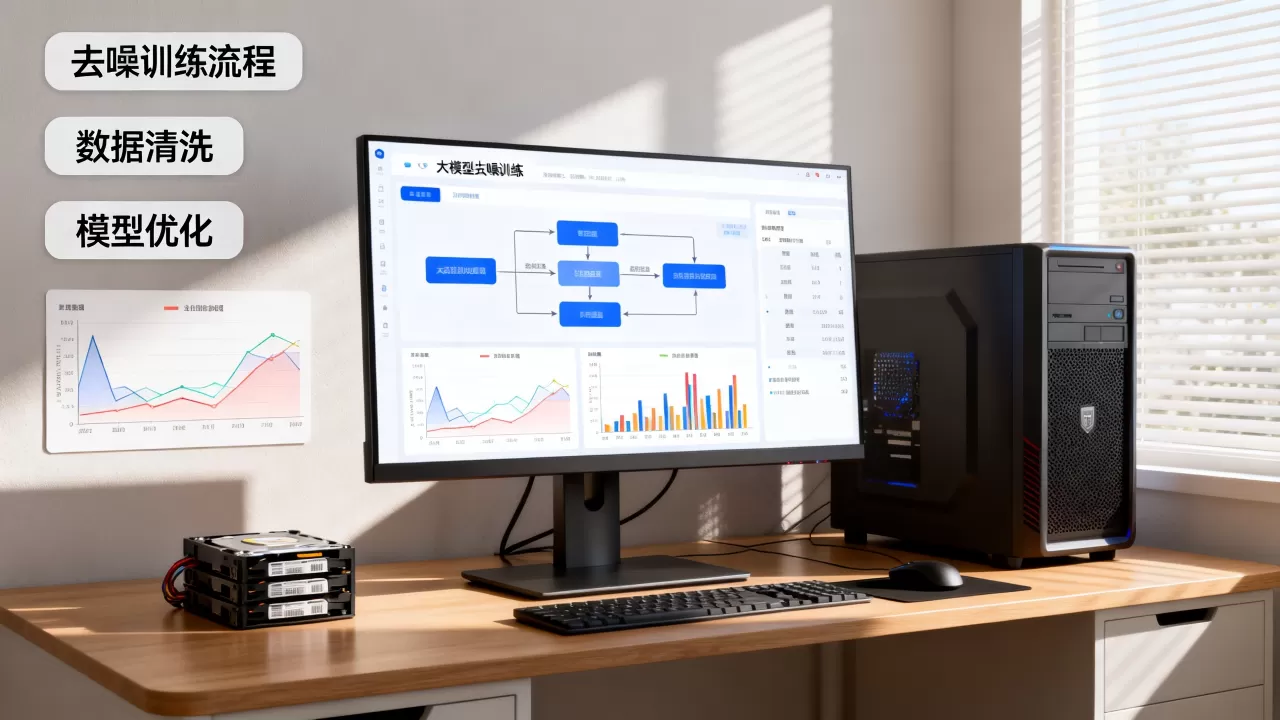
去噪训练的核心原理与价值
去噪训练并非简单的数据清洗,而是一种通过引入噪声并学习恢复原始数据的过程,这种机制迫使模型关注数据的本质特征,而非表面的随机波动。
为什么需要去噪?
互联网上的数据充满了“噪音”,这些噪音可能来自OCR识别错误、网页抓取时的HTML标签残留、用户生成的低质量评论,甚至是恶意注入的对抗样本,如果直接将这些数据喂给模型,会导致以下问题:
- 知识幻觉增加:模型可能将错误信息当作真理记忆。
- 推理能力下降:噪声干扰了逻辑链条的连贯性。
- 训练效率低下:模型需要花费更多算力去拟合无关紧要的细节。
业内专家指出,经过严格去噪处理的数据集,其训练收敛速度通常比原始数据快得多,且最终模型的准确率显著提升。
去噪的主要类型
根据噪声的来源和性质,去噪训练主要分为以下几类:
文本去噪
这是最常见的场景,将包含乱码、重复字符或无关广告的文本,还原为通顺的自然语言,模型需要学习如何识别并修复这些错误。
图像去噪
在视觉大模型中,去噪涉及去除图像中的高斯噪声、椒盐噪声或模糊伪影,这对于提升图像生成和识别的质量至关重要。
多模态去噪
随着多模态大模型的兴起,去噪任务变得更加复杂,模型需要同时处理文本、图像、音频之间的不一致性,确保跨模态信息的对齐与纯净。
主流去噪训练方法对比
不同的去噪策略适用于不同的业务场景,了解这些方法的优缺点,有助于选择最适合的技术方案。
掩码语言模型(MLM)
MLM是BERT等预训练模型的核心技术,其基本思路是随机遮蔽输入序列中的部分词,让模型根据上下文预测被遮蔽的内容。
- 优点:实现简单,计算效率高,适合大规模无监督学习。
- 缺点:遮蔽策略较为简单,可能无法捕捉长距离依赖关系。
- 适用场景:通用文本理解任务,如情感分析、实体识别。
扩散模型(Diffusion Models)
扩散模型通过逐步添加噪声,然后学习逆向过程来去除噪声,这种方法在图像生成领域取得了巨大成功,如Stable Diffusion。
- 优点:生成质量极高,细节丰富,能够处理复杂的分布。
- 缺点:推理速度慢,需要多次迭代去噪,计算资源消耗大。
- 适用场景:高质量图像生成、视频修复。
自编码器(Autoencoders)
自编码器通过编码器将输入压缩为低维表示,再通过解码器重构原始输入,去噪自编码器(DAE)则在输入中人为添加噪声,迫使模型学习鲁棒的特征表示。
- 优点:结构紧凑,能够有效提取数据的潜在特征。
- 缺点:对噪声类型的假设较强,泛化能力有限。
- 适用场景:数据降维、异常检测、特征提取。
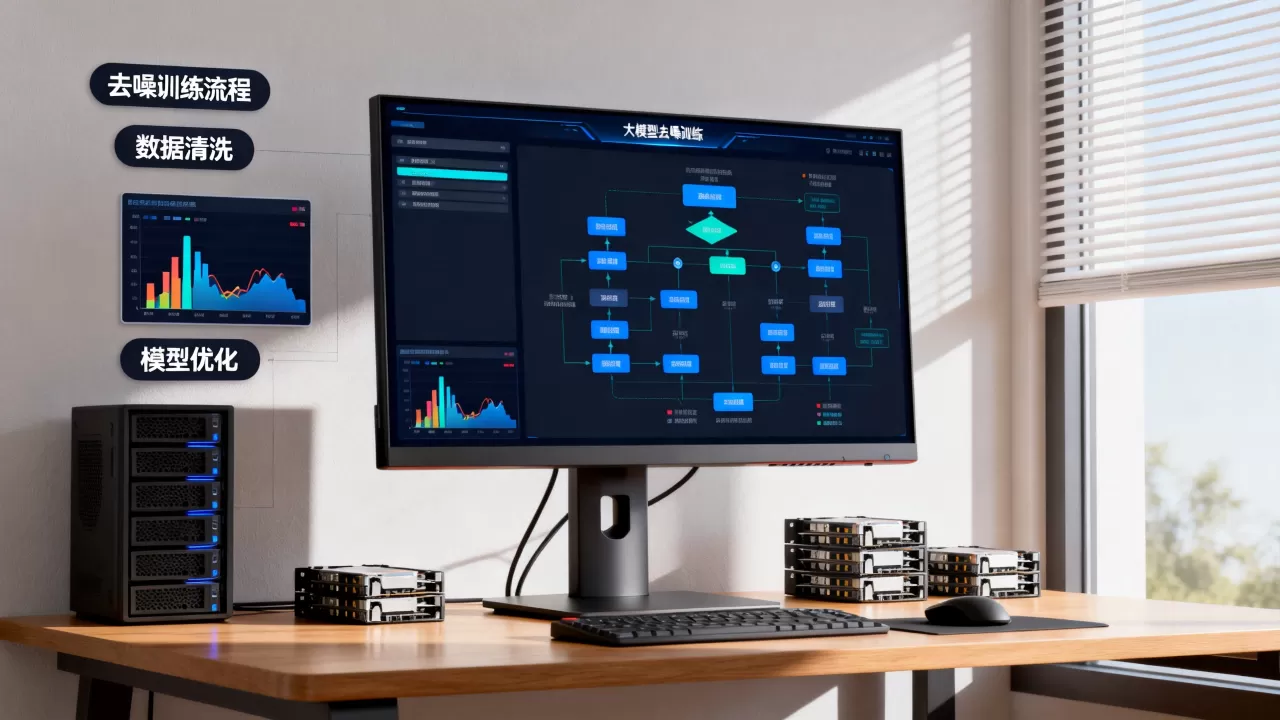
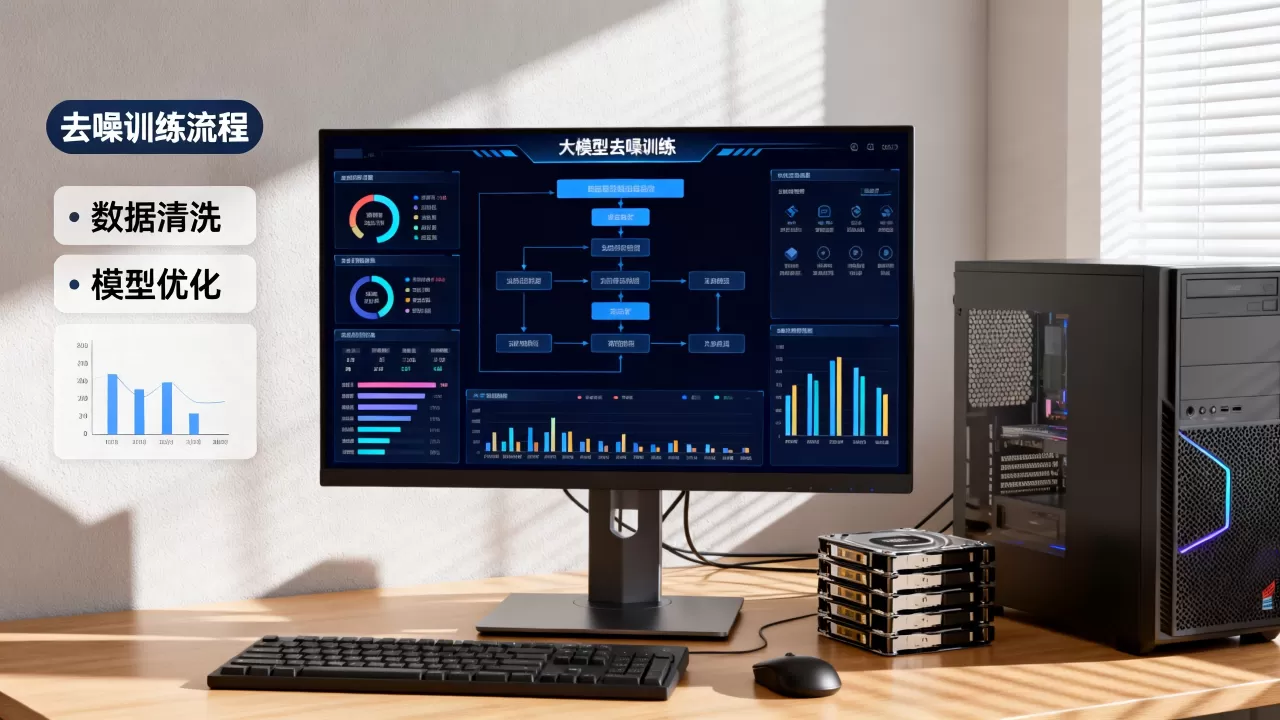
实战中的去噪策略与优化
在实际应用中,如何有效地实施去噪训练?以下是一些经过验证的实操步骤。
数据预处理阶段
在送入模型之前,进行初步的数据清洗是必要的。
- 规则过滤:使用正则表达式去除明显的垃圾信息,如URL、邮箱、特殊符号。
- 重复检测:识别并移除高度重复的样本,避免模型过拟合。
- 语言识别:确保数据语言的一致性,避免多语言混杂导致的困惑。
模型训练阶段
在训练过程中,动态调整噪声强度是关键。
- 噪声调度:随着训练的进行,逐渐降低噪声水平,让模型从粗粒度到细粒度地学习数据分布。
- 对比学习:引入正负样本对,增强模型对噪声的区分能力。
- 课程学习:从简单噪声开始,逐步增加噪声复杂度,模拟人类学习过程。
评估与迭代
去噪效果不能仅凭肉眼判断,需要量化指标。
- 困惑度(Perplexity):衡量模型对数据的预测不确定性,越低越好。
- BLEU/ROUGE分数:用于评估生成文本与参考文本的相似度。
- 人工评估:邀请领域专家对去噪后的数据进行质量打分,确保语义一致性。
据工信部数据,近年来国内多家头部互联网企业通过引入先进的去噪算法,其大模型在垂直领域的表现提升了显著比例,这表明,去噪训练已成为行业共识。
去噪训练的未来趋势与挑战
尽管去噪训练取得了长足进步,但仍面临诸多挑战。
噪声定义的模糊性
在某些情况下,什么是“噪声”并没有明确标准,诗歌中的隐喻、方言中的俚语,对于通用模型可能是噪声,但对于特定领域模型却是宝贵信息,如何动态定义噪声,是一个亟待解决的问题。
计算成本的平衡
去噪训练通常需要更多的迭代次数和更大的模型容量,这导致训练成本高昂,如何在保证效果的前提下降低算力消耗,是业界关注的重点。
隐私与安全
在去噪过程中,可能会无意中泄露训练数据中的敏感信息,如何在去噪的同时保护用户隐私,需要结合差分隐私等技术手段。
Q&A:大模型去噪训练常见疑问
大模型去噪训练的成本高吗?
去噪训练的成本取决于数据规模、模型架构和去噪算法的复杂度,对于小型模型和结构化数据,成本相对可控;但对于千亿参数级的大模型和海量非结构化数据,算力投入确实较大,随着硬件优化和算法效率的提升,单位数据的去噪成本正在逐年下降。
去噪训练会影响模型的创造力吗?
不会,去噪训练旨在去除无关干扰,保留核心语义,这有助于模型更准确地理解指令和上下文,经过良好去噪训练的模型,其生成内容的逻辑性和连贯性更强,从而在特定任务中表现出更优的“创造力”,关键在于噪声注入的策略,应避免过度平滑导致信息丢失。
去噪训练在中文场景下的效果如何?
中文具有独特的语法结构和丰富的同义词,去噪训练在中文场景下同样有效,针对中文特有的噪声,如繁简转换错误、标点误用、网络用语等,专门设计的去噪模型能够显著提升处理效果,据行业共识认为,结合中文语料特点优化的去噪策略,能大幅降低中文大模型的幻觉率。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/405817.html


评论列表(1条)
去噪?数据清洗不干净才是原罪吧。光靠训练去噪,不如一开始就把数据喂干净点,这逻辑有点偷换概念了。