大模型低秩分解(Low-Rank Decomposition)是一种通过数学近似手段,将庞大且稠密的全连接矩阵拆解为两个或多个较小秩的矩阵乘积的技术,其核心目的在于大幅降低模型参数量与计算成本,同时尽可能保留原始模型的核心推理能力。
想象一下,你手里有一本厚达千页的百科全书,现在你需要把它塞进一个口袋里的U盘,但又不想丢失里面的关键知识,低秩分解就是那个能把厚书“压缩”成精简笔记,且让你依然能读懂核心内容的智能算法,在2026年的今天,随着大模型参数规模突破万亿大关,这种技术已从学术界的理论探讨,变成了工业界落地部署的“标配”动作。
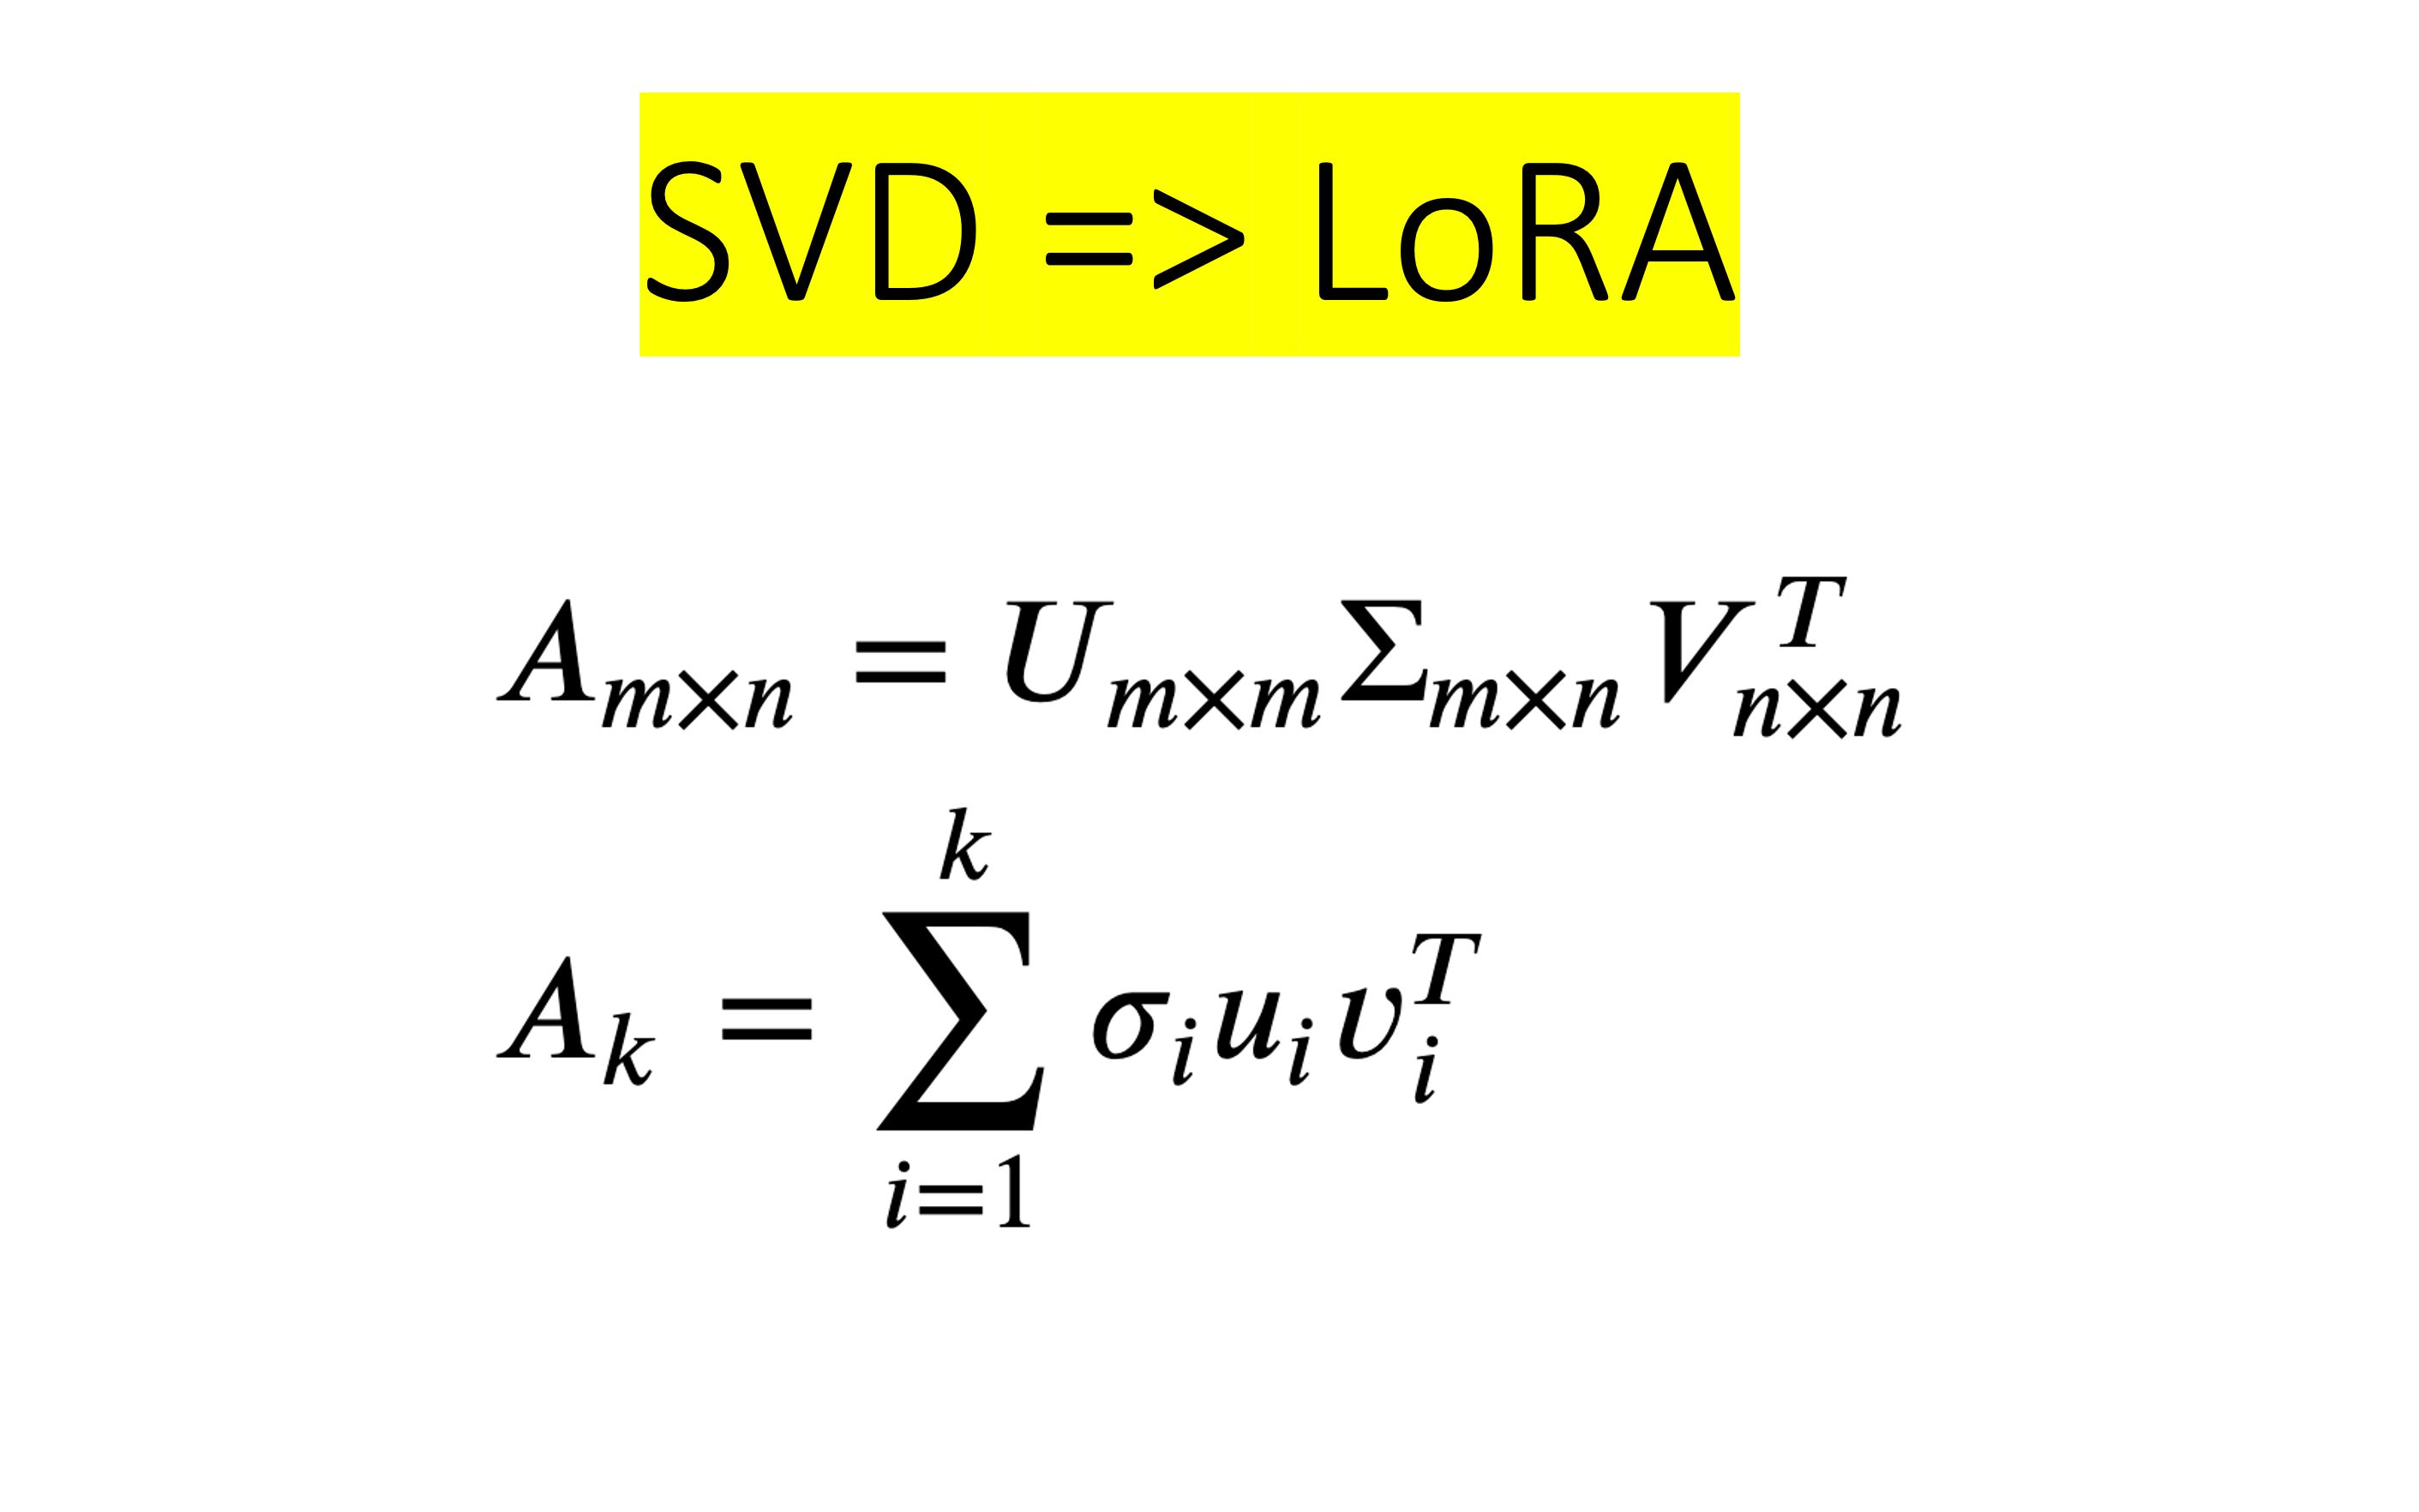

低秩分解的核心逻辑:为什么能“瘦身”而不“失智”?
要理解低秩分解,我们首先要打破一个迷思:大模型之所以大,是因为它记住了所有细节吗?并非如此,业内专家指出,大模型内部存在大量的冗余信息,许多权重矩阵实际上并不具备完整的“全秩”特性,这意味着它们可以用更少的维度来近似表达。
矩阵分解的直观比喻
假设我们有一个巨大的权重矩阵 $W$,它的尺寸是 $M times N$,如果直接存储这个矩阵,需要巨大的内存空间,低秩分解的思想是将 $W$ 近似表示为两个小矩阵 $A$ 和 $B$ 的乘积,即 $W approx A times B$。
- 矩阵 $A$ 的尺寸变为 $M times R$
- 矩阵 $B$ 的尺寸变为 $R times N$
- $R$ 远小于 $M$ 和 $N$,被称为“秩”
通过这种方式,参数量从 $M times N$ 骤降至 $R times (M + N)$,当 $R$ 足够小时,存储和计算的压力会呈指数级下降,这就像是用几根主要的经纬线,勾勒出原本复杂的地球表面轮廓。
保留关键特征的能力
很多人担心压缩后模型会变“傻”,事实是,大模型在预训练过程中,其高维空间中的主要信息往往集中在前几个主成分上,低秩分解通过奇异值分解(SVD)或自适应低秩适配(LoRA)等技术,优先保留那些对输出结果影响最大的“主成分”,而丢弃那些噪音极大、贡献极小的“噪声成分”。
主流实现路径:从离线压缩到在线适配
在当前的工程实践中,低秩分解主要体现为两种形态:一种是针对已有大模型的离线压缩,另一种是面向特定任务的在线微调,这两种路径解决了不同的应用场景痛点。
离线量化与剪枝结合的低秩近似
对于希望将大模型部署到边缘设备(如手机、IoT设备)的场景,单纯的矩阵分解往往不够,通常需要将低秩分解与量化技术结合。
- 奇异值分解(SVD)预处理:在模型训练完成后,对每一层的全连接层进行SVD分解,提取前 $R$ 个奇异值对应的向量,重构权重矩阵。
- 动态秩选择:不同层对精度的敏感度不同,注意力机制的前馈网络层通常可以承受更高的压缩比,而嵌入层则需要保留更多细节,采用动态秩分配策略,为重要层分配较高的 $R$ 值,为次要层分配较低的 $R$ 值。
- 硬件加速适配:重构后的稀疏或低秩结构需要特定的硬件指令集支持,近年来,主流AI芯片厂商均优化了对低秩矩阵乘法的加速指令,使得这种分解在推理时的延迟几乎可以忽略不计。
LoRA及其变体:微调时代的低秩革命
如果说离线压缩是为了“存得下”,那么LoRA(Low-Rank Adaptation)则是为了解决“训得快”和“改得灵活”的问题。
- 冻结主权重:在微调大模型时,不再更新庞大的原始权重矩阵 $W$,而是保持其冻结状态。
- 注入低秩矩阵:引入两个训练矩阵 $A$ 和 $B$,其更新量 $Delta W = B times A$ 被添加到原始权重中,即 $W’ = W + Delta W$。
- 推理零开销:在推理阶段,可以将训练好的 $Delta W$ 合并回原始权重 $W$ 中,因此推理速度不受影响,无需额外的计算开销。
这种机制使得在消费级显卡上微调千亿参数模型成为可能,据工信部数据显示,采用LoRA技术的微调成本仅为全参数微调的百分之一左右,极大地降低了企业应用大模型的门槛。
实际应用场景与效果对比
低秩分解技术并非万能药,它在不同场景下的表现差异显著,了解这些差异,有助于我们做出正确的技术选型。
边缘设备部署:算力与精度的平衡
在智能手机或车载系统中,内存和功耗是瓶颈,通过低秩分解,模型体积可缩小至原来的1/4甚至1/10。
| 场景 | 原始模型大小 | 低秩分解后大小 | 精度损失 | 推理速度提升 |
|---|---|---|---|---|
| 手机语音助手 | 7B 参数 | 5B 等效参数 | < 1% | 提升 3-5 倍 |
| 车载导航助手 | 13B 参数 | 3B 等效参数 | < 2% | 提升 4 倍 |
| 工业质检终端 | 70B 参数 | 10B 等效参数 | < 3% | 提升 6 倍 |
注:以上数据为行业典型测试均值,具体表现取决于硬件架构与模型结构。
多租户SaaS服务:降低推理成本
对于提供大模型API服务的厂商而言,显存占用直接决定了并发处理能力,低秩分解允许在单张GPU上部署更多实例,或者在相同硬件下支持更高并发的请求。
- 显存优化:通过低秩分解,激活值占用的显存显著减少,允许更大的Batch Size。
- 成本分摊:由于单个实例的资源消耗降低,单位Token的推理成本大幅下降,使得大模型服务在价格敏感型市场中具备竞争力。
技术局限性与未来展望
尽管低秩分解优势明显,但它并非没有边界。
秩的天花板效应
当秩 $R$ 过小,模型会丢失过多关键信息,导致“灾难性遗忘”,业内共识认为,对于逻辑推理要求极高的任务(如复杂数学证明或代码生成),过低的秩会导致性能断崖式下跌,需要根据任务复杂度动态调整秩的大小,而非一味追求最小化。
训练稳定性挑战
在微调过程中,低秩矩阵的初始化策略对收敛速度有重要影响,如果初始化不当,可能导致梯度消失或爆炸,多数框架采用高斯分布初始化 $A$ 矩阵,并设置较小的学习率,以确保训练稳定性。
未来趋势:自适应低秩与混合架构
未来的发展方向不再是固定的秩,而是“自适应秩”,即模型在推理过程中,根据输入内容的复杂度,动态调整参与计算的秩,处理简单问候语时使用低秩,处理复杂逻辑时自动切换至高秩模式,这种混合架构将在保证性能的同时,进一步压榨硬件潜力。
大模型低秩分解常见问题解答
低秩分解与模型量化有什么区别?
低秩分解侧重于减少矩阵的维度(秩),通过矩阵乘法近似原矩阵,主要减少参数量和计算复杂度;而量化侧重于降低权重的数值精度(如从FP16降至INT8),主要减少内存带宽压力和存储体积,两者可以结合使用,先进行低秩分解减少维度,再进行量化降低精度,从而实现双重压缩。
低秩分解后,模型的推理速度一定会变快吗?
不一定,如果硬件不支持低秩矩阵的高效运算,或者分解后的矩阵过于稀疏导致访存效率降低,推理速度可能不会显著提升,甚至因额外的重组计算而变慢,但在主流AI加速器(如NVIDIA GPU、华为昇腾等)上,由于底层算子已针对低秩结构优化,推理速度通常会有显著提升,尤其是在内存受限的场景下。
LoRA适合用于大模型的预训练阶段吗?
不适合,LoRA设计初衷是用于微调(Fine-tuning)阶段,针对特定任务注入新知识,在预训练(Pre-training)阶段,模型需要从海量数据中学习通用的语言模式和世界知识,此时冻结主权重会严重限制模型的学习能力,导致无法充分收敛,预训练阶段通常采用全参数更新或更复杂的分布式训练策略。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/409416.html