

大模型部署中引入Jaeger进行全链路追踪,能精准定位推理延迟瓶颈与Token生成断点,将故障排查时间从小时级缩短至分钟级,是构建高可用LLM应用架构的必备基础设施。
在大模型落地生产的实际场景中,开发者最常遇到的痛点并非模型本身不够聪明,而是“不知道哪里慢了”,当用户发起一个提问,请求经过API网关、负载均衡、业务逻辑层,最终到达模型推理服务,再返回结果,这个过程中任何一个环节的网络抖动、显存溢出或代码逻辑错误,都会导致响应超时或结果错误,传统的日志监控只能告诉你“出错了”,却很难告诉你“为什么出错”以及“具体在哪一步出错”,Jaeger作为开源的分布式追踪系统,就像给整个大模型服务装上了“高清行车记录仪”,能够串联起从用户请求到模型回复的每一个微服务调用,让不可见的内部流转变得清晰可见。
为什么大模型部署需要Jaeger?
大模型应用架构与传统单体应用截然不同,其复杂性体现在多个维度,推理过程涉及大量的异步调用和并发处理,模型服务往往由多个微服务组成,包括预处理、向量检索、Prompt组装、模型推理、后处理等,大模型的推理耗时波动极大,受输入长度、模型负载、硬件资源等多重因素影响。
业内专家指出,在缺乏全链路追踪的情况下,运维团队往往陷入“盲人摸象”的困境,当系统响应变慢时,开发人员无法区分是网络传输慢、数据库查询慢,还是模型推理本身慢,Jaeger通过TraceID将分散在各个服务中的Span(跨度)串联起来,形成完整的调用链,从而实现对系统性能的可视化监控。
传统监控与大模型追踪的对比
为了更直观地理解Jaeger的价值,我们可以对比一下传统监控手段与分布式追踪在应对大模型场景时的差异:
| 监控维度 | 传统日志监控 | Jaeger分布式追踪 |
优势分析 |
|---|---|---|---|
| 问题定位 | 需人工关联多行日志,耗时极长 | 自动关联所有相关Span,一键定位 | 大幅降低MTTR(平均修复时间) |
| 性能瓶颈 | 仅能看到整体耗时,无法细分 | 精确到每个子步骤的耗时占比 | 精准优化热点代码或资源 |
| 依赖关系 | 难以理清服务间调用拓扑 | 自动生成服务依赖图 | 清晰掌握系统架构健康度 |
| 错误追踪 | 错误日志分散,难以追溯源头 | 错误Span高亮显示,附带堆栈信息 | 快速复现和修复Bug |
Jaeger在大模型部署中的核心应用场景
在实际操作中,Jaeger不仅仅是一个监控工具,更是优化大模型性能的关键抓手,以下是几个典型的应用场景,帮助团队解决具体问题。
推理延迟分析与优化
大模型推理的延迟通常由两部分组成:TTFT(Time to First Token,首字延迟)和TPOT(Time per Output Token,每Token生成时间),通过Jaeger,可以清晰地看到这两个指标在调用链中的分布。
具体操作步骤
- 注入追踪代码:在业务代码中集成Jaeger客户端,确保每个HTTP请求生成唯一的TraceID,并将其传递给下游服务。
- 定义Span:在关键节点创建Span,请求接收”、“Prompt构建”、“向量检索”、“模型推理”、“结果解析”。
- 添加标签:为每个Span添加关键标签,如
model_name、input_length、
output_length
gpu_memory_usage等,便于后续筛选和分析。 - 数据收集:将Jaeger Collector接收到的数据持久化到Elasticsearch或Cassandra中,以便长期存储和查询。
通过观察Jaeger UI上的火焰图(Flame Graph),开发人员可以一眼看出哪个环节耗时最长,向量检索”Span耗时过长,可能需要优化向量数据库索引;模型推理”Span耗时过长,可能需要考虑模型量化或批处理优化。
Token消耗与成本监控
大模型调用的成本直接与Token数量挂钩,通过Jaeger追踪,可以精确统计每次请求的输入和输出Token数,从而计算单次调用的成本,这对于控制预算和识别异常高消耗请求至关重要。
实施建议
在Span的标签中记录input_tokens和output_tokens,并在Jaeger中设置告警规则,当某次请求的Token消耗超过阈值,或单位时间内的总Token消耗异常激增时,自动触发告警,这有助于及时发现恶意刷接口或代码逻辑错误导致的无限循环生成问题。
如何搭建高效的大模型Jaeger追踪体系?
搭建一个稳定且高效的Jaeger追踪体系,需要关注架构设计和性能调优两个方面。
架构选型与部署
对于大多数企业级应用,推荐使用Jaeger的全内存模式或轻量级存储模式进行初期部署,以降低运维复杂度,随着数据量的增长,再逐步迁移到Elasticsearch后端。
关键组件说明
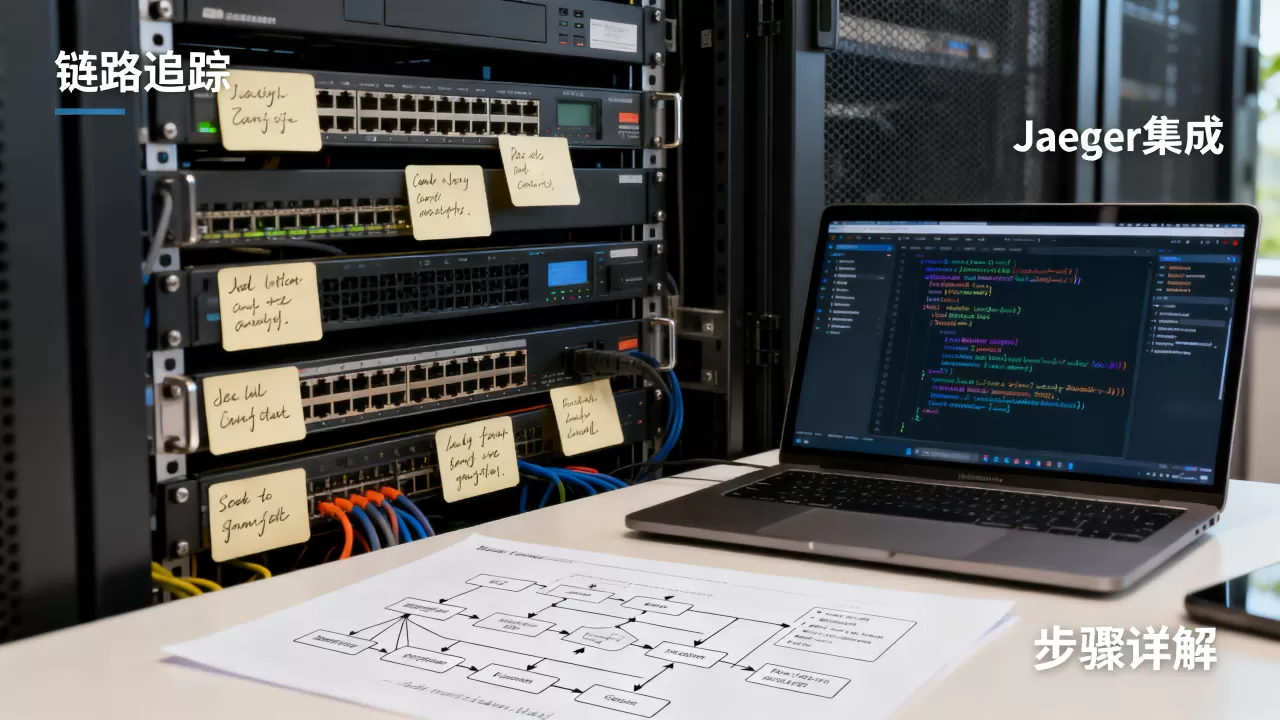
- Agent:轻量级守护进程,负责接收客户端发送的追踪数据,并通过UDP协议转发给Collector,Agent部署在应用服务器旁,对业务性能影响极小。
- Collector:接收Agent转发来的数据,进行聚合、过滤和持久化,Collector是性能瓶颈的关键点,需根据QPS调整并发处理线程数。
- Query:提供Web UI界面,用于查询和可视化追踪数据。
- Storage:数据存储后端,推荐使用Elasticsearch,因其支持复杂的查询和聚合操作,适合分析大规模追踪数据。
性能调优最佳实践
在大模型高并发场景下,Jaeger本身也可能成为性能瓶颈,以下是一些经过验证的调优策略:
- 采样策略:不要全量采样,采用动态采样策略,对高频错误请求或高耗时请求进行全量采样,对正常请求进行概率采样(如1%或10%),这能显著降低存储和计算压力。
- 异步发送:确保Jaeger客户端使用异步发送模式,避免阻塞主业务线程。
- 批量处理:在Collector端启用批量处理,减少网络IO次数。
- 资源隔离:将Jaeger服务与大模型推理服务部署在不同的节点或集群中,避免资源争抢。
常见问题解答:大模型部署链路追踪Jaeger
Jaeger是否支持流式输出的大模型追踪?
Jaeger原生设计基于批处理模型,对于流式输出(Streaming)的支持有限,在大模型场景中,通常建议在服务端将流式数据缓冲,或在客户端将多次Chunk合并为一个Span,另一种做法是使用自定义Span标签记录流式数据的元信息,如Chunk数量、总耗时等,从而在Jaeger中实现近似的全链路追踪。
Jaeger与Prometheus在监控大模型时的区别?
Prometheus擅长监控指标(Metrics),如QPS、延迟分布、错误率等,适合实时告警和趋势分析,Jaeger擅长追踪(Tracing),适合深入分析单次请求的内部细节和依赖关系,两者并非替代关系,而是互补关系,业内共识认为,最佳实践是将Prometheus用于宏观监控和告警,将Jaeger用于微观故障排查和性能优化,两者结合使用才能实现全方位的监控覆盖。
Jaeger追踪对大模型推理性能的影响有多大?
在合理配置下,Jaeger对推理性能的影响微乎其微,研究表明,启用异步追踪和采样策略后,额外开销通常低于1%,主要开销来自网络IO和序列化/反序列化,通过本地Agent缓存和批量发送可以有效降低,对于延迟极度敏感的场景,建议仅在测试环境或特定关键路径上启用全量追踪,生产环境采用采样策略。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/397354.html

评论列表(1条)
吃饱了刷两眼,困但还想看,刚才部署那LLM卡得要死,感觉就是不知道慢在哪儿,看完这篇文章正好下饭。