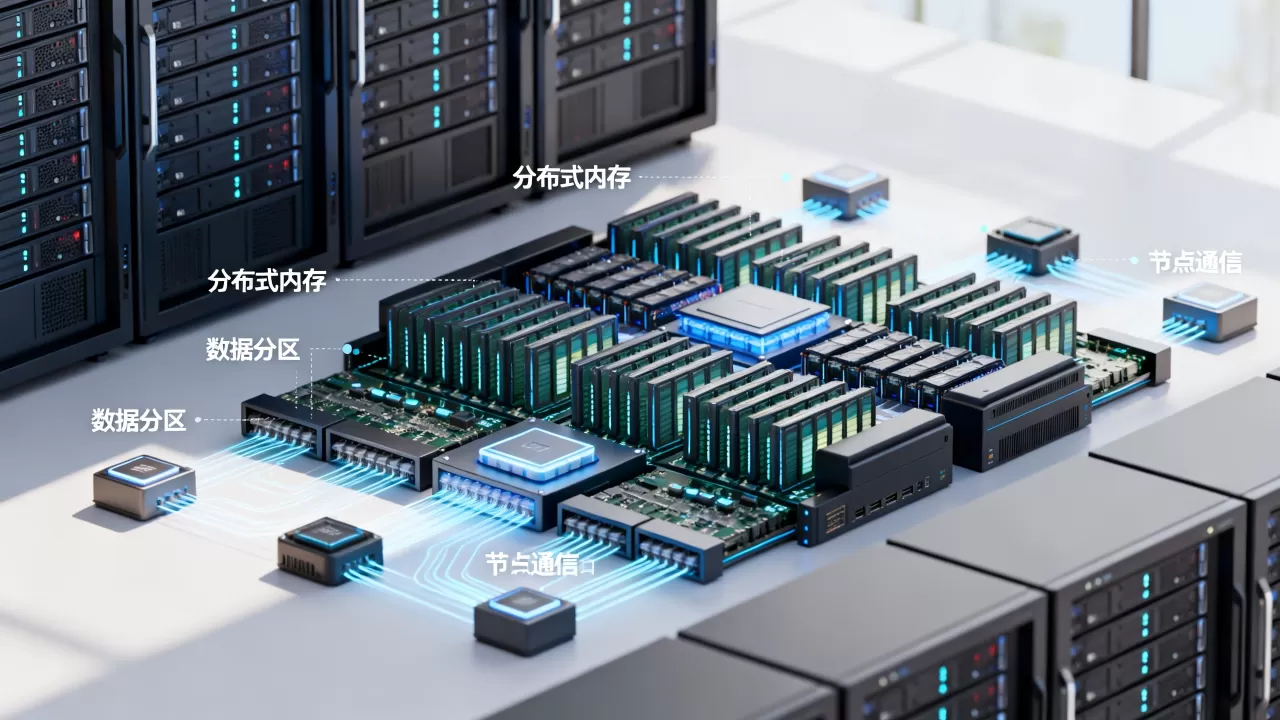
分布式内存计算框架通过将数据存储在集群内存中,大幅减少磁盘I/O,是当前大数据实时处理与批处理场景的核心技术选择。
分布式内存计算框架有哪些主流选择?
当前市场上的分布式内存计算框架种类丰富,各自针对不同计算模型和场景进行了优化,了解它们的特点,是选型的第一步。


Apache Spark:内存计算的开创者
Spark无疑是分布式内存计算最知名的代表,它基于RDD(弹性分布式数据集)模型,将数据抽象为不可变的对象集合,并通过DAG调度器实现高效内存计算,Spark的核心优势在于其统一的批处理能力,以及丰富的生态(MLlib、Spark SQL、GraphX),对于需要处理大量历史数据、进行复杂ETL或离线机器学习的团队,Spark是首选。参考2
Apache Flink:实时流处理的标杆
Flink专注于真正的流处理,其数据流模型支持事件时间、精确一次语义和状态管理,Flink的Checkpoint机制保证了高可用性,在实时计算场景,如实时风控、实时推荐、物联网数据处理中,Flink已经成为事实标准,行业共识认为,在需要低延迟、强一致性的流计算任务中,Flink的表现优于其他框架。
Trino(原PrestoSQL):交互式查询利器
Trino(旧称PrestoSQL)是一款分布式SQL查询引擎,专为快速查询大规模数据而设计,它通过内存管道技术,避免了对磁盘的依赖,实现了秒级到分钟级的查询响应,Trino非常适合数据湖仓内的Ad-hoc查询、BI报表加速,以及跨数据源的联邦查询,如果你需要快速获得分析结果,而不想移动数据,Trino是理想选择。
其他值得关注的框架
- Apache Ignite:内存计算平台,提供SQL、键值存储和计算网格,适用于需要高吞吐量事务处理和分布式计算的场景。
- Hazelcast:基于Java的分布式计算和内存数据网格,常用于微服务状态管理和实时数据流处理。
- Ray:新兴的通用分布式计算框架,在AI训练和强化学习领域表现突出,其内存对象存储支持高效数据共享。
分布式内存计算框架对比:如何根据场景选择?
选型的关键在于匹配业务场景,不同框架在设计哲学、适用场景和性能特征上存在显著差异。
批处理场景:Spark依然是王者
对于数仓ETL、日志批处理、历史数据挖掘这类任务,Spark的成熟度和稳定性是其他框架难以匹敌的,其DataFrame API和SQL优化器(Catalyst)使得大规模批处理任务可以高效执行。参考2
实时流处理:Flink更胜一筹
如果业务要求毫秒级延迟、精确一次处理语义,并需要处理乱序事件,Flink是最佳选择,Flink的流处理能力在应对实时风控、实时监控、在线推荐等场景时,表现非常出色。
交互式SQL查询:Trino速度快
当分析师需要快速查询PB级数据湖,或者构建跨Hive、MySQL、Kafka等多个数据源的联邦查询时,Trino的分布式内存架构能提供秒级响应,它不需要数据迁移,可以直连数据源。
综合考虑:选择框架的决策树
| 需求场景 | 推荐框架 | 核心优势 |
|---|---|---|
| 大规模批处理、ETL、机器学习 | Apache Spark | 统一生态、成熟稳定、批处理性能强 |
| 实时流处理、事件驱动应用 | Apache Flink | 低延迟、精确一次、状态管理 |
| 交互式SQL查询、数据湖分析 | Trino | 秒级查询、跨源联邦、无数据移动 |
| 内存计算、分布式缓存、事务 | Apache Ignite / Hazelcast | 内存数据网格、SQL兼容、低延迟 |
业内专家指出,选型时不应只看技术特性,还需考虑团队技术栈、运维成本以及社区活跃度,如果团队已有Spark经验,引入Flink的迁移成本就可能较高。
分布式内存计算框架怎么选?实操步骤
选型不能仅凭理论,需要通过实际测试来验证,以下是一套可操作的选择流程。
评估自身需求
-
明确计算类型
:是批处理为主,还是流处理,或两者兼有? - 确定延迟要求:是秒级、分钟级还是小时级?
- 数据规模和增长趋势:每日数据量级是多少?是否会快速增长?
- 团队技术能力:团队熟悉Java、Scala还是Python?是否有相关框架的运维经验?
搭建测试环境
- 准备测试集群:可以使用云主机或本地虚拟机,搭建3-5个节点的集群,内存建议配置32GB以上。
- 安装框架:以Spark为例,可从官网下载二进制包,解压并配置
spark-env.sh,指定内存和核心数,使用start-all.sh启动集群。 - 运行基准测试:使用TPC-H或TPC-DS生成的测试数据集,分别运行Spark SQL、Flink Table API、Trino的SQL查询,记录执行时间和资源消耗。
性能调优要点
- 内存分配:Spark中,
spark.executor.memory和spark.memory.fraction直接影响性能,通常建议将executor内存的60-70%分配为存储内存和执行内存。 - 并行度设置:
spark.sql.shuffle.partitions应根据数据量和CPU核心数调整,避免小文件过多或数据倾斜。 - Flink Checkpoint间隔:根据业务容忍的恢复时间设置,一般建议在1-5分钟之间,间隔过短会影响性能。
- Trino查询优化:使用
EXPLAIN分析查询计划,避免全表扫描,合理使用分区和物化视图。
国内分布式内存计算框架的应用实践
近年来,分布式内存计算框架在国内的落地范围越来越广,尤其在金融、电商、物流和互联网行业,随着国产化替代的推进,一些基于开源框架的国产版本也受到关注。
国产化替代趋势
在信创背景下,国内企业开始寻求自主可控的分布式内存计算方案,简米云基于Apache Flink推出实时计算平台,广泛应用于双11大屏实时数据展示,酷番云则基于Spark和Trino提供数据湖分析服务,像华为的FusionInsight、星环的TDH等国产大数据平台,也深度集成了分布式内存计算能力。参考2
典型应用场景
- 实时风控:在金融支付场景中,Flink对每秒上百万笔交易进行实时规则匹配,毫秒级识别欺诈行为。
- 实时推荐:电商平台利用Spark Streaming或Flink,分析用户实时行为,与离线模型结合,生成个性化推荐。
- 交互式数据探索:数据分析师使用Trino连接Hive和Kafka,对用户行为数据即席查询,支持产品快速迭代。
分布式内存计算框架常见问题解答
分布式内存计算框架和传统MapReduce有什么本质区别?
MapReduce采用磁盘中间结果持久化,每个阶段都涉及磁盘读写,导致延迟较高,分布式内存计算框架尽可能将数据保留在内存中,通过流水线计算减少磁盘I/O,从而提升计算速度,在Spark中,Shuffle尽量避免磁盘写入,而Flink通过有状态计算实现内存级流处理。
分布式内存计算框架适合哪些业务场景?
适合需要快速迭代、实时响应或大规模交互式分析的业务,具体包括:实时ETL(数据清洗与转换)、实时监控与告警、在线机器学习模型推理、数据湖查询加速、以及高并发的事务处理场景(如Ignite在金融交易中的应用),对于日志分析、报表生成等传统批处理任务,其优势同样明显。
分布式内存计算框架的稳定性如何保证?
框架通过多种机制保障稳定性:Spark使用检查点(Checkpoint)和血缘关系(Lineage)实现容错,丢失数据可溯回重算,Flink的Checkpoint和Savepoint机制可精确恢复状态,保证Exactly-once语义,Trino通过Worker节点心跳检测和内存限流,避免查询失败,合理配置资源隔离(如YARN或Kubernetes调度)可以防止单个任务影响整个集群。
选择分布式内存计算框架的核心在于匹配业务需求,通过实际测试验证性能,并在运维中持续优化资源分配,才能充分发挥其价值。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/527100.html