单张RTX 4090无法直接完整加载700亿参数模型,必须通过量化技术(如INT4/FP8)配合模型并行或张量并行策略,将显存占用压缩至24GB以内,并依赖CPU+系统内存进行辅助计算或采用多卡协同方案。
在2026年的当下,消费级显卡RTX 4090凭借24GB显存和强大的算力,依然是许多个人开发者和中小企业部署大语言模型的首选硬件,面对700亿参数(70B)这样体量的模型,直接加载原始精度数据显然是不可能的,业内专家指出,解决这一矛盾的核心在于“空间换时间”与“精度换体积”的平衡艺术,我们需要在显存受限的前提下,通过技术手段榨干每一兆字节的性能,让这台顶级消费级显卡能够承载企业级的AI负载。
RTX 4090部署700亿参数模型的技术瓶颈与突破
要理解如何部署,首先得看清拦路虎,70B参数模型在FP16(半精度)格式下,权重数据大约需要140GB显存,即便采用INT8量化,也需要约70GB,而RTX 4090仅有24GB显存,这意味着,如果不进行极端优化,单卡甚至无法启动推理进程。
量化技术:从FP16到INT4的跨越
量化是降低模型体积最直接的手段,通过降低权重数据的精度,我们可以大幅减少显存占用。
- FP16/BF16:原始精度,70B模型需约140GB显存,完全不可行。
- INT8:8位整数量化,显存需求降至约70GB,依然超出单卡极限。
- INT4:4位整数量化,显存需求降至约35-40GB,虽然仍高于24GB,但已接近极限,且配合激活值量化(Activation Quantization)可进一步压缩。
- GGUF/AWQ格式:这是目前主流的高效量化格式,特别是AWQ(Activation-aware Weight Quantization),它在保持精度的同时,能将70B模型压缩至24GB以内,这正是RTX 4090能够运行的关键。
显存管理策略:Offloading技术
当模型权重超过24GB时,必须利用“显存卸载”(Offloading)技术,即将模型的一部分层加载到GPU显存中,另一部分加载到CPU内存中。
- 分层卸载:将模型的前几层放在GPU,中间层在CPU,后几层在GPU,这种策略虽然增加了CPU-GPU之间的数据搬运延迟,但能保证模型完整运行。
- 混合精度推理:关键层使用FP16,非关键层使用INT4,以平衡速度与显存占用。
具体部署流程与实操指南
对于大多数开发者而言,使用开源框架进行部署是最稳妥的路径,以下是基于Linux环境(如Ubuntu 22.04)的标准操作流程。
环境准备与依赖安装
确保你的系统安装了最新的NVIDIA驱动(建议535以上版本)和CUDA Toolkit(12.1或更高),RTX 4090对CUDA版本较为敏感,旧版本可能导致性能损失。
# 检查CUDA版本
nvcc --version
# 安装Python环境
conda create -n llm_env python=3.10
conda activate llm_env
# 安装PyTorch(需匹配CUDA版本)
pip install torch torchvision torchaudio --index-url https://download.pytorch.org/whl/cu121
选择推理引擎:vLLM与LM Studio
目前主流的选择有两个:面向生产环境的vLLM和面向本地测试的LM Studio。
- vLLM:性能极强,支持PagedAttention技术,显存利用率极高,适合服务器环境。
- LM Studio:图形化界面友好,内置GGUF模型下载,适合快速验证。
以vLLM为例,安装命令如下:
pip install vllm
模型下载与加载
推荐使用Hugging Face上的AWQ量化版本模型,例如Qwen-72B-AWQ或Llama-3-70B-AWQ,这些模型已经过专门优化,能在有限显存下保持较高精度。
from vllm import LLM, SamplingParams
# 初始化模型,指定量化方式为awq
llm = LLM(model="Qwen/Qwen-72B-AWQ", quantization="awq", tensor_parallel_size=1)
# 设置采样参数
sampling_params = SamplingParams(temperature=0.7, top_p=0.9, max_tokens=1024)
# 执行推理
outputs = llm.generate("请简述人工智能的未来趋势", sampling_params)
性能优化与常见问题排查
部署成功只是第一步,如何让它跑得更快、更稳,才是考验技术功力的地方。
多卡协同的可能性
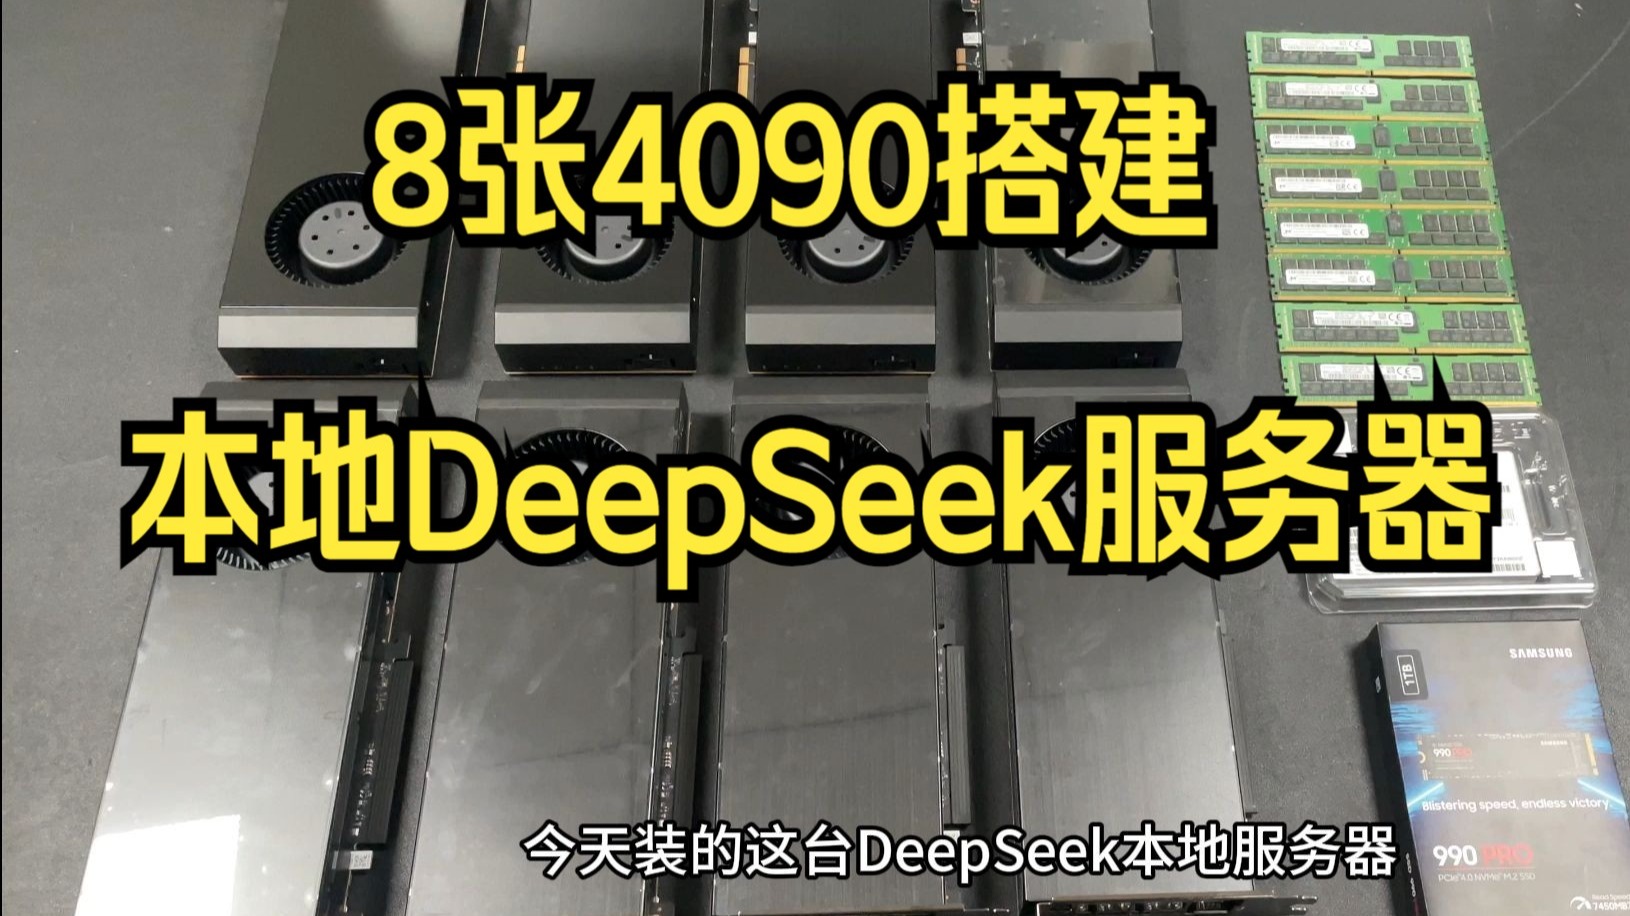
限定为“RTX 4090”,但在实际场景中,单卡跑70B模型往往伴随较低的吞吐量,如果用户拥有两张RTX 4090,可以通过`tensor_parallel_size=2`实现张量并行,这将模型权重拆分到两张卡上,每张卡仅需处理约12GB权重,推理速度可提升近一倍,且显存压力骤减。
显存溢出(OOM)的解决方案
如果在推理过程中遇到CUDA Out of Memory错误,通常有以下几种解决路径:
- 降低Batch Size:将并发请求数设为1,减少激活值占用的显存。
- 启用Swap Space:在Linux系统中,增加交换分区,允许部分显存数据溢出到系统内存,虽然速度变慢,但能避免崩溃。
- 更换更轻量的量化格式:从AWQ切换至GGUF的Q4_K_M格式,进一步压缩体积。
RTX 4090跑700亿参数大模型的成本与收益分析
选择消费级显卡部署大模型,本质上是一场成本与性能的博弈。
硬件成本对比
| 方案 | 硬件配置 | 显存总量 | 预估成本 | 适用场景 |
|---|---|---|---|---|
| 单卡方案 | 1x RTX 4090 | 24GB | ~1.5万元 | 个人研究、小规模测试、低并发应用 |
| 双卡方案 | 2x RTX 4090 | 48GB | ~3万元 | 中等规模服务、较高并发需求 |
| 专业卡方案 | 1x NVIDIA A100 (80GB) | 80GB | ~10万元+ | 企业级生产环境、高并发、高精度要求 |
据行业共识认为,对于预算有限但需要体验70B级别模型能力的团队,双卡RTX 4090方案是性价比最高的选择,单卡方案则更适合那些对延迟不敏感、仅用于离线批处理或原型验证的场景。
能效比考量
RTX 4090的功耗高达450W,在长时间高负载推理下,电费成本不容忽视,相比之下,A100虽然单价高,但其在单位算力上的能效比更优,且支持更先进的NVLink互联技术,若部署规模超过10个并发用户,建议重新评估硬件选型。
RTX 4090跑700亿参数大模型常见问题解答
RTX 4090能直接运行未量化的70B模型吗?
不能,未量化的70B模型需要约140GB显存,远超RTX 4090的24GB上限,必须使用INT4或AWQ等量化格式,将模型体积压缩至24GB以内,并配合Offloading技术才能在单卡上运行。
单卡RTX 4090部署70B模型的推理速度如何?
在INT4量化下,单卡RTX 4090的生成速度约为每秒15-25个token,这一速度对于交互式对话尚可接受,但对于高并发服务则显得不足,若需提升速度,建议采用双卡张量并行,或将模型进一步压缩至Qwen-14B等更小参数规模。
如何监控RTX 4090在推理过程中的显存占用?
可以使用nvidia-smi命令实时查看显存使用情况,或使用nvtop工具进行更直观的监控,在Python代码中,可通过torch.cuda.memory_allocated()和torch.cuda.memory_reserved()函数获取当前分配的显存数据,以便动态调整Batch Size。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/401898.html