分布式聚类通过将海量数据切分至多个节点并行计算,在解决单机内存瓶颈的同时显著提升了大规模数据集的处理效率与扩展性。
为什么单机聚类在2026年已成瓶颈
随着物联网设备、工业互联网以及社交网络的爆发式增长,数据量早已突破PB级别,传统的单机聚类算法,如经典的K-Means或DBSCAN,在处理这种规模的数据时,面临着物理极限的挑战。
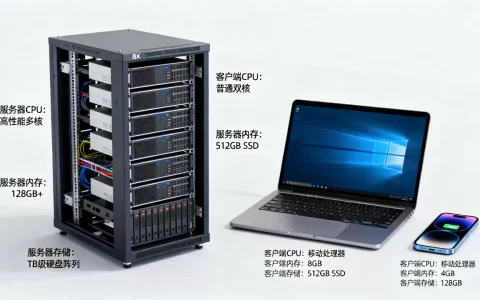
内存与计算资源的硬性约束
单机环境下的聚类过程需要将整个数据集加载到内存中,当数据规模超过服务器内存上限时,系统会发生频繁的磁盘交换,导致性能断崖式下跌,业内专家指出,对于超过内存容量两倍的数据集,单机算法的处理时间往往呈指数级增长,这在实时性要求高的场景中是不可接受的。
扩展性差的架构缺陷
传统架构依赖垂直扩展,即购买更高配置的服务器,高端服务器的成本极高,且存在物理上限,相比之下,分布式架构允许通过增加廉价节点来线性提升处理能力,这种水平扩展能力才是应对未来数据洪流的唯一出路。
分布式聚类的核心架构与原理
分布式聚类并非简单地将算法并行化,而是需要重新设计数据流与控制流,其核心思想是“分而治之”,将全局问题拆解为局部问题,再汇总结果。
数据分片策略
数据如何切分直接决定了聚类的效果与效率,常见的分片方式包括:
- 基于键值的哈希分片:根据数据ID的哈希值均匀分布到不同节点,确保数据负载均衡。
- 基于地理位置的分片:在空间聚类场景中,将相邻区域的数据分配给同一节点,减少跨节点通信。
- 的分片:利用预聚类或采样技术,将相似数据尽量留在同一节点,降低后续合并阶段的复杂度。
Map-Reduce范式的应用
在Hadoop或Spark等分布式计算框架下,聚类过程通常分为两个阶段:
- Map阶段(局部聚类):每个节点对本地数据执行聚类算法,生成局部簇中心或子簇。
- Reduce阶段(全局合并):将所有节点的局部结果汇总,重新计算全局簇中心,并迭代直至收敛。
这种迭代机制确保了局部最优解能够逐步逼近全局最优解,但同时也带来了通信开销的问题。
主流分布式聚类算法对比
不同的业务场景对精度、速度和资源消耗有不同的侧重,选择适合的算法至关重要。
K-Means的分布式变体
分布式K-Means是最基础也是最常用的方案,其优势在于实现简单、收敛速度快,它对初始中心点的选择敏感,且难以处理非球形簇。
基于密度的分布式DBSCAN
DBSCAN擅长发现任意形状的簇并识别噪声点,在分布式环境中,实现DBSCAN的关键在于高效地计算全局邻域关系,近年来,许多研究引入了局部近似算法,在保证精度的同时大幅减少了节点间的通信量。
层次聚类的分布式优化
层次聚类能够生成树状结构,便于理解数据的层级关系,分布式实现通常采用自底向上的合并策略,即先构建局部树,再合并局部树根,这种方法适合需要精细数据洞察的分析场景,但计算复杂度较高。
算法选择决策表
| 算法类型 | 适用数据形态 | 计算复杂度 | 通信开销 | 典型应用场景 |
|---|---|---|---|---|
| 分布式K-Means | 球形簇、密集数据 | 低 | 中 | 用户分群、图像压缩 |
| 分布式DBSCAN | 任意形状、含噪声 | 高 | 高 | 异常检测、地理空间分析 |
| 分布式层次聚类 | 层级结构、小样本 | 极高 | 极高 | 生物基因分析、文档分类 |
落地实施中的关键挑战与解决方案
在实际部署分布式聚类系统时,开发者往往面临数据倾斜、通信瓶颈和结果一致性等难题。
数据倾斜的处理
如果数据分布不均,某些节点负载过重,而其他节点空闲,整体性能将被最慢的节点拖累,解决策略包括:
- 二次哈希:对热点数据进行二次哈希,分散到多个子节点。
- 动态负载均衡:实时监控各节点负载,动态迁移数据块。
通信开销的优化
在大规模集群中,节点间的数据传输可能成为性能瓶颈,优化措施包括:
- 数据压缩:在传输前对簇中心或中间结果进行压缩。
- 增量更新:仅传输发生变化的数据或簇中心,而非全量数据。
- 拓扑感知调度:将通信频繁的数据节点部署在同一机架或同一AZ(可用区),降低网络延迟。
结果一致性与容错
分布式系统难免出现节点故障,采用Checkpoint机制定期保存中间状态,可以在故障发生时快速恢复,对于K-Means等迭代算法,需确保收敛条件在所有节点上达成一致,避免死锁或无限循环。
2026年分布式聚类的发展趋势
随着AI技术的深入,分布式聚类正朝着智能化、自动化的方向演进。
自动化超参数调优
聚类算法的性能高度依赖超参数(如K值、阈值),传统方法需要人工试错,而基于贝叶斯优化或强化学习的自动化调优工具,能够在分布式环境中并行搜索最优参数组合,大幅降低使用门槛。
与联邦学习的融合
在数据隐私保护日益严格的背景下,联邦学习允许在不共享原始数据的前提下进行联合建模,分布式聚类与联邦学习的结合,使得机构间可以在保护数据隐私的同时,共同发现全局数据分布规律,这在金融风控、医疗研究等领域具有巨大潜力。
边缘计算场景下的轻量化聚类
随着边缘计算的发展,聚类任务正从云端下沉到边缘设备,轻量化分布式聚类算法能够在资源受限的边缘节点上运行,实现数据的本地预处理与初步聚类,仅将关键信息上传云端,从而降低带宽成本并提升响应速度。
实时流式聚类
传统批量处理模式已无法满足实时性要求,流式分布式聚类算法能够持续接收数据流,动态更新簇结构,适用于实时监控、欺诈检测等场景。
常见问题解答
分布式聚类的价格成本如何评估?
分布式聚类的成本主要由计算资源、存储资源和网络带宽组成,初期投入包括集群搭建与软件授权,后期运维成本则取决于数据规模与处理频率,相比单机方案,分布式方案在数据量超过TB级时具有明显的规模经济优势,但需考虑数据一致性带来的额外开销。
分布式聚类与单机聚类在精度上有何差异?
在理想情况下,分布式聚类应能复现单机聚类的结果,由于数据分片、近似算法及迭代收敛条件的差异,分布式结果可能存在微小偏差,对于大多数应用场景,这种偏差在可接受范围内;对于高精度要求的场景,需采用更精细的分片策略或增加迭代次数。
如何选择合适的分布式聚类框架?
选择框架时需考虑数据规模、实时性要求及团队技术栈,对于大规模离线批处理,Spark MLlib是成熟选择;对于实时流处理,Flink或Storm更为合适;若需灵活定制算法,可基于Hadoop MapReduce或自研分布式系统开发。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/473835.html