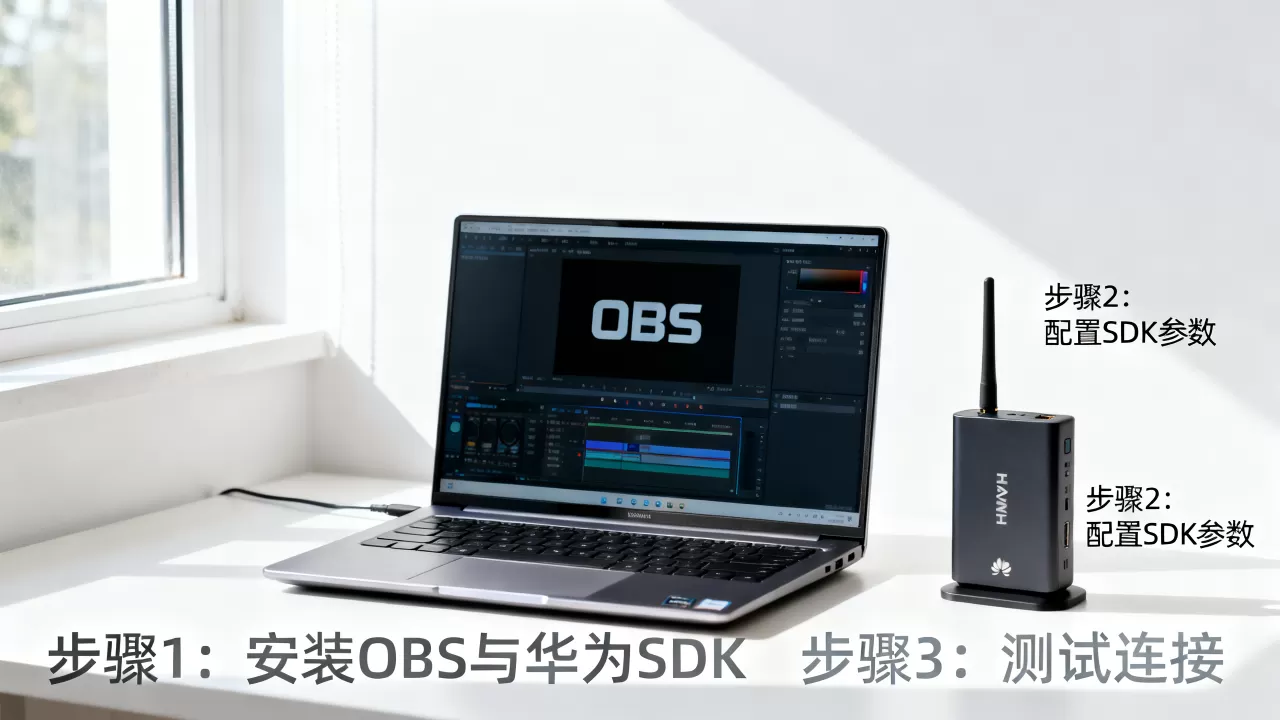
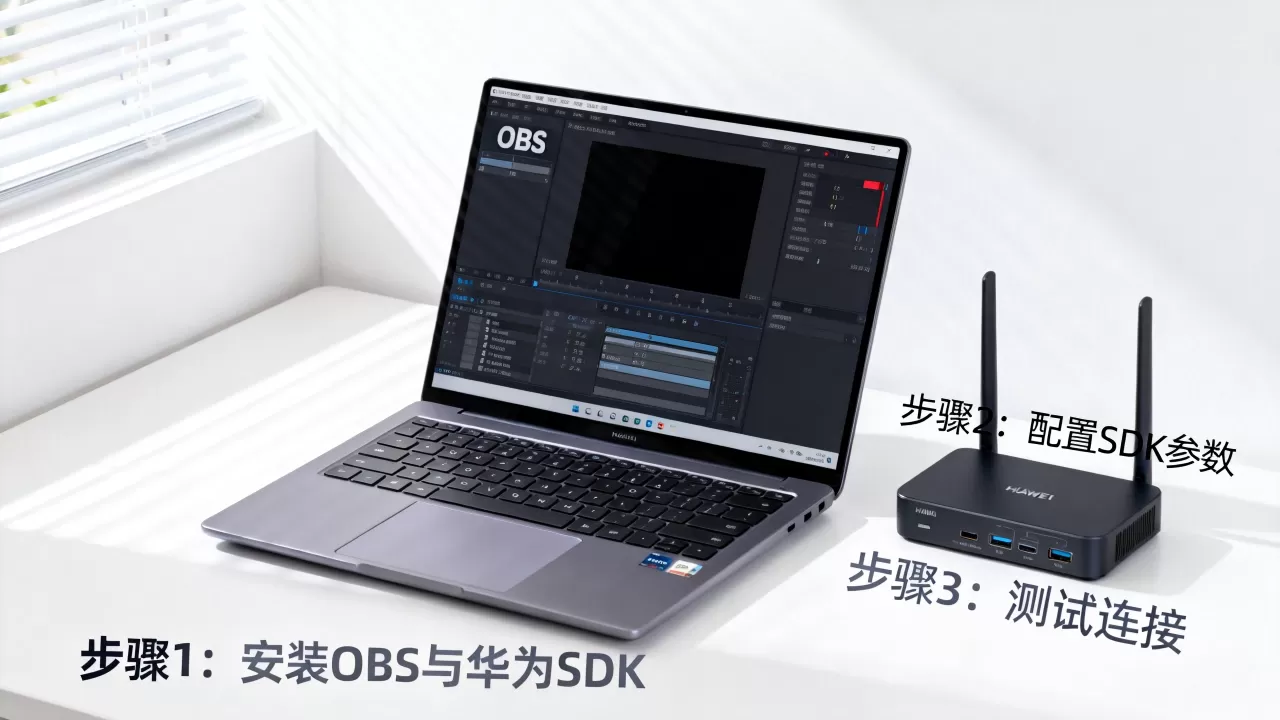
华为SDK通过OBS接入,本质就是把推送业务涉及的回执数据、资源文件托管在华为云OBS桶中,再在SDK配置里完成桶的鉴权与读写参数对接,整个过程大约需要半小时。 这个说法不是官方定义,但把它理解成“让推送消息学会找文件、存文件”也没问题,今天这篇内容,就是把华为SDK接入文档里和OBS相关的部分,掰开揉碎讲清楚。
为什么要走OBS而不是直接在服务器上读写
先聊一个不算问题的问题:为什么不把推送回执放在自己的服务器上?
早年做推送服务,回执都是往自己后端拉,可随着终端量上来,回执文件越来越占地方,开发还得自己处理扩容、备份、防盗刷。华为推送服务给出的方案是:回执数据先写入OBS桶,开发者再从桶里面拉取。 这样做最大的好处是解耦推送服务专心投递消息,你的服务器专心读数据,中间那层存储交给对象存储来扛。
从成本角度讲,OBS的存储费用比自建分布式文件系统低不少,尤其是当消息量处于波峰波谷明显的业务里,按量付费的OBS能省下很大一笔闲置资源开销。华为推送SDK接入文档里明确指出,OBS接入方式支持自定义目录前缀,你可以按业务类型去隔离回执文件,这比全量拉回来再在本地过滤要省事得多。
OBS接入到底解决什么问题
- 回执数据落盘:推送送达、点击、展示等回调数据,由华为推送服务写入OBS,生成文件清单。
- 批量拉取:SDK侧通过OBS客户端连接桶,按批次读取文件,不再依赖逐条推送的HTTP回调。
- 长期归档:桶内文件可配置生命周期策略,自动转存到低频访问存储或归档存储。
华为推送SDK接入文档里OBS配置步骤
整个接入过程分两个阶段:控制台侧配置和工程侧代码配置,两个阶段各管一段,搞混了就会出现“SDK报错但控制台显示正常”的情况。
控制台侧:开通OBS并创建桶
这一步不需要写代码,但出错率最高。
- 登录华为云控制台,进入对象存储服务OBS主页,确认你的账号已完成实名认证。
- 创建桶的时候,区域选择要和后续调用SDK的服务区域保持一致,你的App主要跑在国内用户设备上,就选择华北-北京四或华东-上海一这类国内节点;如果业务同时覆盖海外市场,还需要单独评估是否需要创建多区域的桶。
- 桶的存储类别默认选“标准存储”即可,不必为回执数据一上来就选低频或归档,因为推送回执需要频繁读写,等数据过了活跃期,再通过生命周期规则转冷。
- 桶策略这一步,官方文档推荐通过“账号间授予”方式给你的推送服务账号授权,直接把桶设成公共读写是安全红线,
业内专家指出,对象存储的安全事故多数源于桶策略配置过于宽松
,建议最少权限原则,只给推送服务账号读和写的权限,不给公共访问权限。
工程侧:SDK拉取回执文件并解析
控制台那边配好之后,回到Android或服务端工程里,核心逻辑是“连桶、列文件、读对象、删旧档”,华为SDK接入文档给出的步骤大致如下:
- 引入OBS SDK依赖,目前华为推送SDK已经封装了OBS客户端的初始化方法,不需要你再单独写一套连接OBS的底层逻辑。
- 在配置类里声明
endpoint、ak、sk、bucketName四个关键参数,其中endpoint是OBS服务的区域节点域名,不带bucketName,这个容易被新手配错。 - 初始化OBS客户端,设置
maxConnections和socketTimeout,回执文件通常体积不大,但文件数量多,连接池太小的话,批量拉取时会频繁等待。 - 业务侧启动一个定时任务,例如每5分钟执行一次
listObjects获取桶内文件列表,按文件名前缀过滤出回执文件后,逐条读取并解析消息体。
这里有一个容易被忽略的点:华为推送服务写入OBS的回执文件格式是JSONL,即每一行是一个独立JSON对象。 你在解析时,不要用JSONArray整体解析,按行读取再逐行转换,才是正确的姿势。
| 配置项 | 作用 | 常见错误 |
|---|---|---|
| endpoint | OBS区域节点域名 | 带上桶名或加错前缀 |
| ak/sk | 访问密钥,具备OBS读写权限 | 用了子账号但不给OBS策略 |
| bucketName | 存放回执文件的桶名 | 写错字符或桶名大小写不匹配 |
| maxConnections | 连接池上限 | 设置过小导致拉取超时 |
华为推送OBS接入时常见问题怎么排查
配置步骤看完了,接下来是大家最关心的环节出了问题怎么办,下面这些问题大概率能覆盖你遇到的大部分情况,按顺序排查就行。
报错“AccessDenied”且桶权限没问题
这个问题非常诡异,控制台里桶权限明明放开了,SDK就是报403,先检查一下你是否用了子账号的AK/SK,子账号默认不继承主账号的OBS权限,需要在IAM里单独给这个子账号绑定OBS OperateOnly策略,如果权限策略挂的是OBS ReadOnlyAccess,那只能读不能写,同样会出现权限错误。
文件已经入桶了但SDK拉取不到
这种现象一般是文件名前缀过滤条件太严格,你在代码里写的是push/2026/,但实际回执文件生成路径是push_data/2026/,一个字符的差异就会导致列表为空,建议在控制台上打开该桶的“对象”标签页,实际看一眼生成的文件路径,再回头改代码里的前缀。
OBS和推送SDK不在同一个区域导致延迟高
如果你的推送业务跑在“华北-北京四”,但OBS桶建在“华东-上海一”,跨区域访问会产生额外延迟,拉取回执可能会慢上几百毫秒,华为官方文档建议OBS桶和推送服务保持在同一个区域,跨区域不是不能跑,但是公网流量的费用会略有增加,延迟也会变,所以预算敏感或对回执时效要求高的业务,最好统一区域。
生命周期规则把回执文件删得太早
这个属于配置层面的坑,你在OBS桶上设置了生命周期规则,30天后转为归档存储”,但如果桶里同时还有推送回执文件,且你的业务拉取周期是15天一次,那没问题;如果拉取周期是45天一次,归档存储的文件就读取不到了,归档存储文件需要先恢复(取回)才能读取,这期间还涉及等待时间,行业共识认为,回执类数据的保存周期至少要比业务拉取周期长一周以上,最好留出两倍的缓冲。
华为推送OBS接入时选地域节点的考虑
很多开发者问,地域节点(Region)怎么选,是不是选最近的就行?
不完全是,华为推送SDK接入OBS时,地域节点的作用范围主要在“回执数据生成-存储-拉取”这条链路里。如果你的用户群体集中在中国大陆,直接把OBS桶建在华为云国内节点即可,比如华南-广州、华东-上海、华北-北京这几个大区,桶区域离推送服务区域越近,跨区公网流量费用越低,拉取速度也越稳定。
如果业务本身是出海应用,那就得结合华为推送服务在海外的可用区来规划,作为参考,华为云在亚太、拉美、非洲、中东等地都有可用区,跨洲拉取回执的体验会比较糟糕,建议在目标市场就近创建桶。
另外关于费用,OBS的账单分存储费、请求费、流量费三块,华南-广州和华北-北京的定价基本一致,但公网流出流量单价比内网要高,所以生产环境一定走内网endpoint,华为云管理控制台里,OBS桶的详情页会明确标注“内网访问域名”和“公网访问域名”,SDK里填的是内网那个。
华为SDK通过OBS接入后如何验证结果
配置完成后不要直接上线,先在测试环境跑通一次全流程,验证方法很直接:用测试设备触发一条推送消息,等两分钟,然后看OBS桶的“对象”列表,应该能看到新增的回执文件,文件内容里会有
eventType和msgId字段,用来区分事件类型和消息ID。
然后用SDK代码执行一次拉取,断点看返回的文件列表是否和桶内文件一致,如果拉取回来的文件数量和桶内的对不上,优先检查listObjects的maxKeys参数,默认只返回1000个对象,文件多的时候需要分页拉取,华为SDK接入文档里封装了listObjects的分页迭代器,建议直接使用。
华为推送SDK接入(OBS方式)与其他方式对比
很多开发者在选接入方式时会有疑问:OBS接入和“普通回调”有什么差别?这里做一个简单对比:
| 对比项 | OBS接入 | HTTP/HTTPS回调 |
|---|---|---|
| 数据可靠性 | 高,OBS本身有冗余机制 | 依赖回调服务器稳定性 |
| 数据量承载 | 大,文件方式批量拉取 | 小,并发高时容易丢 |
| 实时性 | 延迟分钟级 | 秒级 |
| 运维成本 | 低,不需要自己维护存储 | 高,需要处理回调重试与积压 |
| 适用场景 | 需要长期存储和分析推送效果的运营团队 | 只做实时触发、不常分析数据的业务 |
多数情况下,如果推送量日均超过几十万条,OBS接入是更省心的选项,回调方式虽然实时性更好,但高并发下的回调堆积问题会持续消耗后端精力。
常见问题解答
华为推送OBS接入时桶内文件越来越多,需不需要手动删除?
不需要手动删除,在OBS控制台为该桶配置生命周期规则,文件生成45天后自动删除”,系统会自动清理,需要注意的是,规则生效有延迟,不是立刻执行,文件生命周期从“最后修改时间”起算,不是从生成时间起算。
OBS接入和直接存储到手机本地有什么区别?
本质上是数据归属地的区别,OBS存储的是服务端产生的回执数据,手机本地存的是App运行时的业务数据,两者没有互斥关系,推送回执属于服务端业务数据,放到OBS是为了让服务端去消费;手机本地存储不涉及回执数据,直接存手机本地既拿不到回执,也没有必要。
华为推送SDK接入文档里提到的“临时AK/SK”是什么?
临时AK/SK是通过华为云STS服务颁发的短期凭证,有效期默认15分钟到1小时,适用于需要临时读写OBS但不希望长期维护密钥的场景,SDK内可以直接配置临时凭证的获取逻辑,凭证过期后SDK会自动刷新,长期运行的业务推荐使用永久AK/SK加子账号权限隔离的组合,临时凭证更多用于函数计算或临时任务中。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/590028.html