

大模型训练选用NVLINK并非单纯为了提升带宽,而是为了解决千卡互联时的通信瓶颈,确保算力线性扩展,避免GPU因等待数据而闲置。
在2026年的今天,构建万亿参数级别的大语言模型(LLM)已成为科技巨头的标配,许多团队在初期往往陷入一个误区:认为只要购买足够多的顶级GPU,模型就能自动高效训练,事实恰恰相反,当集群规模从几十卡扩展到数千卡时,GPU之间的通信效率成为了决定训练成败的关键,NVLINK技术正是为了解决这一痛点而生,它不仅是硬件连接方式,更是打破“算力孤岛”的核心基础设施。
为什么传统网络无法支撑大规模训练
在深入NVLINK之前,我们需要理解传统网络架构在大模型训练中的局限性,大模型训练的核心是反向传播算法,这要求所有GPU在每一步计算中同步梯度数据。
通信延迟导致的算力浪费
如果使用传统的以太网或普通InfiniBand网络进行多机多卡互联,数据需要在GPU、网卡、交换机之间多次跳转,业内专家指出,这种跳转带来的延迟在千卡集群中会被指数级放大。
- 带宽瓶颈:传统网络带宽通常只有几十Gbps,而单卡显存带宽可达TB级别。
- 同步等待:当部分GPU计算较快,而另一部分因网络拥堵还在传输数据时,快的那部分GPU必须空闲等待。
- 线性扩展失效:理想情况下,增加10倍GPU应带来接近10倍的训练速度提升,但在通信受限的情况下,加速比往往远低于预期,甚至出现边际效应递减。
显存墙与通信墙的夹击
大模型训练面临两大挑战:显存容量不足和通信开销过大,NVLINK通过提供极高的片间带宽,直接缓解了通信墙的问题,让数据在GPU之间流动的速度接近显存内部读写速度,从而最大化硬件利用率。
NVLINK如何重塑训练架构
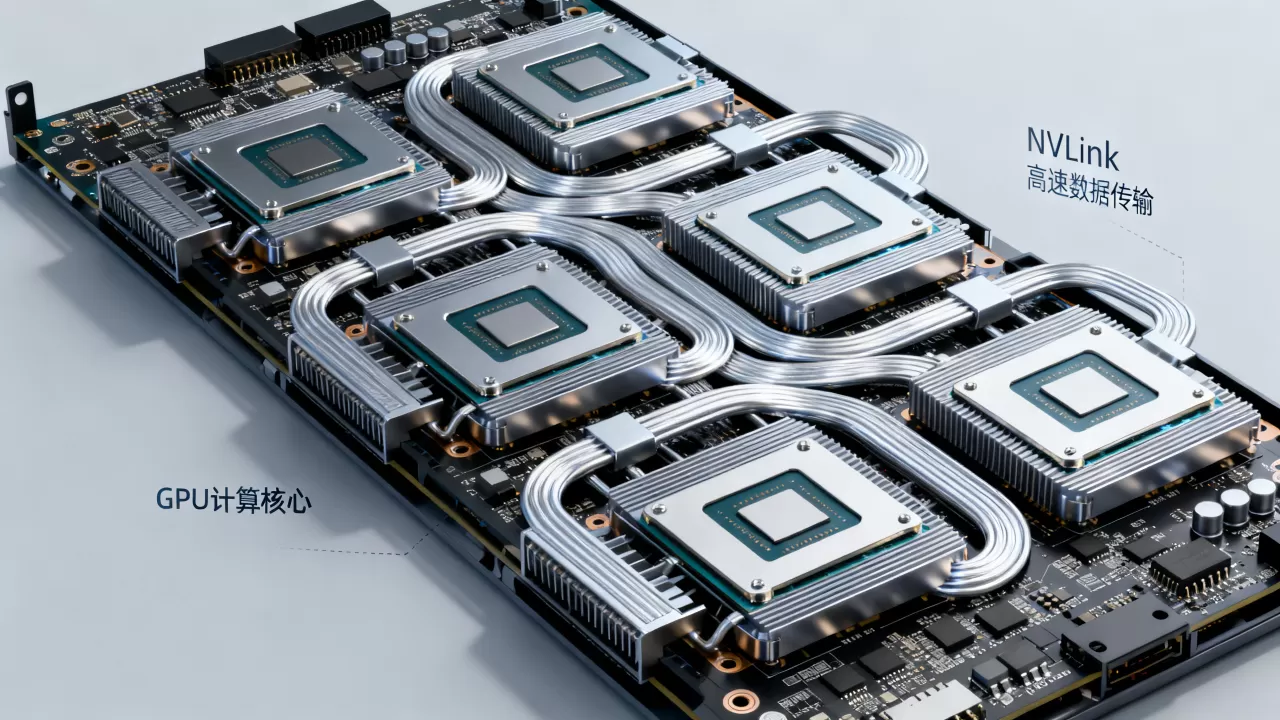
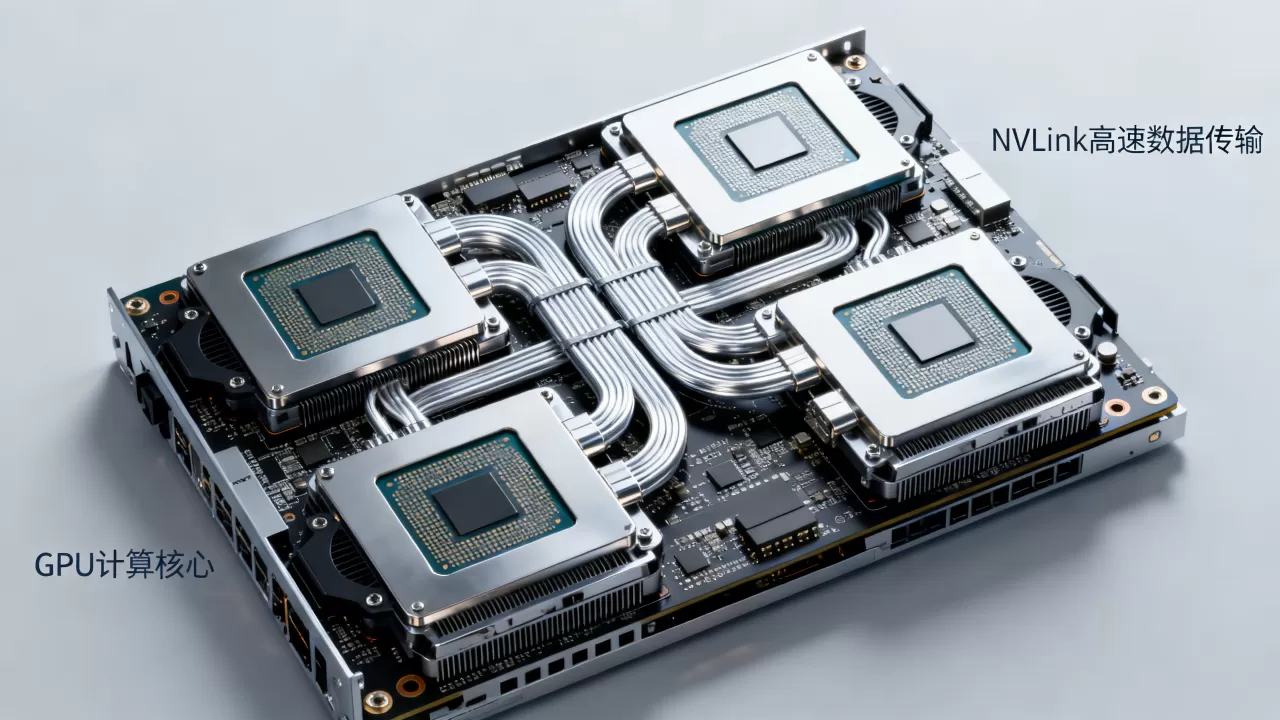
NVLINK不仅仅是一个高速接口,它是一种系统级互联解决方案,在2026年的主流训练集群中,NVLINK通常与NVSwitch结合使用,构建起一个无阻塞的高带宽网状拓扑结构。
极高的带宽与低延迟
NVLINK的核心优势在于其惊人的带宽密度,以最新一代架构为例,单条NVLINK链路带宽可达数百GB/s,而整个NVSwitch交换矩阵可提供TB级别的聚合带宽。
- 点对点直连:GPU之间无需经过CPU或外部网卡,直接通过NVLINK交换数据。
- 纳秒级延迟:相比传统网络微秒级甚至毫秒级的延迟,NVLINK将通信延迟压缩至极低水平。
- 一致性内存访问:支持多GPU共享同一地址空间,简化了编程模型,降低了开发复杂度。
支持大规模集群线性扩展
对于训练万亿参数模型,单一节点(如8卡或16卡)的显存和算力远远不够,NVLINK使得多个节点可以像单个超级GPU一样工作。
- 节点内互联:通过NVSwitch,节点内的所有GPU实现全互联,带宽饱和。
- 节点间互联:不同节点之间通过高速NVLINK链路或优化后的InfiniBand网络互联,保持整体通信效率。
- 无缝扩展:随着集群规模扩大,通信开销占比保持稳定,确保算力线性增长。
实际应用场景与部署建议
在实际部署中,如何最大化NVLINK的价值,需要具体的实操策略,以下是针对2026年主流训练场景的建议。
分布式训练框架优化
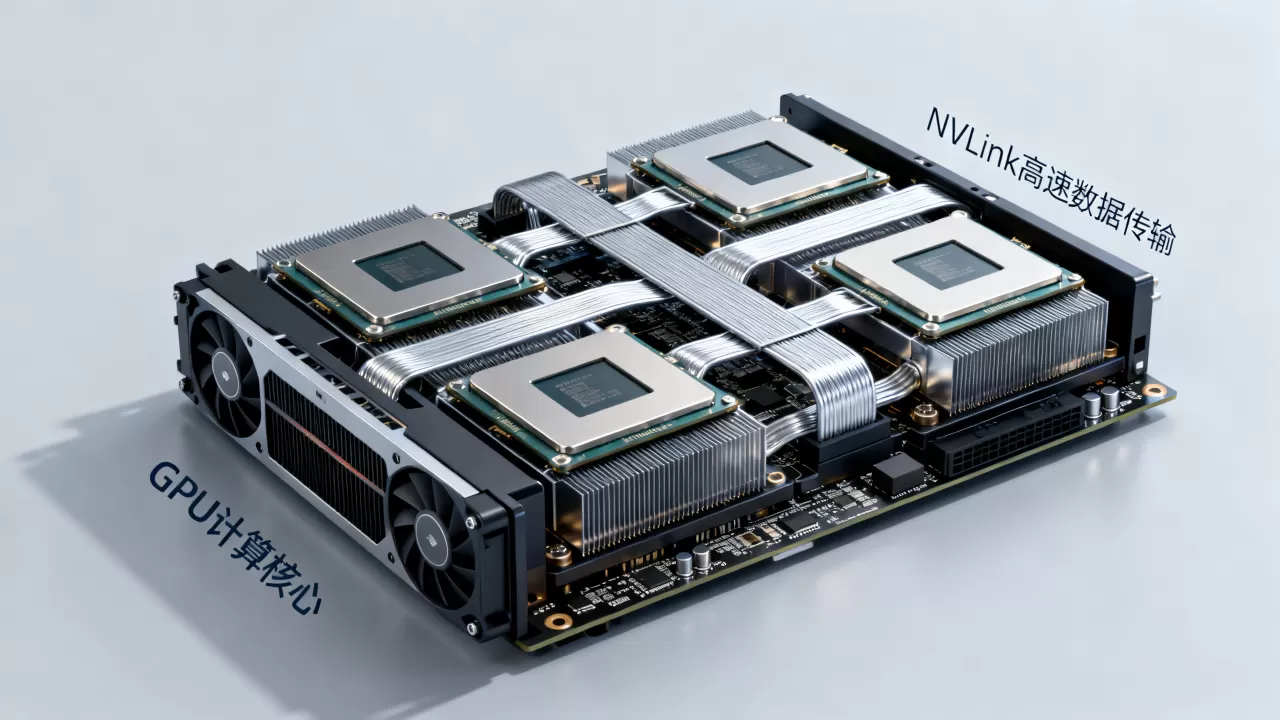
选择合适的分布式训练框架至关重要,PyTorch的DistributedDataParallel(DDP)或DeepSpeed等框架需要针对NVLINK特性进行优化。
- 梯度压缩:尽管NVLINK带宽高,但在超大规模集群中,梯度数据量依然巨大,采用梯度压缩技术可以减少传输数据量。
- 重叠通信与计算:配置框架使数据通信与矩阵计算并行执行,隐藏通信延迟。
- 拓扑感知调度:利用NVLINK拓扑信息,将通信频繁的GPU调度到同一节点或高速互联节点。
硬件选型与成本考量
在规划集群时,除了GPU本身,NVLINK相关组件的成本也不容忽视。
| 组件 | 作用 | 重要性 | 成本占比 |
|---|---|---|---|
| NVSwitch | 节点内全互联交换 | 极高 | 中等 |
| NVLINK线缆 | 高速数据传输介质 | 极高 | 较低 |
| 高速网卡 | 节点间互联 | 高 | 中等 |
| 电源与散热 | 支撑高密度计算 | 极高 | 高 |
据统计,NVLINK相关硬件在高端训练集群中的成本占比约为15%-20%,但这部分投入能显著提升整体训练效率,缩短模型迭代周期,从长期看具有极高的投资回报率。
常见误区与避坑指南
许多团队在引入NVLINK时容易陷入一些误区,导致效果不如预期。
NVLINK可以替代所有网络
NVLINK主要解决节点内和短距离节点间的高速互联,对于超大规模集群,节点间远距离传输仍依赖InfiniBand或RoCE网络,NVLINK与InfiniBand是互补关系,而非替代关系。
只要上了NVLINK,训练速度就自动翻倍
硬件只是基础,软件栈的优化同样关键,如果模型并行策略不合理,或者代码中存在串行瓶颈,NVLINK的高带宽将无法被充分利用,需要定期进行性能剖析(Profiling),定位通信瓶颈。
忽视散热与电源规划
NVLINK高密度互联意味着更高的功耗和发热量,在部署时,必须确保机柜的散热能力和电源供应充足,否则可能导致硬件降频,反而影响性能。
Q&A:关于NVLINK训练的核心疑问
大模型训练为什么要用NVLINK
NVLINK提供远高于传统网络的片间带宽和极低延迟,确保多GPU并行训练时数据同步效率,避免算力闲置,实现算力线性扩展。
NVLINK与InfiniBand在大模型训练中有什么区别
NVLINK主要用于GPU间短距离、超高带宽互联,解决节点内通信瓶颈;InfiniBand主要用于节点间长距离互联,解决集群规模扩展问题,两者结合使用才能构建高效的大规模训练集群。
中小团队是否值得投入NVLINK集群
对于参数量在百亿以下的小模型,传统网络可能足够,但对于千亿及以上参数的大模型,NVLINK几乎是必需品,否则训练时间将延长数倍,且资源利用率极低。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/411759.html

评论列表(1条)
码住!千卡互联这痛点太真实了,之前见朋友跑训练光等数据等到心态崩。先收藏后看,Mark一下。