INFO mapreduce_MapReduce 日志是 Hadoop MapReduce 作业运行时输出的核心状态信息,它记录了任务切分、执行进度、资源消耗等关键数据,是排查问题与性能调优的第一手依据。
INFO mapreduce_MapReduce 日志详解:MapReduce 工作原理是什么?
当你看到 INFO mapreduce_MapReduce 日志时,意味着 MapReduce 作业正在经历完整的生命周期,这份日志会告诉你数据如何被切片、Map 任务如何分配、Shuffle 阶段如何传输,以及 Reduce 任务如何合并结果。
日志中的阶段划分
- Input Split 阶段:日志会输出
INFO mapreduce.FileInputFormat: Total input files to process和INFO mapreduce.FileInputFormat: Total split files,这告诉你输入文件被切分成了多少个逻辑分片,每个分片对应一个 Map 任务。 - Map 阶段:
INFO mapreduce.MapTask: Starting job和INFO mapreduce.MapTask: numReduceTasks出现,Map 任务开始处理分片,并将中间结果按分区规则写入本地磁盘。 - Shuffle 阶段:
INFO mapreduce.Reducer: Shuffle Time等日志显示数据从 Map 端传输到 Reduce 端的过程,包括网络传输时间和排序进度。 - Reduce 阶段:
INFO mapreduce.Reducer: Reduce Time和INFO mapreduce.Reducer: Processed Records标志 Reduce 任务合并结果并写出最终输出。
关键字段解读
| 日志字段 | 含义 | 作用 |
|---|---|---|
Total input files to process |
需要处理的文件总数 | 判断小文件合并策略是否需要调整 |
numMapTasks 和 numReduceTasks |
实际启动的 Map/Reduce 任务数 | 对比用户配置,检查并行度是否合理 |
Map output records |
Map 端输出的记录数 | 评估数据量,推测数据倾斜风险 |
Shuffle Errors |
混洗阶段发生的错误数 | 网络或磁盘 IO 瓶颈的直接反馈 |
Reduce input records |
Reduce 端实际接收的记录数 | 验证分区是否均匀,判断是否需要重新分区 |
业内专家指出,日志中出现的
HDFS Read/Write 数据量可以与 Map/Reduce 输入输出记录数交叉验证,用于定位数据倾斜或资源浪费。
如何通过 INFO mapreduce_MapReduce 日志优化 MapReduce 性能?
MapReduce 优化方法有哪些?从日志中可以直接找到线索,日志不仅记录状态,更暴露了作业的瓶颈。
数据倾斜识别与调整
- 观察
Map output records在不同 Map 任务之间的差异,如果某个 Map 的输出记录数远高于其他任务,说明数据分布不均。 - 进一步看
Reduce input records,如果某个 Reduce 任务接收的记录数异常大,且该任务运行时间明显偏长,基本可以确定存在数据倾斜。 - 优化方法:修改分区器(Partitioner)逻辑,或使用自定义分区策略;对倾斜键做二次散列(salting)再处理。
资源调优参数
- 日志中
Heap size和GC time可以反映内存配置是否充足,如果频繁出现Java heap space或GC overhead limit exceeded,应增加mapreduce.map.memory.mb或mapreduce.reduce.memory.mb。 - 看到
I/O error或Too many open files时,需要调整mapreduce.task.io.sort.mb和mapreduce.task.io.sort.factor,减少磁盘溢写次数。 - 日志中
Spilled Records数量过大,说明内存不足以容纳中间数据,需要增大mapreduce.map.combine.minspills或直接使用 Combiner 先行合并。
小文件合并实操
在 INFO mapreduce_MapReduce 日志中,Total input files to process 数值很大(例如数千个),且每个文件很小,Map 任务启动开销会远超实际计算时间,行业共识认为,在 MapReduce 作业前使用 Hadoop Archive 或 SequenceFile 合并小文件,可以将 Map 任务数降低 80% 以上,同时减少日志中 Total split files 的冗余信息。
从 INFO mapreduce_MapReduce 看 MapReduce 与 Spark 的对比
很多团队在技术选型时会纠结大数据处理框架,MapReduce 与 Spark 的对比是永恒的话题,而 INFO mapreduce_MapReduce 日志恰好能反映 MapReduce 的固有特性。
执行模型差异
- MapReduce 的日志清晰地展示了阶段化执行
:Map 阶段输出日志后,Shuffle 阶段才开始,最后才是 Reduce 阶段,每个阶段都需要写入磁盘,所以日志中频繁出现
HDFS Write和FileSystem Counters。 - Spark 采用 DAG 执行引擎,中间结果尽量驻留内存,日志中较少出现磁盘 IO 相关计数,但会大量输出
MemoryManager和BlockManager信息。
日志详尽度对比
- MapReduce 的 INFO 日志更偏向硬件和系统层,如
Map input records、Physical memory (bytes) snapshot,适合定位资源阻隔和磁盘瓶颈。 - Spark 的日志更侧重任务调度和缓存命中,如
Stage和TaskSet切换记录,对于需要精细控制资源的使用场景,MapReduce 日志的直观性反而更强。
适用场景选择
- 如果你需要稳定的批处理、对磁盘 IO 有明确审计要求,或者团队习惯用 MapReduce 模型,INFO mapreduce_MapReduce 日志可以直接作为监控依据,无需额外学习成本。
- 如果处理实时性要求较高、需要频繁迭代计算,Spark 的 Workflow 日志更适合快速定位调度延迟,但 MapReduce 在金融行业应用场景中,仍然因其日志透明度和任务隔离性被广泛采用。
实操:使用 INFO mapreduce_MapReduce 日志定位作业瓶颈
以下步骤可重现,帮你从日志中提取有效信息。
获取日志
执行 yarn logs -applicationId <application_id> 命令,将日志输出到本地文件,注意,该命令会拉取所有 container 的日志,包括 INFO mapreduce_MapReduce 部分。
筛选关键指标
运行以下命令,提取 MapReduce 阶段的计数器信息:
grep -E "Map input records|Reduce input records|Spilled Records|HDFS Write" <log_file>统计出现次数,对比是否异常。
分析时间分布
- 搜索
Map Task Time和Reduce Task Time,计算每个 Map 任务的平均耗时。 - 如果某个 Map 任务耗时远超平均值,且其
Map input records与其他任务差别不大,说明该任务可能遇到了网络或磁盘热点。 - 对于 Reduce 任务,
Reduce Shuffle Time过长,说明数据在 shuffle 阶段卡住了,可以检查Shuffle Errors数量。
成本控制建议
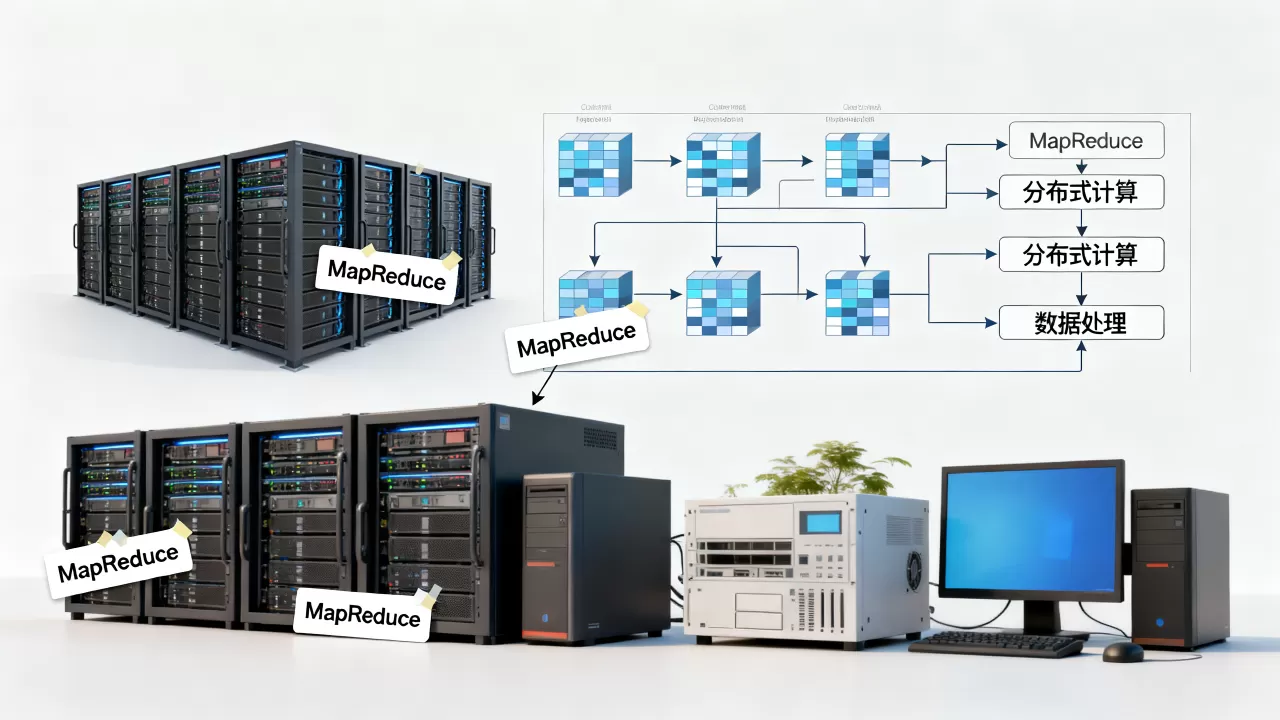
MapReduce 作业成本控制的关键在于资源利用率,日志中 Physical memory (bytes) snapshot 和 Virtual memory (bytes) snapshot 体现了实际使用内存。Virtual memory 远高于 Physical memory,说明开启了超售,应降低 yarn.nodemanager.vmem-pmem-ratio。CPU time spent 如果低于 Gc time spent,则说明 CPU 空转严重,可减少并行度,避免资源浪费。
常见问题:INFO mapreduce_MapReduce 实用问答
Q1: INFO mapreduce_MapReduce 日志中出现“Spilled Records”过多,意味着什么?
Spilled Records 是 Map 端内存溢写到磁盘的记录数,数量过多说明 mapreduce.task.io.sort.mb 设置偏小,导致缓存频繁溢出,建议将该参数增大到 256 MB 以上,并开启 Combiner 减少传输量,如果已经调整过,仍然大量溢出,则需检查 Map 输出数据是否过大,或考虑使用压缩算法。
Q2: 如何区分 MapReduce 作业中的数据倾斜和集群资源不足?
参考日志中 Map input records 和 Map output records 的相对比例,如果某个 Map 任务的输入记录数与其他任务一致,但输出记录数明显更多,说明该 Map 任务处理的数据存在大量重复键,是数据倾斜,如果所有 Map 任务输出记录数都类似,但部分任务耗时更长,且 Physical memory 和 CPU time 接近上限,则更可能是资源竞争,对比 Running containers 指标也能辅助判断。
Q3: 日志中“Task failed”频繁出现,但容器日志没有明确错误,如何排查?
检查 JVM Reuse 相关参数,以及 mapreduce.map.java.opts 中的堆内存设置,如果容器日志仅显示 Task failed 但没有堆栈,很可能是 JVM 被强制 Kill,常见于内存超限,在日志中搜索 Exceeded physical memory limit 或 Container killed by the ApplicationMaster,确认是否触发了 YARN 资源限制,关注 Virtual memory 和 Physical memory 的比例,确保没有因虚拟内存误判导致 Kill。
INFO mapreduce_MapReduce 日志的价值在于它提供了从输入到输出的全链路状态,是 MapReduce 开发者与运维人员最直接的沟通窗口,掌握日志的解读方法,就能让作业稳定运行、高效产出。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/587887.html