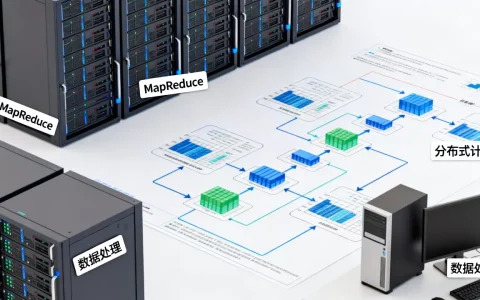
ItemCF在MapReduce框架下的实现,是通过分阶段MapReduce任务完成物品相似度计算和推荐生成,是离线推荐系统的经典方案。
ItemCF MapReduce 实现原理详解
ItemCF(基于物品的协同过滤)的核心思想是根据用户历史行为计算物品间的相似度,然后为用户推荐与其历史物品相似的物品,在MapReduce下,这一过程被拆解为多个串行的MapReduce作业,每个作业处理特定的计算阶段。
ItemCF算法核心步骤
- 构建用户物品矩阵:将原始行为日志转化为用户对物品的评分或行为记录,格式为<用户ID,物品ID,行为权重>。
- 计算物品共现矩阵:统计每对物品被同一用户同时行为的次数,得到共现矩阵。
- 计算物品相似度:基于共现矩阵,使用余弦相似度或Jaccard相似度等公式,对每个物品与其共现物品计算相似度。
- 生成推荐结果:对每个用户的活跃物品,查找相似度最高的TopN物品,加权聚合后推荐给用户。
MapReduce任务划分与数据流
在MapReduce离线实现中,通常包含三个主要作业:
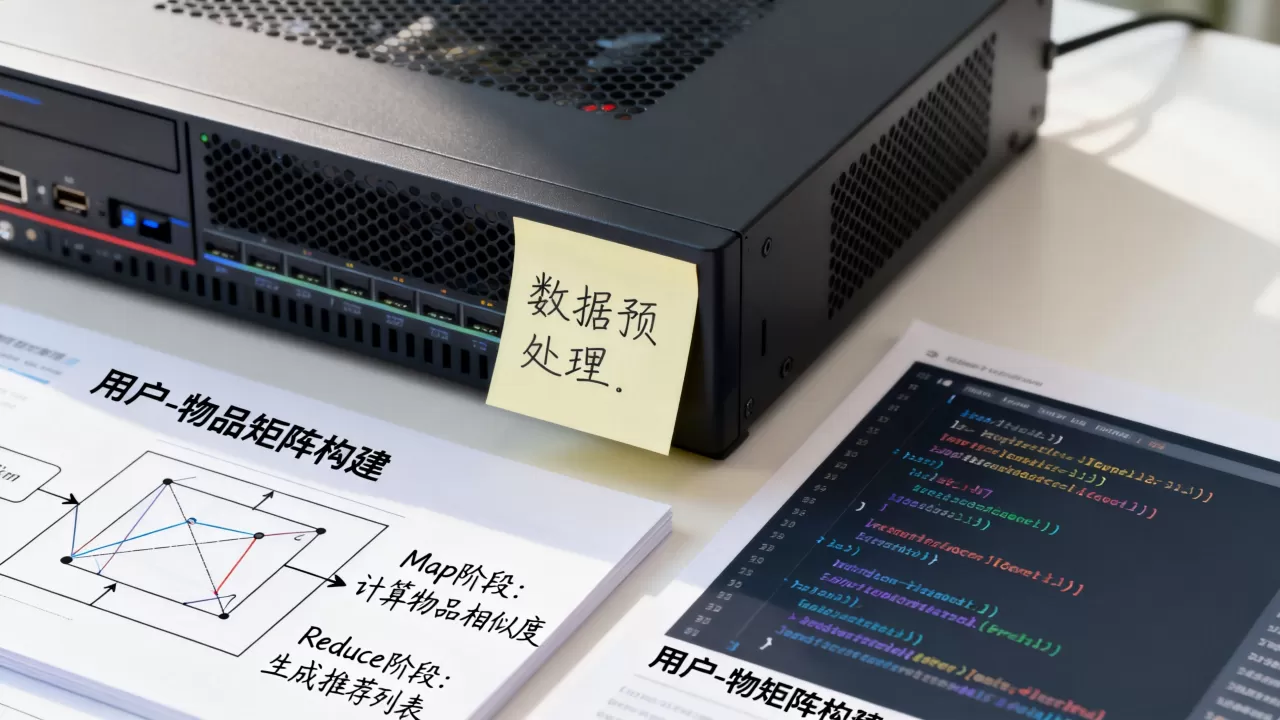
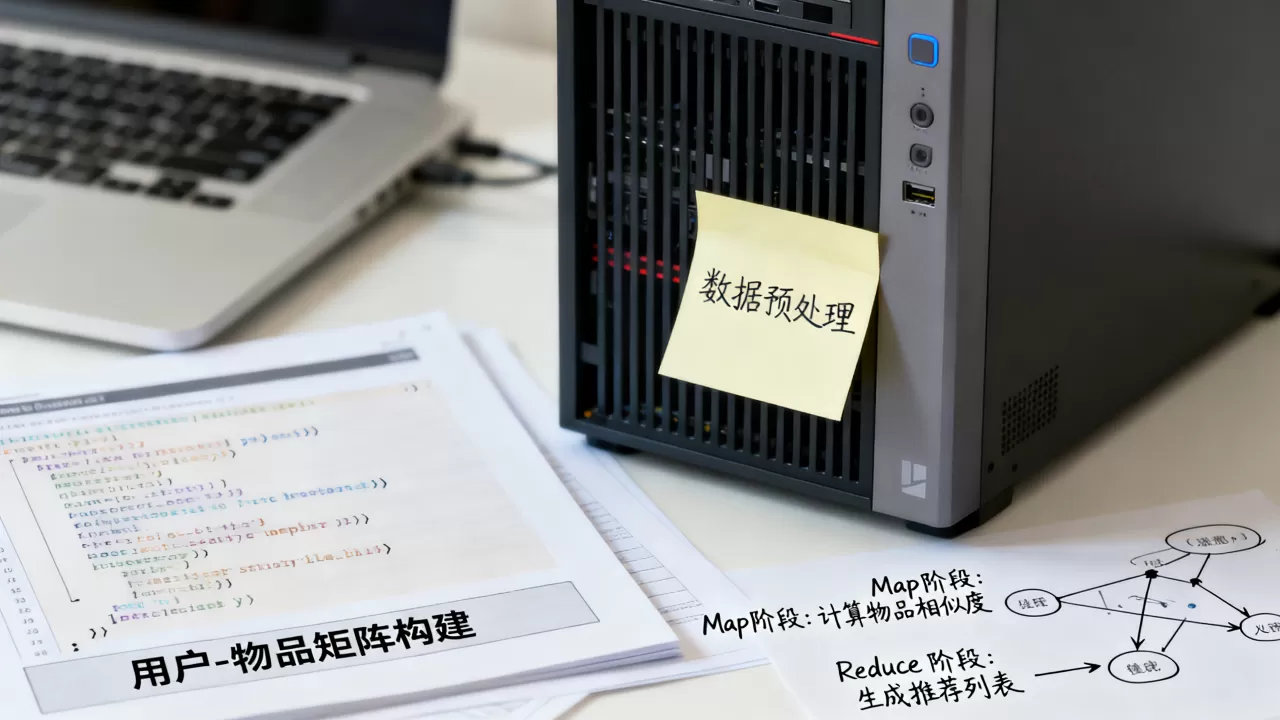
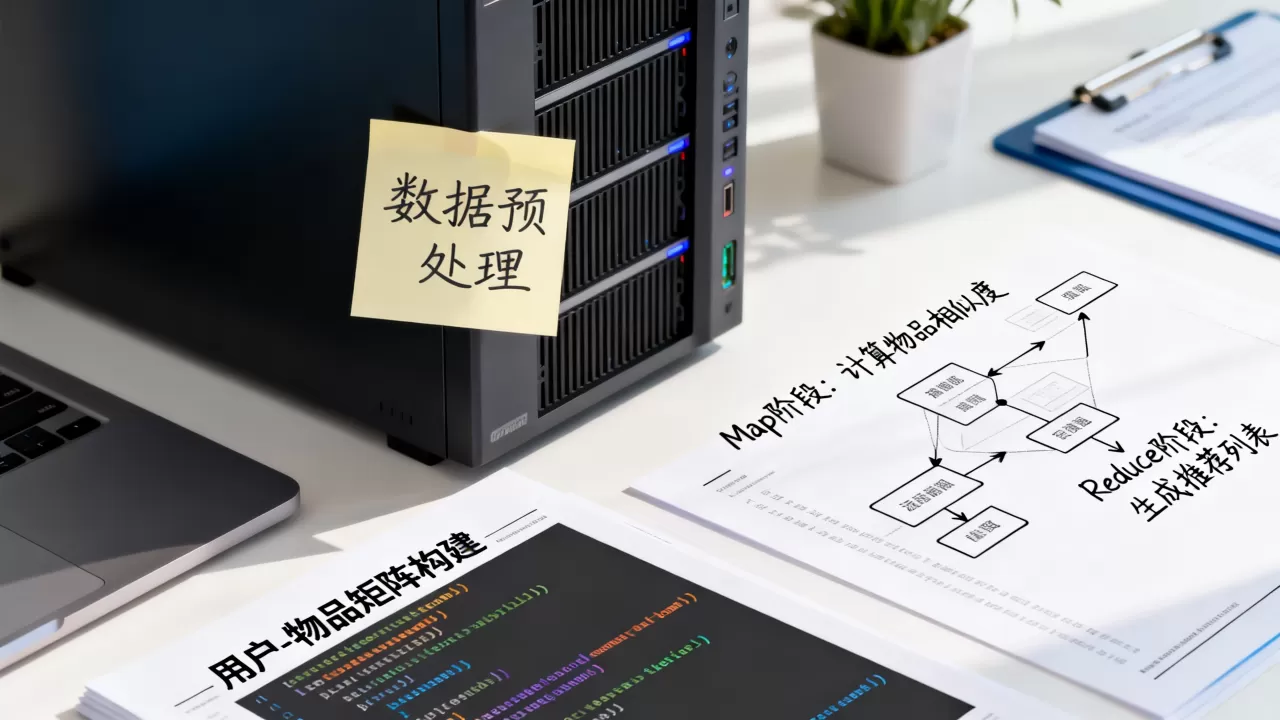
- 用户行为数据预处理,将原始日志清洗、去重,输出<用户ID,物品ID,行为权重>,Map阶段解析日志,Reduce阶段按用户和物品聚合权重。
- 物品共现矩阵计算,将同一用户下的物品两两组合,输出<物品ID1,物品ID2,1>,Map阶段按用户ID分组,输出所有物品对;Reduce阶段统计每个物品对的共现次数。
- 相似度计算与推荐生成,读入共现矩阵和物品总权重,计算相似度并排序输出推荐列表,Map阶段以共现矩阵为输入,结合物品总权重计算相似度;Reduce阶段按物品ID聚合,输出TopN相似物品,并进一步生成用户推荐结果。
关键优化点:在作业二中,使用Combiner
对同一用户的物品对进行局部聚合,大幅减少数据传输量。设置合理的分区函数,将物品对均匀分配到Reduce节点,避免数据倾斜。
ItemCF MapReduce 实战代码示例
下面以Hadoop MapReduce为例,给出三个作业的简化实现思路,实际生产环境需根据数据量调整资源参数。
环境搭建与数据准备
- 集群环境:Hadoop 2.x或3.x,推荐使用YARN管理资源。
- 数据格式:假设用户行为日志为文本文件,每行格式为
user_id,item_id,action(如purchase、click),权重可预定义。 - 存储路径:输入数据存放在HDFS的
/input/behavior,中间结果和最终输出存储在/tmp/itemcf下。
MapReduce作业编写
用户物品矩阵
- Mapper:解析每行,输出
<user_id, item_id>。 - Reducer:按用户ID聚合,输出
<user_id, item_list>,item_list为JSON或分隔符拼接的字符串。
物品共现矩阵
- Mapper:读入作业一输出,对每个用户的所有物品进行两两组合,输出
<item_pair, 1>,其中item_pair为item1,item2(按字典序排序)。 - Reducer:对相同item_pair求和,输出
<item_pair, count>。
相似度计算与推荐
- Mapper:读入作业二输出,同时读入每个物品的总出现次数(来自作业一统计),计算相似度,公式:
similarity = count / sqrt(item1_total item2_total),输出<item_id, (similar_item, similarity)>。 - Reducer:按物品ID聚合,按相似度降序排序,取TopN,然后根据用户历史物品查找这些相似物品,加权汇总生成每个用户的推荐列表。
运行与调优
- 资源分配:对于TB级数据,Map任务数建议为数据块数的2-3倍,Reduce任务数控制在集群资源允许范围内,通常每个节点1-2个Reduce。
- 压缩策略:中间结果使用Snappy压缩,减少磁盘I/O。
- 数据倾斜处理:如果物品共现分布不均,常见于长尾数据,可采用随机前缀加盐或二次排序解决,在共现阶段对物品ID进行哈希,将高频物品分散到多个Reduce。
ItemCF MapReduce 面试高频问题与解答
面试中,面试官常围绕数据倾斜、相似度算法选择和性能优化展开提问,以下是对应的解答思路。
数据倾斜如何处理
数据倾斜是ItemCF MapReduce实现中最常见的痛点。多数情况下,热门物品的共现对数量远超普通物品,导致部分Reduce任务负载过高,解决方案包括:
- 加盐法:在Map输出时,对热门物品ID添加随机前缀,将原属于同一Reduce的键分散到多个Reduce,再在后续阶段去除前缀并聚合。
- 二次排序:通过自定义分区和分组,将数据按物品ID分区,但按共现次数排序,使得Reduce内部可逐步处理,避免内存溢出。
- 调整分区数:增加Reduce数量,但需注意资源开销。
相似度算法选择
ItemCF常见的相似度公式有余弦相似度和Jaccard相似度。行业共识认为,对于评分数据,余弦相似度更准确;对于行为数据(如点击、购买),Jaccard相似度因不考虑行为频次,效果更稳定,在MapReduce实现中,两种公式的差异仅在于是否除以物品总权重的平方根,计算复杂度相近。
性能优化策略
- 减少MapReduce作业数:将共现与相似度计算合并为一个作业,在Map阶段同时计算物品总权重,Reduce阶段直接输出相似度。
- 使用内存缓存:在作业三中,将物品总权重表加载到DistributedCache,避免每次计算都从HDFS读取。
-
合理设置压缩
:Map输出和Reduce输出均启用压缩,Shuffle效率可提升相当一部分。
ItemCF MapReduce 与Spark实现对比
Spark基于内存计算,在迭代计算和实时性上优于MapReduce,但MapReduce在离线批处理场景下依然稳定可靠。对于中小规模数据(TB级以下),MapReduce的磁盘I/O开销可接受,且维护成本低;对于PB级海量数据,Spark的优势更明显,尤其是当需要多次迭代计算相似度时,在选择时,还需考虑团队技术栈和集群资源。
ItemCF MapReduce 常见问题解答
问题1:ItemCF MapReduce中如何避免数据倾斜?
可以在Map阶段对热门物品ID进行随机前缀加盐,使共现对均匀分布到不同Reduce,后续再通过额外MapReduce作业去除前缀并聚合,另一种方法是使用自定义分区函数,将高频物品的共现对单独路由到独立Reduce,但需注意全局排序。
问题2:ItemCF MapReduce代码示例中的相似度公式如何实现?
以余弦相似度为例,在Map阶段读取共现次数count和物品总出现次数item1_total、item2_total,Reduce阶段计算similarity = count / sqrt(item1_total item2_total),输出时需过滤掉相似度低于阈值的物品对,减少推荐噪声。
问题3:ItemCF MapReduce的推荐结果如何实时更新?
MapReduce属于离线计算,无法做到实时更新。业内专家指出,通常采用离线预计算加增量更新的策略:每日凌晨通过MapReduce全量计算物品相似度,白天实时捕获用户新行为,通过增量MapReduce或流式计算更新小范围相似度,最终合并到推荐系统中,这种方案兼顾了离线计算的准确性和在线服务的时效性。
ItemCF在MapReduce下的实现虽不如Spark等框架高效,但依然是大规模离线推荐系统的根基,掌握其原理和优化技巧,能帮助你理解推荐系统的底层逻辑,也为后续迁移到更先进的框架打下扎实基础。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/587891.html