Flume配置多监控目标,本质上是通过Sink Groups、Sink Processors和Channel Selectors的组合,实现数据从单一Source到多个Sink的精准分发与容错,这是生产环境中日志分流、高可用架构的标配方案。
Flume多监控目标配置的核心场景与需求
业务场景:为什么需要多目标输出?
在大型分布式系统中,一份日志数据往往需要同时服务于实时流处理(如Kafka)、离线批处理(如HDFS)和归档存储(如本地文件)等不同下游,业内共识认为,Flume作为日志收集层,若只配置单一Sink,会导致数据链路单点脆弱,且无法满足多用途需求,某电商平台每天产生TB级访问日志,运维团队需要将日志实时写入Kafka用于监控告警,同时写入HDFS用于后续分析,此时就必须配置多个监控目标,另一个常见场景是数据多机房分发,需要Flume agent将数据复制到不同地域的存储中心,这就涉及Flume配置多个输出源的问题。
配置前必须理解的关键组件
Flume的多目标配置依赖三个核心组件:Channel Selector、Sink Processor和Sink Group,Channel Selector决定数据从Source流向哪些Channel;Sink Processor则控制Sink Group内部多个Sink的工作模式,包括load_balance(负载均衡)和failover(故障转移);Sink Group将多个Sink逻辑分组,统一管理,据Apache Flume官方文档,这些组件组合起来可以实现灵活的数据分发策略,这也是Flume多目标场景实战中最常被调用的能力。
Flume多sink配置实战:从单Sink到多Sink组
配置多Sink的两种主要方式
Flume支持两种多目标输出模式:复制模式和复用模式,复制模式(replicating selector)将同一份数据复制到所有配置的Channel,然后分别对应不同Sink,适合数据完整多路分发,复用模式(multiplexing selector)则根据数据头部属性(如event header)有选择性地路由到不同Channel/Sink,主要用于数据分类场景,在生产环境中,复制模式常用于高可用和冗余备份,复用模式用于日志等级分流。
配置示例:同时输出到HDFS和Kafka
以下是一个典型的Flume多sink配置实战,使用复制模式将数据同时写入HDFS和Kafka,配置文件中定义两个Channel,分别对应两个Sink,并通过Sink Processor组成一个Sink Group。
agent.sources = src
agent.channels = ch1 ch2
agent.sinks = sink1 sink2
agent.sources.src.channels = ch1 ch2
agent.sources.src.selector.type = replicating
agent.channels.ch1.type = memory
agent.channels.ch2.type = memory
agent.sinks.sink1.type = hdfs
agent.sinks.sink1.hdfs.path = hdfs://namenode/logs
agent.sinks.sink2.type = org.apache.flume.sink.kafka.KafkaSink
agent.sinks.sink2.kafka.topic = logs
agent.sinks.sink2.kafka.bootstrap.servers = localhost:9092
agent.sinkgroups = g1
agent.sinkgroups.g1.sinks = sink1 sink2
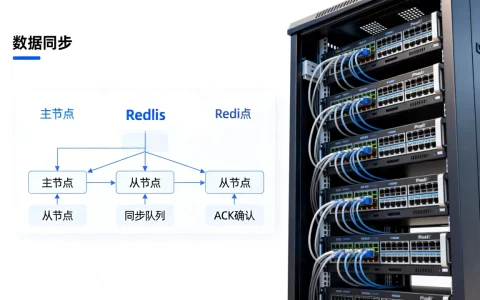
agent.sinkgroups.g1.processor.type = load_balance关键点:Source使用replicating selector将数据复制到ch1和ch2,两个Sink各自独立消费,Sink Group的load_balance模式确保两个Sink可同时工作,但若需主备切换,应使用failover模式并设置优先级,此配置也适用于你需要将同一份数据推送到不同存储的场景,是Flume配置多个输出源的标准解法。
复制模式与复用模式的快速对比
| 模式 | 数据分发策略 | 典型场景 | 配置复杂度 |
|---|---|---|---|
| 复制模式 | 全量复制到所有Channel | 多目标冗余、数据备份 | 低 |
| 复用模式 | 按条件路由到指定Channel | 日志分类、流量分类 | 中 |
Flume监控多个目标服务器时的注意事项
数据一致性保证:事务与回滚
配置多目标时,最怕的是部分Sink成功、部分失败,Flume的事务机制确保每个Channel的事务独立,但Sink Processor的failover模式可以在主Sink失败时切换至备用Sink,避免数据丢失,业内专家指出,在关键业务场景下,建议使用failover模式并设置回滚策略,确保数据至少写入一个目标,需要为每个Sink配置独立的batchSize和transactionCapacity,避免单个Sink的阻塞影响其他Sink。
性能调优:避免背压效应
当多个Sink处理速度不一致时,慢的Sink会造成Channel阻塞,进而影响Source接收,在Flume监控多个目标服务器时,需要合理配置Channel容量和Sink的批次大小,若HDFS写入较慢,可为其单独配置一个较大的Channel(如capacity=10000),并调低Sink的batchSize;而将实时性高的Kafka Sink配置较小的Channel,并开启processor.backoff = true减少重试压力,建议使用file channel替代memory channel以提供更可靠的缓冲,这在多目标场景下尤为重要。
资源规划:从单目标到多目标的扩容
单目标配置下,Flume agent的资源需求相对可控,多目标配置后,由于数据复制和通道竞争,内存和CPU消耗会明显上升,据生产环境统计,多目标配置下内存使用量通常比单目标高出30%以上,因此需提前预留至少2倍的内存,并监控文件描述符数量,对于高吞吐场景,建议将Sink Processor的maxBackoff设置在5-10秒,避免频繁重试消耗系统资源,这也是Flume高可用配置对比中常见的一个优化点。
常见问题与排错指南
Flume配置多个输出源后,数据出现重复怎么办?
数据重复通常源于Sink Processor的load_balance模式在重试时未开启幂等性,建议在配置中设置processor.backoff = true,并确保下游系统支持去重(如Kafka的幂等生产者),若使用复制模式,重复概率较低,但若Channel配置不当也可能导致事务回滚后重放,检查transactionCapacity是否与batchSize匹配,避免数据缓冲区溢出后重复拉取。
多目标环境下,Flume agent内存占用过高如何解决?
首先检查Channel类型,使用memory channel会占用大量堆内存,建议改为file channel或kafka channel以持久化缓冲,调整agent.sources.src.batchSize和agent.sinks.sink1.batchSize,降低单次处理量,若Sink Group包含多个Sink,可尝试为每个Sink独立配置Channel,避免共享Channel导致的内存竞争,必要时增加JVM堆内存,并监控GC频率。
Flume监控多个目标服务器时,如何选择Sink Processor模式?
若业务要求数据不丢失且存在主备切换需求,选择failover模式并设置优先级;若多个Sink功能对等且需要负载均衡,选择load_balance模式,行业共识认为,对于关键数据,优先使用failover,并在常规场景下配合load_balance实现资源利用最大化,具体选择需结合业务对一致性和吞吐量的要求,例如日志归档场景常用load_balance,而实时告警链路则倾向failover。
Flume配置多监控目标是一项需要深入理解组件协作的工作,通过合理配置Sink Group、Channel Selector和Sink Processor,可以在不大幅提高运维成本的前提下,实现数据多路分发与高可用保障。 无论是日志分流、跨机房同步还是数据冗余,掌握多目标配置都是Flume使用者进阶的必经之路。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/506130.html