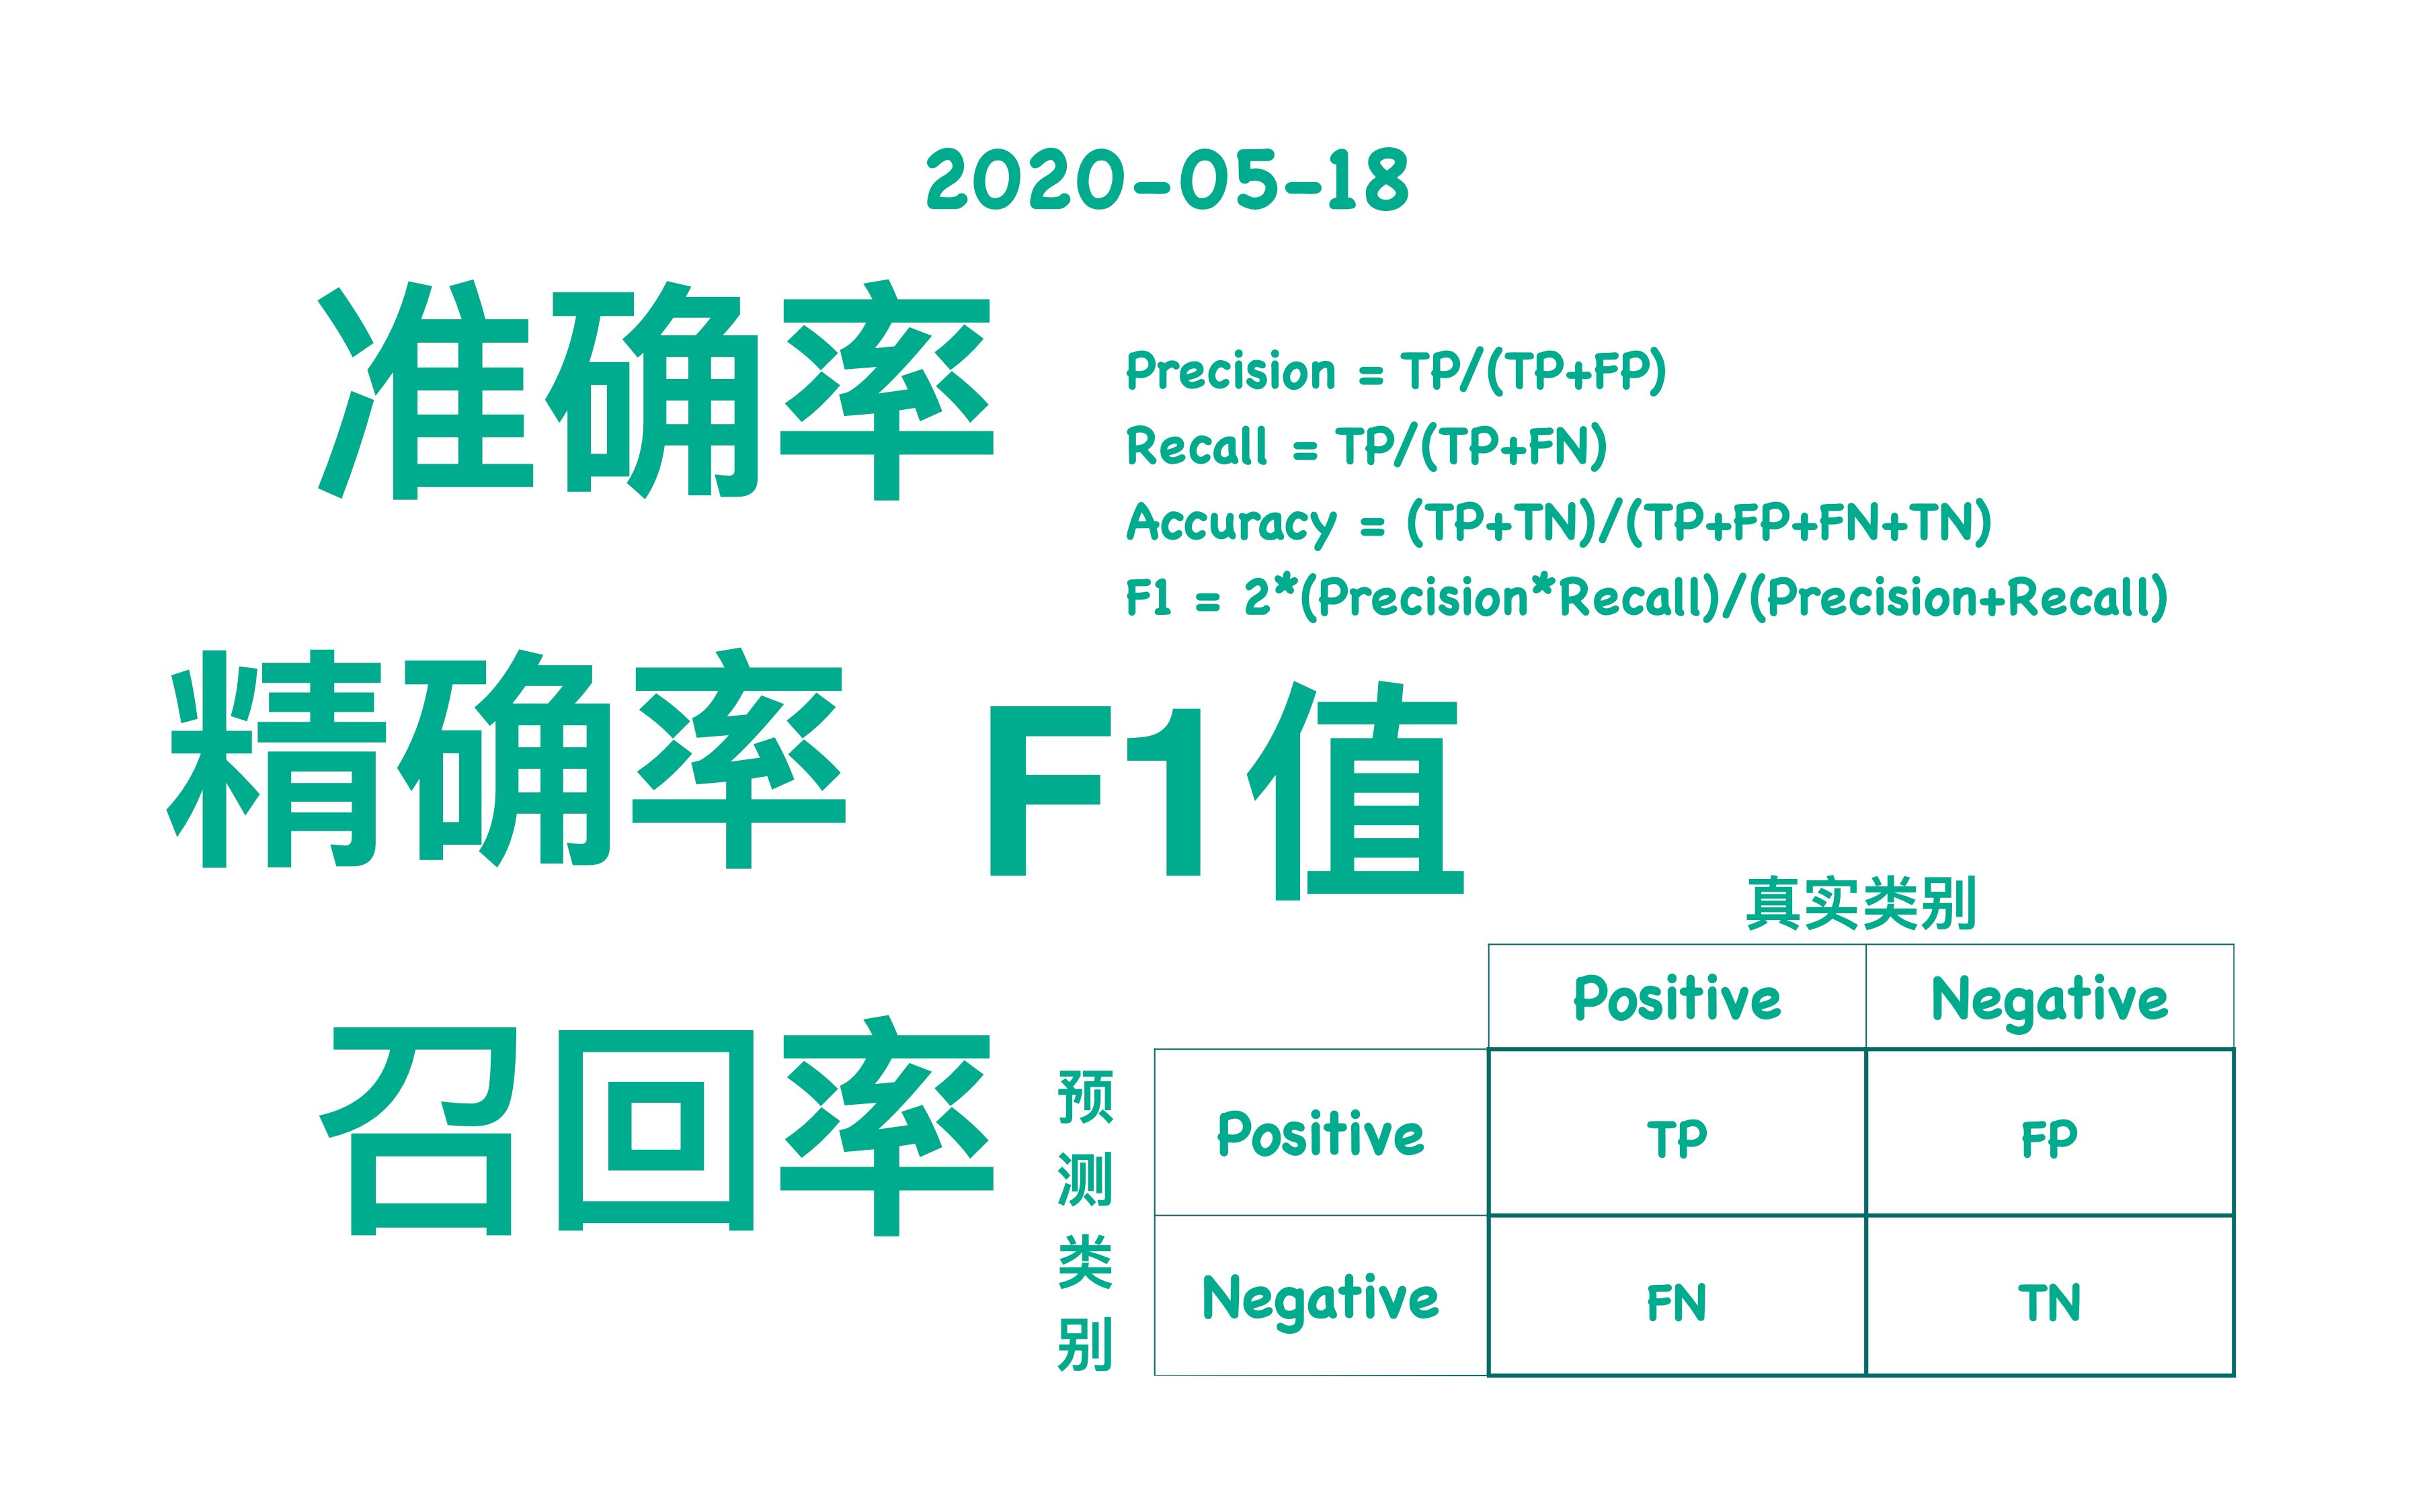
F1 Score是精确率(Precision)和召回率(Recall)的调和平均数,它通过平衡“查得准”和“查得全”两个维度,成为评估大模型在分类、信息抽取等任务中综合性能的核心指标,尤其适用于数据类别不平衡的场景。
在大模型应用的落地过程中,单纯看准确率往往会产生误导,想象一下,如果一个模型预测所有邮件都是“非垃圾邮件”,它的准确率可能高达99%,但它完全漏掉了真正的垃圾邮件,这就是为什么我们需要F1 Score,它不仅仅是一个数字,更是衡量模型在“宁错杀不放过”和“宁放过不错杀”之间找到最佳平衡点的标尺。

大模型的F1 Score是什么及计算逻辑
要理解F1 Score,必须先拆解它的两个子组件:精确率和召回率,这两个指标在大模型处理自然语言处理(NLP)任务时,往往存在此消彼长的关系。
精确率与召回率的博弈
精确率关注的是“预测为正类的样本中,有多少是真正的正类”,在大模型提取实体时,如果模型输出了10个“人名”,但只有8个是真的,那么精确率就是0.8,这代表了模型的“严谨程度”。
召回率关注的是“所有真正的正类样本中,有多少被模型正确预测出来了”,如果真实存在的“人名”有20个,模型只找出了8个,那么召回率就是0.4,这代表了模型的“覆盖能力”。
调和平均数的必要性
为什么不用算术平均数?因为算术平均数会掩盖极端情况,如果精确率是1.0,召回率是0.0,算术平均是0.5,但这毫无意义,因为模型完全失效,调和平均数对极小值更敏感,只有当精确率和召回率都较高时,F1 Score才会高。
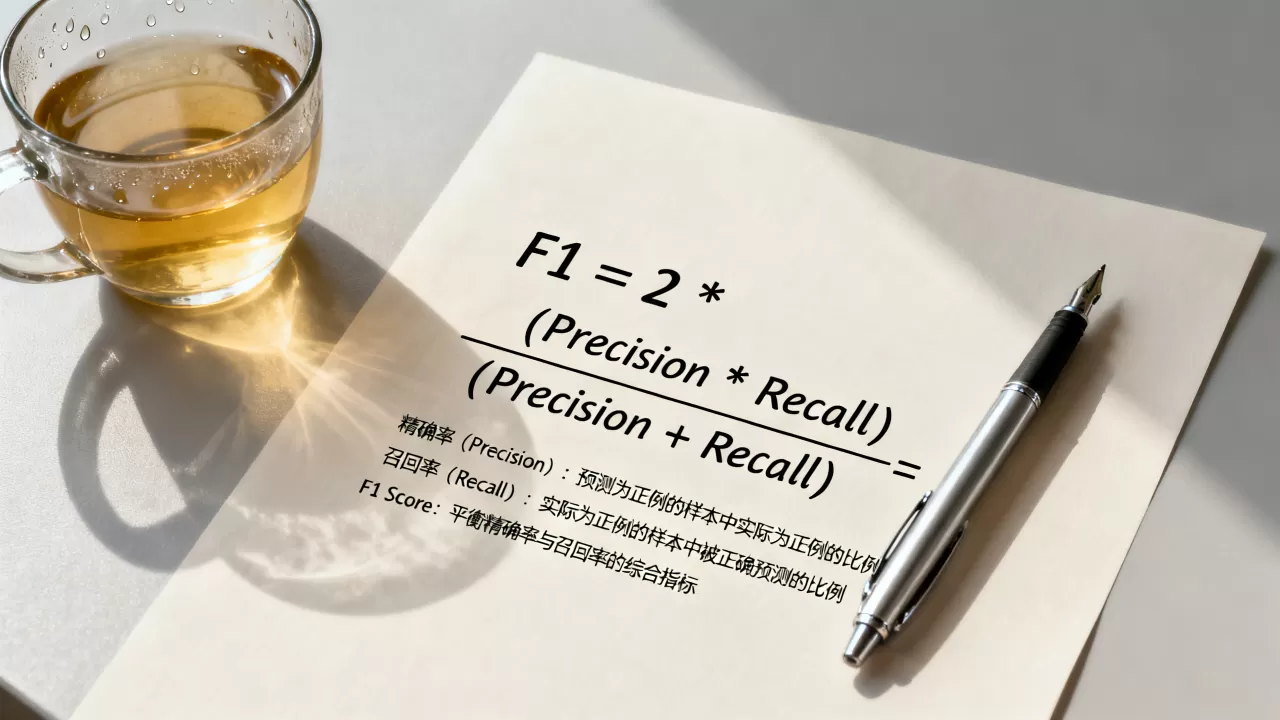
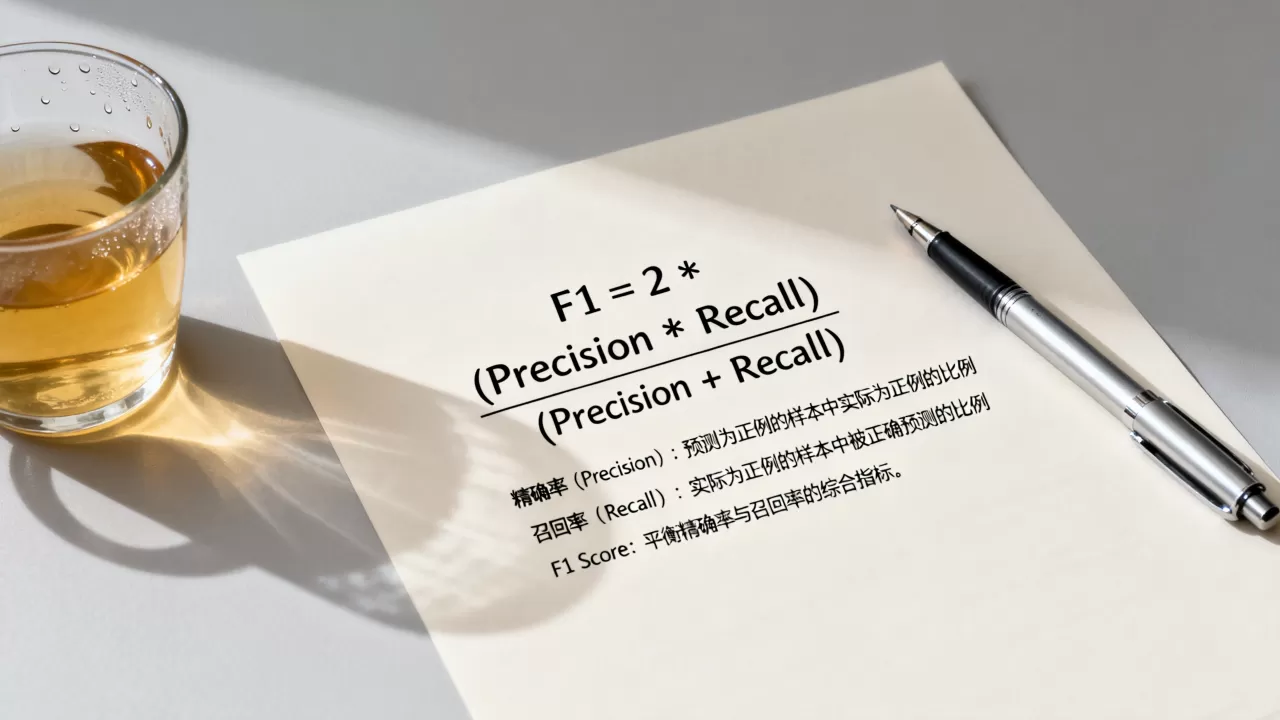
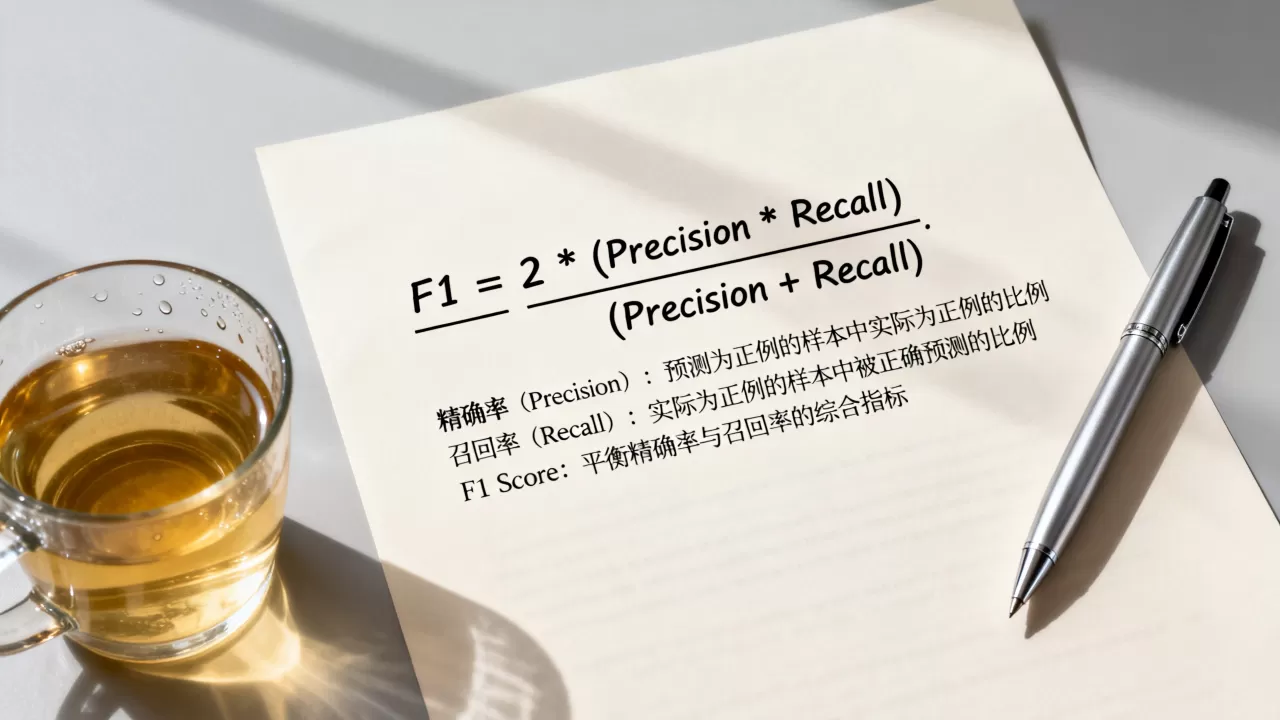
公式如下:
$$ F1 = 2 times frac{Precision times Recall}{Precision + Recall} $$
业内专家指出,这种计算方式确保了模型不能通过牺牲一方来换取另一方的虚高,从而更真实地反映模型在复杂场景下的鲁棒性。
大模型F1 Score在不同场景下的应用差异
不同的大模型应用场景对F1 Score的敏感度不同,理解这些差异,有助于我们选择合适的评估维度。
情感分析与文本分类
在情感分析任务中,我们通常希望模型能准确判断用户的情绪是正面、负面还是中性,由于数据分布可能不均(例如正面评价远多于负面评价),F1 Score的微平均(Micro-F1)或宏平均(Macro-F1)变得至关重要。
- 宏平均F1:对每个类别单独计算F1,然后求平均,这能防止多数类主导评估结果,适合关注少数类(如罕见负面情感)的场景。
- 微平均F1:先计算所有类别的总TP、FP、FN,再求F1,这反映了整体样本的加权表现,适合类别分布不均且关注整体准确性的场景。
信息抽取与实体识别
在命名实体识别(NER)任务中,F1 Score通常是黄金标准,大模型需要从长文本中精准定位“人名”、“地名”、“机构名”等。
- 严格匹配:要求模型输出的实体边界、类型完全一致。
- 宽松匹配:允许实体边界略有偏差,但类型必须正确。
据统计,在医疗文本抽取场景中,严格F1 Score的提升1个百分点,往往意味着临床决策支持系统可靠性的显著增强。
如何优化大模型的F1 Score实操指南
提升F1 Score不是简单的调参,而是一套系统工程,以下是经过验证的实操路径。
数据层面的优化策略
- 处理类别不平衡:如果负样本远多于正样本,使用过采样(SMOTE)或欠采样技术,或者在损失函数中引入类别权重。
- 高质量标注:确保训练数据的标注一致性,噪声标签会直接拉低精确率,进而影响F1 Score。
- 数据增强:利用大模型本身生成合成数据,扩充少数类样本,提升模型对罕见情况的召回能力。
提示工程与推理优化
对于基于Prompt的大模型,提示词的设计直接影响输出格式,进而影响后处理的F1计算。
- 结构化输出:强制模型输出JSON格式,便于程序化解析,减少因格式错误导致的匹配失败。
- Few-Shot Learning:提供少量高质量示例,引导模型模仿正确的实体边界和分类逻辑。
- 阈值调整:在推理阶段,调整置信度阈值,提高阈值可增加精确率,降低阈值可增加召回率,通过绘制PR曲线找到最佳平衡点。
模型微调与评估
- LoRA微调:使用低秩自适应技术对基座模型进行轻量级微调,使其更适应特定领域的术语和表达习惯。
- 交叉验证:使用K折交叉验证评估F1 Score的稳定性,避免偶然性。
大模型F1 Score与其他指标对比分析
在评估大模型时,F1 Score并非唯一指标,了解其与其他指标的优劣,有助于全面评估模型性能。
F1 Score vs. 准确率(Accuracy)
| 指标 | 适用场景 | 优点 | 缺点 |
|---|---|---|---|
| 准确率 | 类别平衡的二分类问题 | 直观易懂 | 类别不平衡时失效,易被多数类主导 |
| F1 Score | 类别不平衡、多分类、信息抽取 | 平衡精确率与召回率,鲁棒性强 | 计算稍复杂,对极端不平衡仍敏感 |
行业共识认为,在医疗诊断、欺诈检测等高风险且类别不平衡的场景中,F1 Score比准确率更具参考价值。
F1 Score vs. AUC-ROC
AUC-ROC衡量的是模型在不同阈值下的整体排序能力,而F1 Score是在特定阈值下的性能表现,AUC高不代表F1高,因为AUC对正负样本的比例不敏感,在实际部署中,我们需要确定一个具体的决策阈值,此时F1 Score更能反映实际业务效果。
大模型F1 Score评估常见问题解答
大模型F1 Score计算中如何处理重叠实体?
在实体识别任务中,如果一个文本片段同时属于多个实体类型,标准的F1计算可能会产生歧义,业内通常采用“最长匹配优先”或“嵌套实体支持”策略,对于嵌套实体,需使用专门的评价脚本(如SpaCy的NER评估模块),确保每个实体实例都被独立计数,避免重复计算或漏计。
大模型F1 Score低的主要原因有哪些?
主要原因包括:训练数据分布与测试数据分布不一致(域偏移)、提示词设计未能有效约束模型输出格式、模型本身对长尾知识的掌握不足,评估脚本中的匹配规则过于严格,也会人为降低F1 Score。
大模型F1 Score达到多少算优秀?
这取决于具体任务和数据集难度,在通用情感分析中,F1 Score超过0.90通常被视为优秀;在细粒度医疗实体抽取中,由于术语复杂且标注噪声大,F1 Score达到0.80以上已属高水平,没有绝对标准,需与基线模型(Baseline)对比,观察提升幅度。
提升大模型F1 Score是一个持续迭代的过程,需要从数据、算法、工程三个维度协同优化,只有深入理解精确率与召回率的内在张力,才能在复杂多变的实际应用中,构建出既精准又全面的智能系统。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/406410.html