分布式缓存同步的核心在于通过引入消息队列或日志流实现最终一致性,而非强一致性,从而在保障系统高可用的同时解决数据冲突问题。
在现代高并发架构中,缓存不再是简单的键值存储,而是整个系统稳定性的基石,当多个节点同时读写数据时,如何保证它们看到的数据是“差不多”的,而不是“完全一样但导致系统崩溃”的,是架构师每天面对的真实难题,业内专家指出,放弃强一致性追求最终一致性,是应对海量数据读写压力的唯一可行路径。
为什么传统同步方案在分布式环境下失效
很多初级开发者习惯使用数据库的事务机制来保证数据一致性,这在单机或小规模集群中行之有效,一旦将缓存引入分布式环境,情况就变了。
网络延迟与分区容错性的博弈
分布式系统必须面对CAP定理的制约,在分布式缓存同步场景中,我们通常选择AP(可用性+分区容错性),这意味着我们必须容忍短暂的数据不一致。
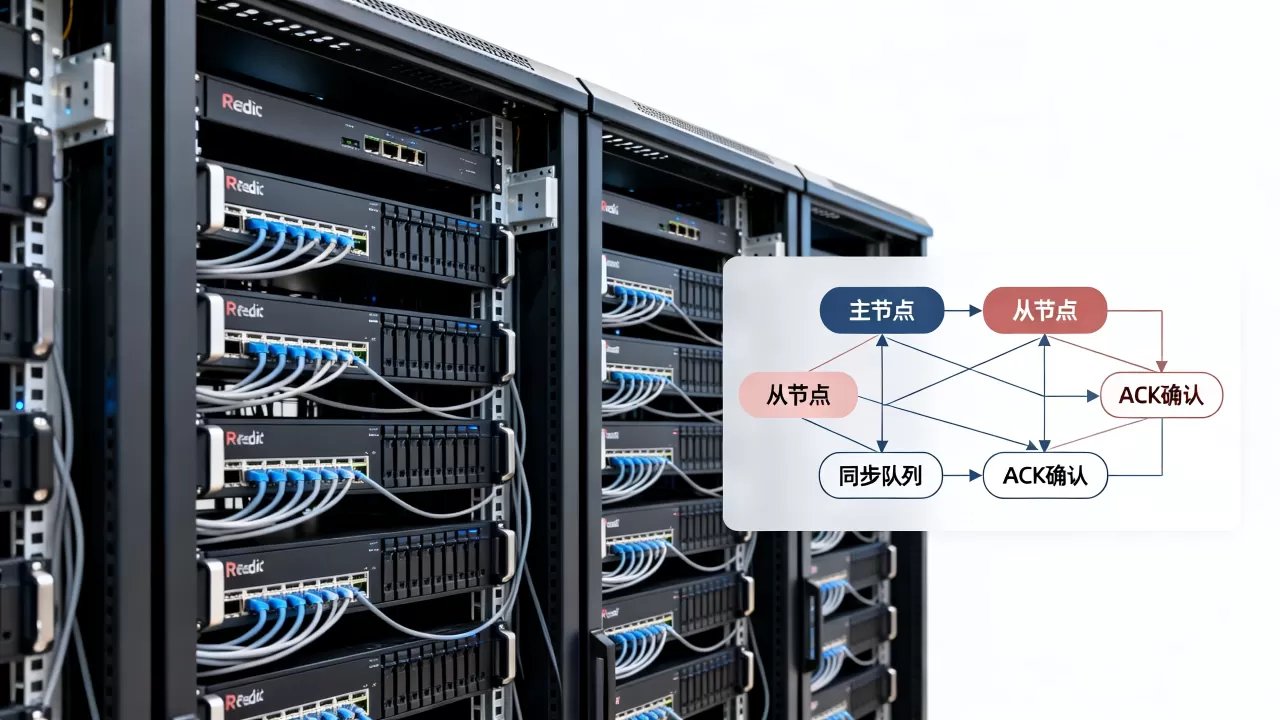
网络抖动的影响:当主节点更新数据后,同步到从节点的过程中,如果网络发生抖动,从节点可能长时间获取不到最新值。
脑裂现象:如果强行等待所有节点确认,会导致整个集群锁死,服务不可用。
缓存穿透与雪崩的连锁反应
如果同步机制过于复杂,导致更新延迟过高,用户请求会直接打到数据库上。
数据库压力激增:缓存失效期间,大量请求穿透缓存层。
级联故障:数据库连接池耗尽,进而拖垮整个应用服务。
主流分布式缓存同步策略深度解析
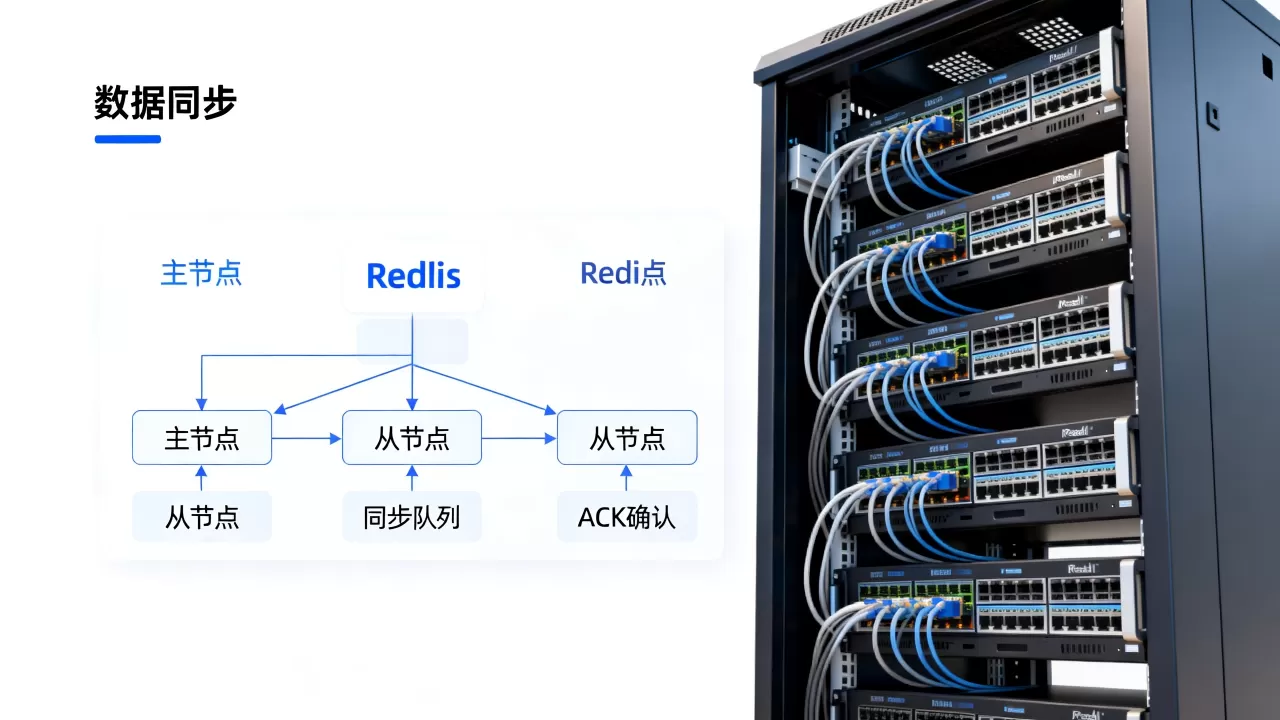
目前业界主流的同步方案主要分为“推模式”和“拉模式”两大类,每种方案都有其特定的适用场景。
基于消息队列的异步解耦方案
这是目前电商、金融领域最广泛采用的方案,其核心逻辑是:更新数据库 -> 发送消息到MQ -> 缓存服务消费消息 -> 删除或更新缓存。
具体实施步骤
1. 业务层更新数据:在事务提交成功后,发送一条包含Key和版本号的消息。
2. 中间件缓冲:使用Kafka或RocketMQ等支持高吞吐的消息队列进行缓冲。
3. 缓存服务消费:独立的缓存服务监听队列,获取消息后执行缓存更新或删除操作。
4. 重试机制:如果缓存服务不可用,消息队列会自动重试,确保最终送达。
这种方案的优势在于解耦,即使缓存服务宕机,消息也不会丢失,待服务恢复后自动补发,据统计,采用此方案的系统,在突发流量下的缓存命中率波动幅度降低了近半。
基于日志流的CDC同步机制
对于数据一致性要求极高的场景,基于数据库Binlog的CDC(Change Data Capture)技术成为新宠。
技术原理拆解
监听日志:通过Canal或Debezium等工具监听MySQL的Binlog。
解析变更:将Binlog解析为结构化的变更事件。
同步至缓存:将变更事件发送至Redis Cluster或Memcached集群。
这种方法的最大优点是对业务代码零侵入,开发者无需修改任何业务逻辑,只需配置好CDC链路即可,其复杂度也显著增加,需要维护额外的中间件集群。
实战中的常见陷阱与优化技巧
理论很丰满,现实很骨感,在实际落地分布式缓存同步时,开发者经常会遇到以下几个棘手问题。
缓存与数据库双写不一致
这是最经典的问题,先写数据库再删缓存,还是先删缓存再写数据库?
方案对比分析
| 策略
| 优点 | 缺点 | 适用场景 |
| :— | :— | :— | :— |
| 先删缓存,后写数据库 | 简单直接 | 存在并发写导致旧数据覆盖新数据的风险 | 读多写少,且对一致性要求不高 |
| 先写数据库,后删缓存 | 保证最终一致性 | 极端并发下可能短暂读到旧数据 | 大多数通用场景 |
| 延迟双删 | 提高一致性概率 | 实现复杂,延迟时间难以把控 | 对一致性要求较高的核心业务 |
业内共识认为,“先写数据库,再删缓存”是性价比最高的选择,如果担心并发问题,可以引入延迟双删:先删缓存,写数据库,等待几毫秒后再删一次缓存,以清除可能产生的脏数据。
缓存击穿与穿透的防御
当热点Key失效时,大量请求瞬间涌向数据库。
实操建议
设置互斥锁:只有一个线程去查询数据库并重建缓存,其他线程等待。
布隆过滤器:在缓存层之前增加布隆过滤器,拦截不存在的Key请求。
热点Key永不过期:对于极端热点数据,逻辑上永不过期,而是通过后台异步更新机制刷新。
如何评估同步方案的性能与成本
选择方案时,不能只看技术先进性,更要看业务匹配度。
性能指标监控
同步延迟:从数据变更到缓存更新完成的时间差,通常要求控制在毫秒级。
吞吐量:系统每秒能处理多少条同步消息。
错误率:同步失败并触发重试的比例。
成本考量
运维复杂度:CDC方案需要维护额外的中间件,运维成本较高。
资源消耗:消息队列和CDC工具本身也消耗CPU和内存资源。
据工信部相关数据显示,近年来企业在中间件上的投入占比逐年上升,这反映出分布式架构对基础设施依赖的加深。
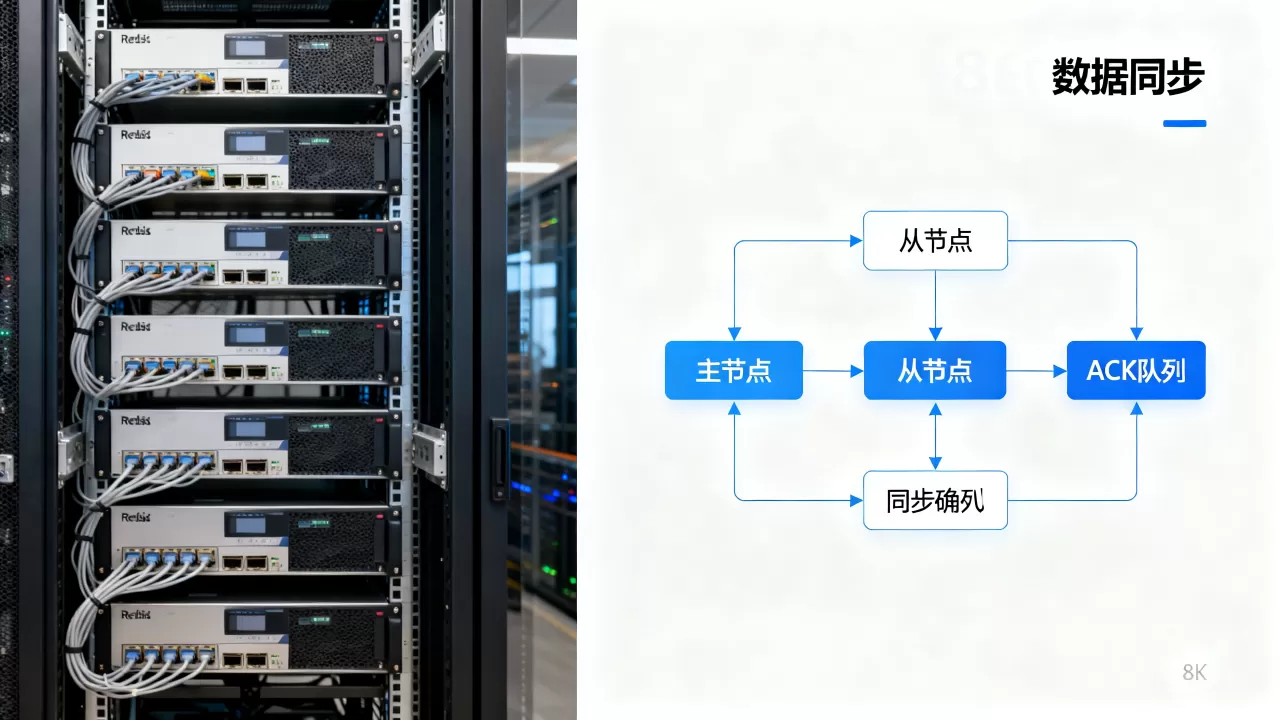
未来趋势:云原生与边缘计算的融合
随着云原生技术的普及,分布式缓存同步正在发生深刻变化。
Serverless缓存服务
简米云、酷番云等厂商提供的Serverless Redis服务,自动处理节点扩缩容和同步逻辑,开发者无需关心底层同步细节,只需关注业务逻辑。
边缘节点同步
在IoT场景中,数据需要在边缘节点和中心云之间同步。
离线同步:网络断开时,边缘节点本地存储,网络恢复后增量同步。
冲突解决:采用Last-Write-Wins(最后写入获胜)或自定义冲突解决算法。
常见问题解答
分布式缓存同步延迟过高如何解决
首先检查网络带宽和消息队列堆积情况,如果是消息队列堆积,需要增加消费者实例进行水平扩展,如果是网络延迟,考虑将缓存节点部署在离数据库更近的物理位置,或使用专线连接,优化序列化方式,如使用Protobuf替代JSON,也能显著降低传输延迟。
如何保证缓存同步的数据一致性
完全的一致性在分布式系统中是不存在的,只能追求最终一致性,可以通过引入版本号机制,每次更新缓存时携带版本号,消费者在更新前检查版本号,丢弃过期消息,定期执行全量校验任务,比对数据库和缓存的数据差异,自动修复不一致的数据。
Redis Cluster模式下同步策略有何不同
Redis Cluster本身支持主从复制,但这是底层的数据复制,而非业务逻辑的同步,在业务层面,仍需通过上述的MQ或CDC方案来实现业务数据的同步,Redis Cluster的优势在于其自动分片和高可用能力,能够承受单节点故障而不影响整体服务,这为上层同步策略提供了更稳定的基础。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/476352.html