将本地数据上传至远程深度学习服务器,最高效且稳定的方案是使用支持断点续传的命令行工具(如rsync或scp),配合SSH密钥认证实现自动化传输,避免GUI工具在大数据量下的卡顿与中断风险。
在人工智能开发领域,算力即生产力,当你拥有了一块强大的GPU服务器,却受限于本地硬盘的读写速度和网络带宽时,数据搬运就成了最大的瓶颈,很多开发者习惯使用图形化界面工具(如WinSCP或FileZilla)拖拽文件,这在处理GB级别的小数据集时尚可应付,但一旦涉及TB级别的图像库或视频流,这种操作不仅效率低下,还极易因网络波动导致任务失败,业内专家指出,自动化脚本和命令行工具才是解决大规模数据迁移的终极方案,它们能利用多线程并发传输,并具备极强的容错能力。
为什么命令行工具是上传首选
图形界面工具虽然直观,但在底层逻辑上往往缺乏对网络状态的精细控制,相比之下,命令行工具能够直接调用操作系统的底层接口,实现更高效的资源调度。
断点续传的关键价值
深度学习数据集通常体积庞大,动辄数百GB甚至数TB,在网络环境不稳定的情况下,全量重传不仅浪费流量,更消耗宝贵的时间。
- rsync的优势:rsync是Linux系统下的神器,它默认采用增量传输算法,如果传输过程中断,再次执行命令时,它只会传输未完成的文件或文件的差异部分,而不是从头开始。
- 场景模拟:假设你正在上传一个500GB的训练集,传输到80%时网络断开,使用rsync,你只需重新运行命令,它会自动跳过已完成的400GB数据,仅处理剩余的100GB及校验信息,极大提升了容错率。
SSH密钥认证的安全性
频繁输入密码不仅繁琐,还存在被窃听的风险,配置SSH密钥对可以实现无密码登录,既安全又便捷。
配置步骤详解
- 生成密钥对
:在本地终端执行
ssh-keygen -t rsa -b 4096,一路回车即可生成公钥和私钥。 - 分发公钥:使用
ssh-copy-id user@server_ip命令,将公钥复制到服务器。 - 验证连接:再次执行
ssh user@server_ip,若无需输入密码即可登录,则配置成功。
主流上传工具对比与选择
面对不同的数据规模和网络环境,选择合适的工具至关重要,以下是几种常见工具的横向对比,帮助你做出最佳决策。
scp vs rsync:速度与安全性的博弈
| 特性 | SCP (Secure Copy) | Rsync |
|---|---|---|
| 核心机制 | 简单文件复制 | 增量同步与差异传输 |
| 断点续传 | 不支持(需手动处理) | 原生支持,效率极高 |
| 压缩传输 | 支持(-C参数) | 支持(-z参数) |
| 适用场景 | 小文件、一次性传输 | 大数据集、定期同步、网络不稳定 |
sftp:交互式传输的备选方案
如果服务器环境受限,无法安装rsync,sftp是一个可靠的替代方案,它基于SSH协议,安全性高,且支持交互式命令操作。
- 操作路径:在终端输入
sftp user@server_ip进入交互界面。 - 常用命令:使用
put上传本地文件,使用get下载远程文件。 -
局限性
:sftp默认单线程传输,对于大文件合并后的整体传输速度可能不如rsync的多线程优化版本。
实战:高效上传大型数据集的操作指南
理论再好,不如实操一次,以下提供一套经过验证的标准化操作流程,适用于大多数Linux服务器环境。
第一步:环境准备与路径规划
在开始传输前,务必在服务器上创建专用的数据目录,避免与系统文件或其他项目混淆。
- 创建目录:在服务器端执行
mkdir -p /data/deep_learning/dataset。 - 权限设置:确保当前用户拥有该目录的读写权限,执行
chmod 755 /data/deep_learning/dataset。
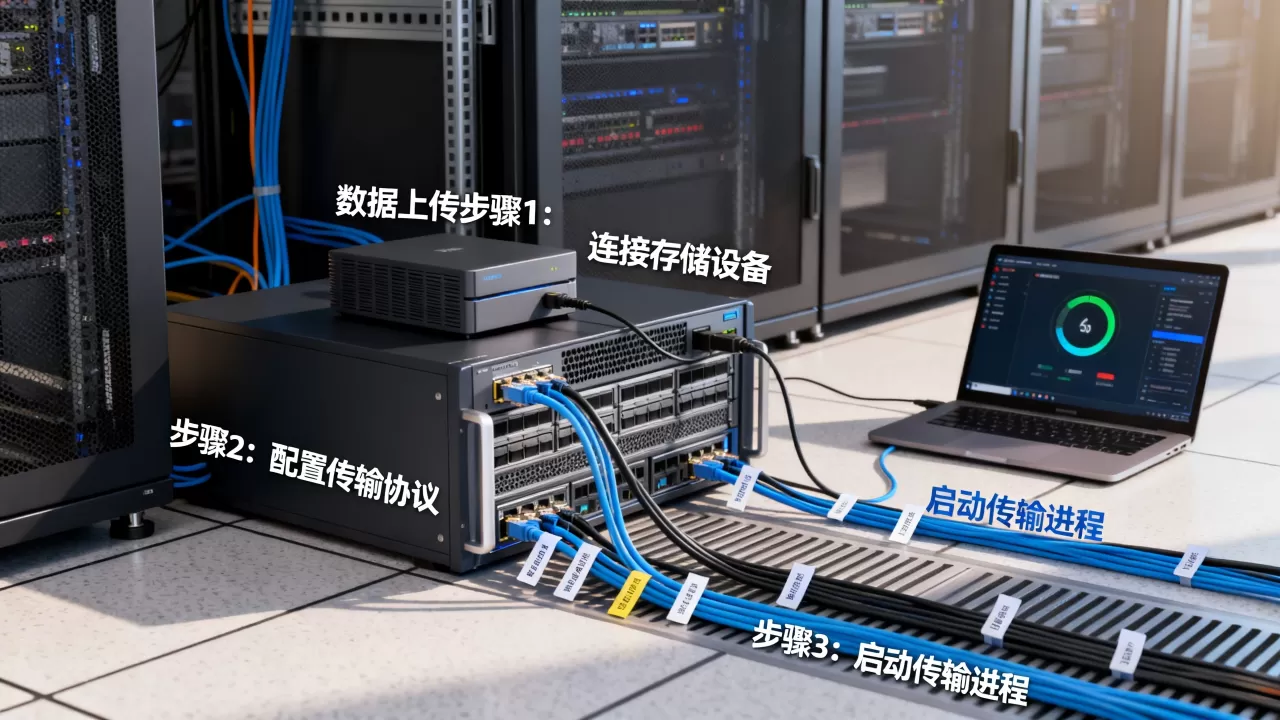
第二步:执行rsync传输命令
这是核心步骤,建议使用以下命令格式,兼顾速度、压缩和日志记录。
rsync -avz --progress -e "ssh -p 22" /local/path/to/dataset/ user@server_ip:/data/deep_learning/dataset/
- -a:归档模式,保留文件属性、权限和时间戳。
- -v:详细模式,显示传输过程。
- -z:压缩数据,节省带宽。
- –progress:显示当前文件的传输进度。
- -e:指定SSH连接参数,如需非标准端口需修改-p值。
第三步:监控与验证
传输完成后,不要立即关闭终端,需进行完整性校验。
- 检查日志:查看终端输出的最后几行,确认无报错信息。
- 数量核对:在本地和服务器端分别执行
find . -type f | wc -l,对比文件总数是否一致。 - 哈希校验:对于关键数据,可使用
md5sum对部分文件进行哈希值比对,确保数据未损坏。
常见误区与优化建议
在实际操作中,许多开发者容易陷入一些误区,导致效率低下或数据丢失。
忽视网络带宽限制
在共享网络环境中,盲目全速上传可能导致其他业务中断,rsync支持限速功能,可通过 --bwlimit=10000 参数限制传输速度为10MB/s,确保网络平稳。
忽略文件权限问题
上传后的文件可能因权限设置不当,导致深度学习框架无法读取,建议在传输后,在服务器端执行 chown -R user:user /data/deep_learning/dataset 统一文件所有者。
缺乏备份机制
数据是深度学习的基础,在上传前,务必对本地数据进行备份,若条件允许,可使用 rsync 的 --backup 参数,在服务器端保留旧版本文件,防止误覆盖。
Q&A:关于服务器数据上传的常见疑问
本地Windows系统如何高效上传数据到Linux服务器?
Windows用户推荐使用WSL(Windows Subsystem for Linux)或PowerShell中的OpenSSH客户端,在WSL环境中,可以直接使用上述rsync命令,访问Windows文件系统的路径通常为 /mnt/c/Users/YourName/...,若使用原生Windows,可安装MobaXterm或Termius,它们内置了SFTP客户端,支持拖拽上传,但建议对超大文件仍采用命令行方式以确保持续稳定性。
上传过程中出现“Connection reset by peer”错误怎么办?
这通常由网络超时或服务器配置限制引起,首先检查本地网络稳定性,尝试ping服务器IP,检查服务器端的SSH配置(/etc/ssh/sshd_config),适当增加 ClientAliveInterval 和 ClientAliveCountMax 的值,防止空闲连接被断开,若问题依旧,考虑更换传输时间段或使用更稳定的网络环境。
如何监控大数据上传的实时进度?
除了rsync自带的 --progress 参数,还可以使用 pv 命令进行更直观的监控。pv large_file.tar | ssh user@server_ip "cat > /remote/path/large_file.tar",pv会显示传输速度、已完成百分比和预计剩余时间,特别适合对进度有极高要求的场景。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/481388.html