

分布式数据处理的核心在于将海量任务拆解并分发至多台服务器并行执行,从而突破单机性能瓶颈,实现高吞吐、低延迟且具备容错能力的实时或离线分析。
为什么单机处理已无法满足2026年的数据需求
在2026年的商业环境中,数据量呈现指数级增长,无论是电商平台的每秒千万级订单,还是工业互联网中的传感器实时流,单机架构早已触及物理极限,业内专家指出,传统集中式数据库在面对PB级数据时,其IO吞吐量和计算扩展性已成为致命短板。
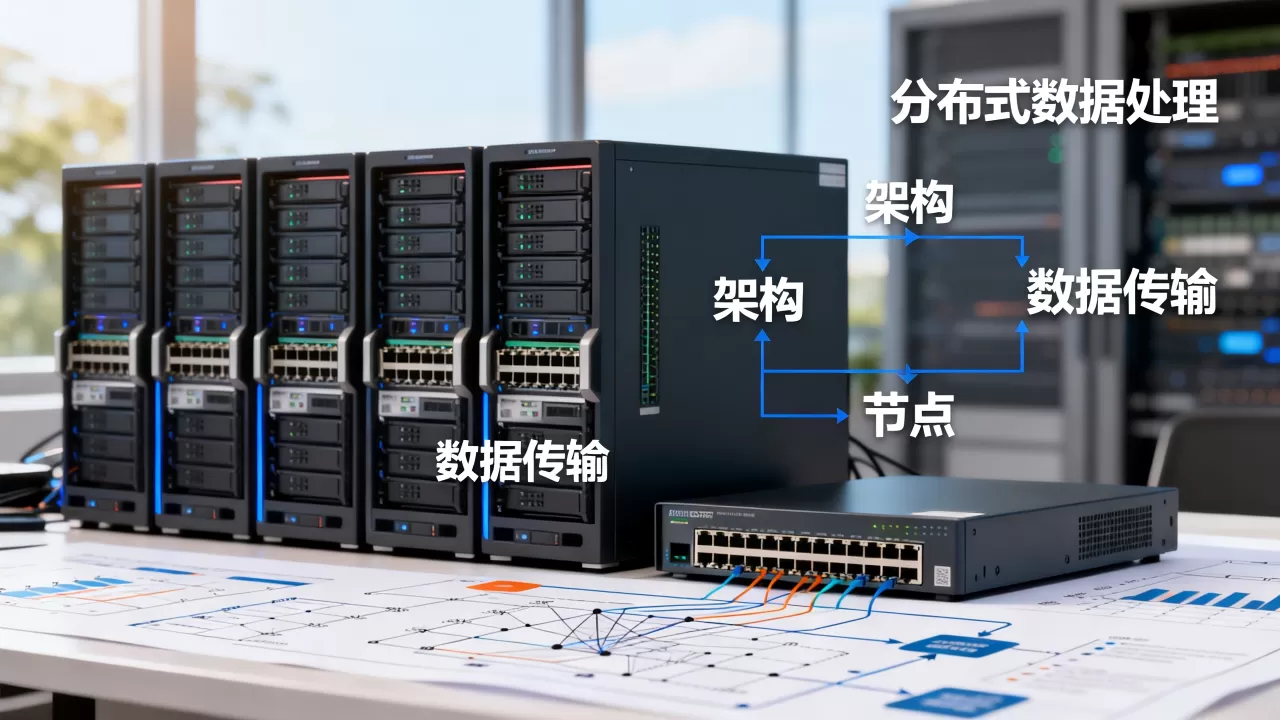
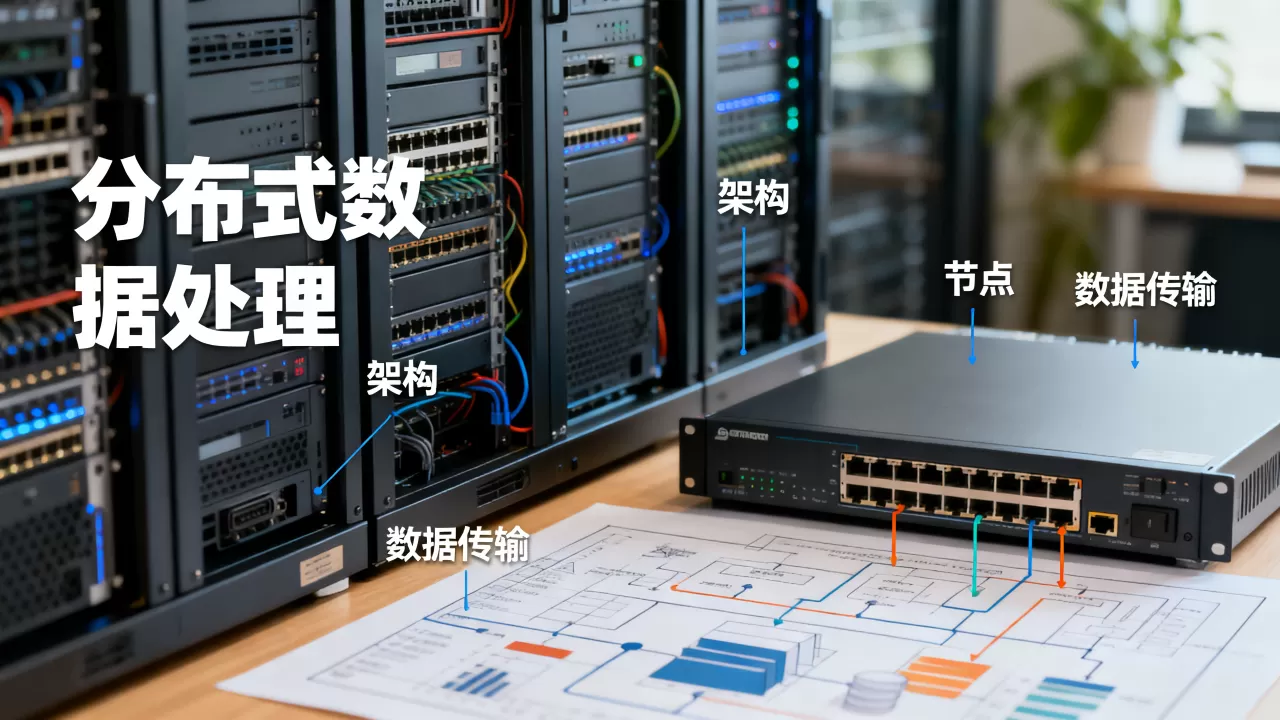
分布式架构之所以成为主流,主要基于以下三个核心优势:
- 横向扩展能力:通过增加普通服务器节点即可线性提升处理能力,无需购买昂贵的专用大型机。
- 高可用性:数据多副本存储机制确保单点故障不影响整体服务,系统自愈能力极强。
- 成本效益:利用商用硬件集群替代高端存储设备,显著降低TCO(总拥有成本)。
对比传统架构的性能差异
为了更直观地理解差异,我们来看一个典型场景:处理10TB日志数据。
| 维度 | 单机集群方案 | 分布式处理方案 |
|---|---|---|
| 扩展方式 | 纵向升级CPU/内存,成本呈指数上升 | 横向添加节点,成本线性增长 |
| 故障影响 | 单点故障导致全系统停机 | 自动故障转移,业务无感知 |
| 查询延迟 | 数据量越大,延迟越高 |
并行计算,延迟相对稳定 |
这种架构转变并非简单的技术升级,而是业务逻辑的重构。
分布式数据处理的核心技术选型
面对琳琅满目的技术栈,如何选择适合自身业务的工具是关键,2026年,主流技术已趋于成熟,主要分为流处理和批处理两大阵营,且界限日益模糊。
实时流处理与离线批处理的融合
过去,企业通常采用Lambda架构,同时维护流处理和批处理两套代码。Flink等引擎的普及使得“批流一体”成为现实。
- 实时场景:适用于风控拦截、实时推荐,使用Kafka作为消息队列,Flink进行状态计算。
- 离线场景:适用于月度报表、用户画像标签,使用Hive或Spark SQL进行大规模数据清洗。
- 混合场景:使用Iceberg或Hudi作为数据湖格式,支持事务性更新,实现实时写入与离线查询的统一。
如何评估技术栈的适用性
选择技术栈时,需考量以下指标:
- 数据一致性要求:金融级业务需强一致性,互联网业务可接受最终一致性。
- 延迟敏感度:毫秒级响应需选择内存计算框架,秒级可接受可考虑磁盘IO优化方案。
- 团队技术储备:开源社区活跃度直接影响后期维护成本。
落地实施中的关键挑战与解决方案
理论很丰满,落地很骨感,在实际部署中,数据倾斜、资源隔离和运维复杂度是三大拦路虎。
数据倾斜的识别与优化
数据倾斜是指某些Task处理的数据量远大于其他Task,导致整体作业被最慢的Task拖垮。
- 现象:监控面板显示少数几个Task运行时间极长,而其他Task早已完成。
- 原因:Key分布不均,如大量请求来自同一热门商品或地区。
- 解决方案:
- 加盐处理:在Key前添加随机前缀,将热点数据打散到不同节点。
- 广播变量:将小表广播至所有节点,避免Shuffle操作。
- 自定义分区器:根据数据分布特征设计更均匀的分区策略。
资源隔离与多租户管理
在共享集群中,不同业务线相互干扰是常见问题。
- 队列管理:使用YARN或Kubernetes进行资源队列划分,确保核心业务优先级。
- 弹性伸缩:基于CPU和内存使用率自动调整Pod数量,避免资源浪费。
- 隔离策略:采用Namespace隔离不同团队的数据空间,防止误操作。
2026年分布式数据处理的价格与地域考量
对于企业决策者而言,成本控制和合规性是绕不开的话题。
云服务与自建集群的成本对比
许多企业在初期倾向于自建集群以掌控数据主权,但随着规模扩大,云服务的弹性优势逐渐显现。
- 自建集群:前期硬件投入大,运维团队成本高,但长期看,数据量极大时单位成本较低。
- 云服务:按需付费,无需维护底层设施,适合业务波动大或初创企业,据工信部数据,云服务在中小企业中的采用率已接近半数。
地域性数据合规要求
不同地区对数据驻留有不同要求,欧盟GDPR要求个人数据留在境内,中国《数据安全法》也对重要数据出境有严格限制。
- 多区域部署:采用跨可用区部署,确保数据本地化存储。
- 边缘计算:在数据产生源头进行初步处理,仅上传脱敏后的聚合数据,降低合规风险。
未来趋势:AI与分布式计算的深度融合
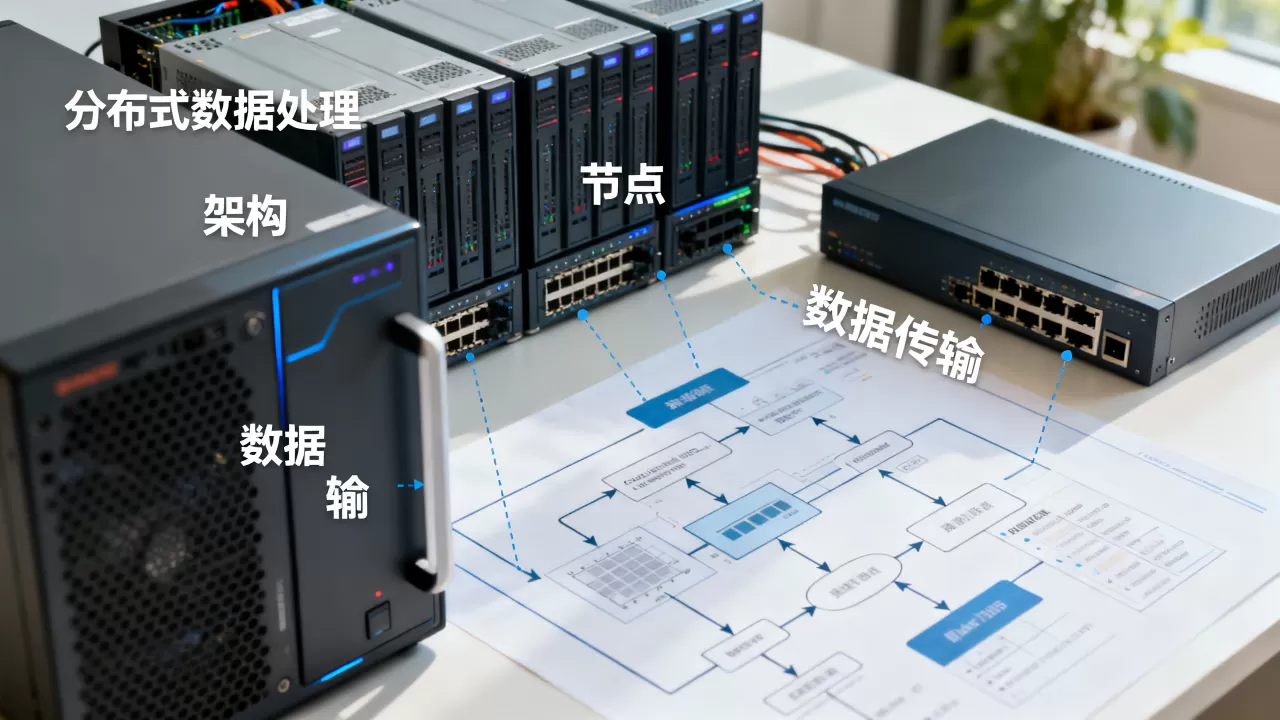
2026年,AI不再是独立的应用层,而是深度嵌入数据处理管道。
智能运维(AIOps)的普及
传统监控依赖人工配置阈值,容易误报或漏报,AI算法可自动学习正常波动模式,实时识别异常。
- 异常检测:自动发现慢查询、资源泄漏。
- 自动调优:根据负载动态调整并行度和缓存大小。
- 根因分析:快速定位故障节点,缩短MTTR(平均修复时间)。
存算分离架构的成熟
存储与计算资源解耦,使得两者可以独立扩展。
- 优势:计算资源可快速弹性伸缩,存储资源持久化保存,降低存储成本。
- 挑战:对网络带宽和延迟要求极高,需依赖高速RDMA网络。
分布式数据处理常见问题解答
分布式数据处理架构选型需要考虑哪些核心因素
选型需综合评估数据规模、实时性要求、团队技术能力及预算,对于实时性要求高且数据量大的场景,推荐Flink+Kafka组合;对于离线分析,Spark或Hive更为合适,若需兼顾两者,可考虑基于数据湖的批流一体方案。
如何解决分布式系统中的数据一致性问题
数据一致性取决于业务容忍度,强一致性场景可使用分布式事务(如2PC),但性能较低;多数互联网场景采用最终一致性,通过版本号或时间戳解决冲突,对于金融交易,需结合消息队列的重试机制和幂等性设计,确保数据准确无误。
分布式数据处理在中小企业中的实施成本如何
中小企业可优先采用云托管服务降低初始投入,通过Serverless架构,无需维护集群,按调用量付费,初期数据量小时,单节点处理即可,随业务增长逐步迁移至分布式架构,避免过度设计,据行业共识认为,云原生方案可使中小企业IT运维成本降低40%以上。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/465186.html

评论列表(1条)
分布式架构听着挺高大上,可我现在连个单机bug都调不明白…这技术对找工作真有用吗?好焦虑啊,感觉前途一片迷茫