查询MySQL慢日志的核心方法是开启slow_query_log并设置long_query_time,然后通过mysqldumpslow或直接查询mysql.slow_log表获取慢查询语句,对于纯真IP数据库的查询,这类IP范围查询常因缺少索引出现在慢日志中,优化的关键是建立复合索引或使用空间索引。
MySQL慢查询日志基础:为什么需要关注
慢查询日志是MySQL自带的一种性能诊断工具,它记录所有执行时间超过long_query_time阈值的SQL语句,以及未使用索引的查询,对于日常维护来说,慢日志是定位性能瓶颈最直接的入口,行业共识认为,在数据库性能优化中,慢查询日志的启用和分析应作为常规操作。


慢日志的两种记录方式
MySQL支持将慢查询记录到文件或表中,默认是文件形式,路径由slow_query_log_file指定,如果希望在SQL层面直接查询,可以设置log_output=TABLE,这样慢查询会写入mysql.slow_log表,方便用标准SQL检索,但表方式在高并发下会影响性能,多数情况下生产环境建议使用文件方式,分析时再导入表。
哪些查询会被记录
- 执行时间超过long_query_time(默认10秒,单位秒)。
- 未使用索引的查询(当log_queries_not_using_indexes开启时)。
- 如果设置了min_examined_row_limit,还会过滤行数低于该值的查询。
对于纯真IP数据库这类场景,典型的慢查询是SELECT location FROM ip_table WHERE ip_start <= ? AND ip_end >= ?,这类范围查询若没有索引,行数扫描可能达到百万级,很容易被记录。
纯真IP数据库查询中的慢查询场景
纯真IP数据库通常以IP起始和结束段表示地理范围,查询时需要匹配目标IP落在哪个区间,这种操作在MySQL中无法直接使用B+树索引的等值查找,只能通过范围条件或子查询实现。实际应用中,这类查询常出现在访问日志分析、用户地理位置统计等场景。 如果表数据量超过几十万行,且没有合理索引,慢日志中会频繁出现这类语句。
典型的慢查询特征
- 全表扫描:没有索引时,每条SQL都会遍历整张表。
- 索引选择不当:即使有索引,如果查询条件写为ip_start <= target AND ip_end >= target,MySQL可能只用到ip_start的索引,然后回表过滤ip_end,效率不高。
- 数据类型不匹配:IP地址用整数存储还是字符串,会影响比较性能,推荐使用INET_ATON转为整数,建立索引后查询效率提升明显。
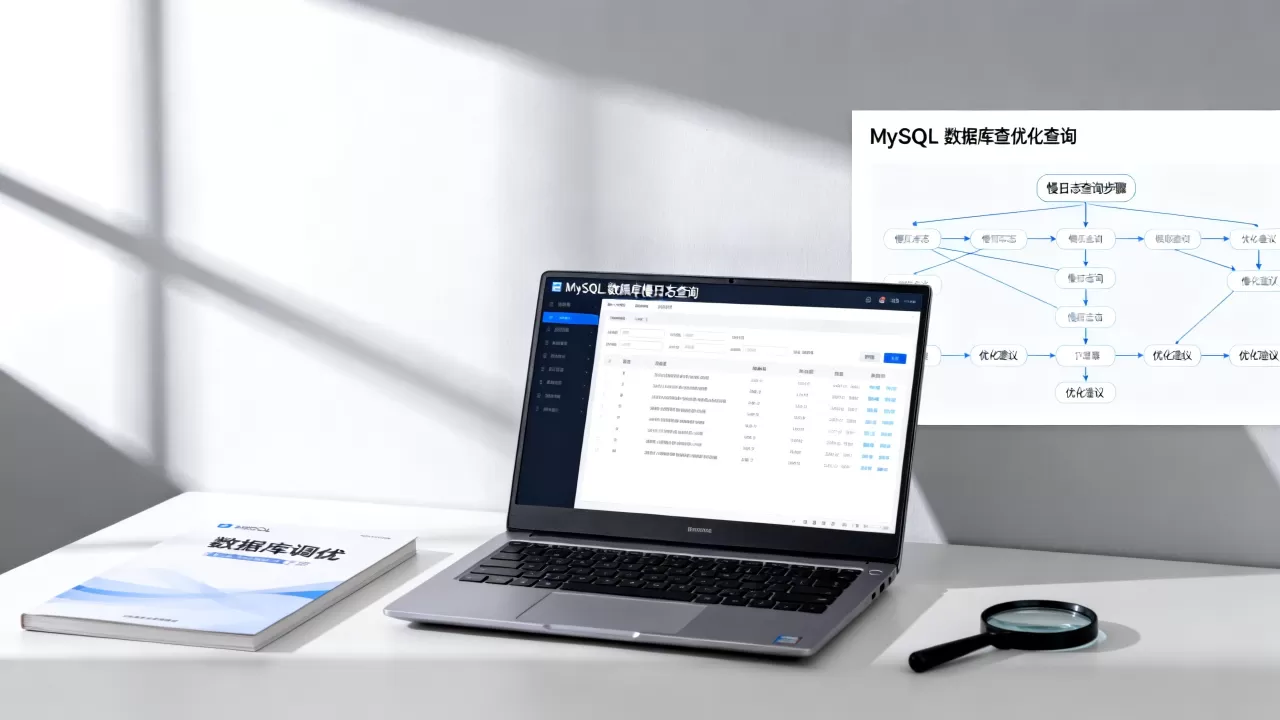
如何从慢日志中定位纯真IP查询
慢日志中的SQL文本会直接显示表名和条件,通过grep或mysqldumpslow过滤包含ip_start、ip_end、location等关键词的语句,可以快速锁定这类查询。近年来,许多DBA将慢日志导入到分析平台,用纯真IP库反向解析客户端IP来源,形成闭环诊断。
如何启用和查询MySQL慢日志
启用慢日志很简单,几行配置即可生效,但如何高效查询和分析慢日志,是很多用户关注的点,下面给出具体操作步骤。
启用慢日志的配置
在my.cnf或my.ini的[mysqld]段添加:
slow_query_log = ON
slow_query_log_file = /var/log/mysql/slow.log
long_query_time = 2
log_queries_not_using_indexes = ON
重启MySQL或执行SET GLOBAL动态开启,设置long_query_time为2秒,对大多数业务来说足够敏感,如果要查看当前运行值,用SHOW VARIABLES LIKE ‘%slow%’。
直接查询慢日志表
如果开启了log_output=TABLE,可以直接查询mysql.slow_log表:
SELECT FROM mysql.slow_log WHERE query_time > 2 ORDER BY query_time DESC;注意表结构包含start_time、user_host、query_time、lock_time、rows_sent、rows_examined、sql_text等字段。查询慢日志表本身也需注意性能,避免在高峰期全表扫描。
使用mysqldumpslow分析
这是MySQL官方提供的工具,语法简洁:
mysqldumpslow -s c -t 10 /var/log/mysql/slow.log参数说明:
- -s c:按查询次数排序,其他选项有t(按执行时间)、l(按锁时间)。
- -t N:显示前N条。
- 输出会自动聚合相似语句,方便查看慢查询的分布。
对于纯真IP数据库的查询,mysqldumpslow能直观显示这类语句的执行频率和总耗时。
用pt-query-digest深入分析
Percona Toolkit中的pt-query-digest功能更强大,支持按库、表、用户等维度统计,命令示例:
pt-query-digest /var/log/mysql/slow.log --limit=0.2输出会生成一份报告,包含每种查询的响应时间占比、CALL次数、时间分布等。业内专家指出,pt-query-digest是慢日志分析的首选工具,尤其适合在复杂环境中定位瓶颈。
针对纯真IP数据库查询的慢日志分析
当你拿到慢日志后,需要从海量记录中筛选出对纯真IP查询有影响的条目,以下是一个典型的分析流程。
第一步:过滤纯真IP相关查询
使用grep或awk提取包含纯真IP表名(比如ip_data)的慢日志行:
grep 'ip_data' /var/log/mysql/slow.log | head -20同时查看sql_text,确认查询模式。
SELECT city, area FROM ip_data WHERE ip_start <= 3491825689 AND ip_end >= 3491825689;如果频繁出现,说明该表可能是性能热点。
第二步:分析执行计划
将慢日志中的SQL提取出来,加上EXPLAIN查看执行计划:
EXPLAIN SELECT city, area FROM ip_data WHERE ip_start <= 3491825689 AND ip_end >= 3491825689;关注type列,如果为ALL或index,说明没有有效索引,rows列显示扫描行数,如果远大于预期,需要优化索引。
第三步:对比不同索引策略
对于IP范围查询,常见的索引优化方案有:
- 在ip_start和ip_end上分别建单列索引,但MySQL只可能用到其中一个。
- 建立复合索引(ip_start, ip_end),但范围查询导致第二个字段的索引效率不高。
- 如果使用MySQL 5.7以上版本,可以考虑使用空间索引(GEOMETRY类型),将IP范围存储为线段,用MBRContains查询。据统计,空间索引在IP范围查询上能提升数倍性能。
优化纯真IP数据库查询性能的实战建议
基于慢日志分析结果,可以采取以下具体措施来优化纯真IP数据库的查询,从根源上减少慢查询的产生。
索引优化:复合索引和空间索引
- 复合索引:在ip_start和ip_end上创建索引,但SQL写法需要调整,利用ip_start <= target ORDER BY ip_start DESC LIMIT 1,然后校验ip_end >= target,这种方式能利用索引,但逻辑稍复杂。
- 空间索引:将IP段转换为直线,插入GEOMETRY列并创建SPATIAL索引,查询时使用MBRContains新函数。空间索引是多数情况下推荐的方式,但需要额外维护字段。
表结构优化
- 将IP存储为无符号整数(UNSIGNED INT),而不是VARCHAR,比较速度更快。
- 分区表:按IP范围分区,减少单次查询扫描的数据量。
- 缓存:将纯真IP库加载到Redis或缓存表中,避免频繁查询MySQL。
查询语句优化
- 避免SELECT ,只取需要的字段。
- 将多次查询合并为一次,例如批量IP查询使用UNION或临时表。
- 调整业务逻辑,将IP查询从实时请求中剥离,改为异步批量处理。
监控和持续改进
设置定期任务分析慢日志,比如每天凌晨运行pt-query-digest,生成报告并邮件通知,如果发现纯真IP相关的查询再次变慢,需重新评估索引和业务量。长期坚持,慢日志会从问题清单变成优化清单。
关于纯真IP数据库和MySQL慢日志的常见问题
问:纯真IP数据库导入MySQL后,查询很慢,慢日志里全是这种查询,怎么办?
首先确认是否对ip_start和ip_end建立了索引,推荐使用空间索引或复合索引,其次检查IP字段是否使用整数存储,避免字符串比较,如果依然慢,考虑将数据加载到Redis的Sorted Set中,用ZRANGEBYSCORE实现O(logN)查询。
问:查询MySQL慢日志时,发现很多相同的IP查询语句,但执行时间不稳定,为什么?
可能是缓存命中率不同,或者服务器负载波动导致,重点看rows_examined和rows_sent,如果扫描行数大,说明索引未生效,建议开启log_queries_not_using_indexes,定位未使用索引的查询,对于纯真IP查询,确认索引是否被正确使用,避免隐式类型转换。
问:慢日志文件越来越大,如何管理和清理?
可以设置log_rotate或使用mysqladmin flush-logs来重新生成文件,在生产环境,建议将慢日志输出到文件,然后通过脚本定期归档到分析库,对于纯真IP查询,如果慢日志主要来自同一张表,优先优化该表而非依赖日志管理。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/584067.html