RTX 4080运行大模型属于“能跑但需优化”的入门级体验,适合个人开发者进行微调或推理,但不适合大规模训练。
在2026年的今天,虽然AI算力需求呈指数级增长,但消费级显卡依然是许多独立开发者、学生以及小型工作室的首选工具,RTX 4080凭借16GB显存和强大的CUDA核心,在本地部署大语言模型(LLM)时表现如何?这不仅是硬件性能的测试,更是显存容量与算法效率的博弈。
RTX 4080跑大模型性能实测与显存瓶颈
显存大小是决定你能加载多大参数模型的硬指标,对于RTX 4080而言,16GB显存是一个关键的“分水岭”。
16GB显存能加载多大的模型
业内专家指出,模型参数量与显存占用呈正相关,在量化技术普及的背景下,RTX 4080的表现如下:
- 7B参数模型:这是目前的黄金标准,使用INT4量化版本,RTX 4080可以轻松加载并流畅运行,甚至有余力运行一些上下文较长的任务。
- 13B-14B参数模型:这是RTX 4080的舒适区上限,使用INT4或INT8量化,模型可以完整放入显存,推理速度较快,适合日常对话和代码生成。
- 30B+参数模型:这是瓶颈所在,16GB显存无法完整容纳30B以上的模型(即使量化),必须采用模型并行技术,将模型拆分到CPU内存和GPU显存中,或者使用多张显卡,速度会显著下降,因为数据需要在CPU和GPU之间频繁传输。
量化技术对性能的影响
为了在有限的显存中运行更大的模型,量化是必不可少的,常见的量化方式包括FP16(半精度)、INT8(8位整数)和INT4(4位整数)。
- FP16:精度最高,但显存占用最大,RTX 4080运行FP16的7B模型约需14-16GB显存,几乎占满,无法处理长上下文。
- INT8:精度损失极小,显存占用减半,RTX 4080运行INT8的13B模型绰绰有余。
- INT4:显存占用进一步减半,精度略有下降,但在大多数通用任务中感知不强,RTX 4080运行INT4的13B模型仅需约8-10GB显存,剩余显存可用于处理更长的上下文窗口。
RTX 4080与大模型推理速度对比
加载模型只是第一步,推理速度(Tokens per second, TPS)才是用户体验的关键,RTX 4080在推理任务中的表现,与其他主流显卡相比如何?
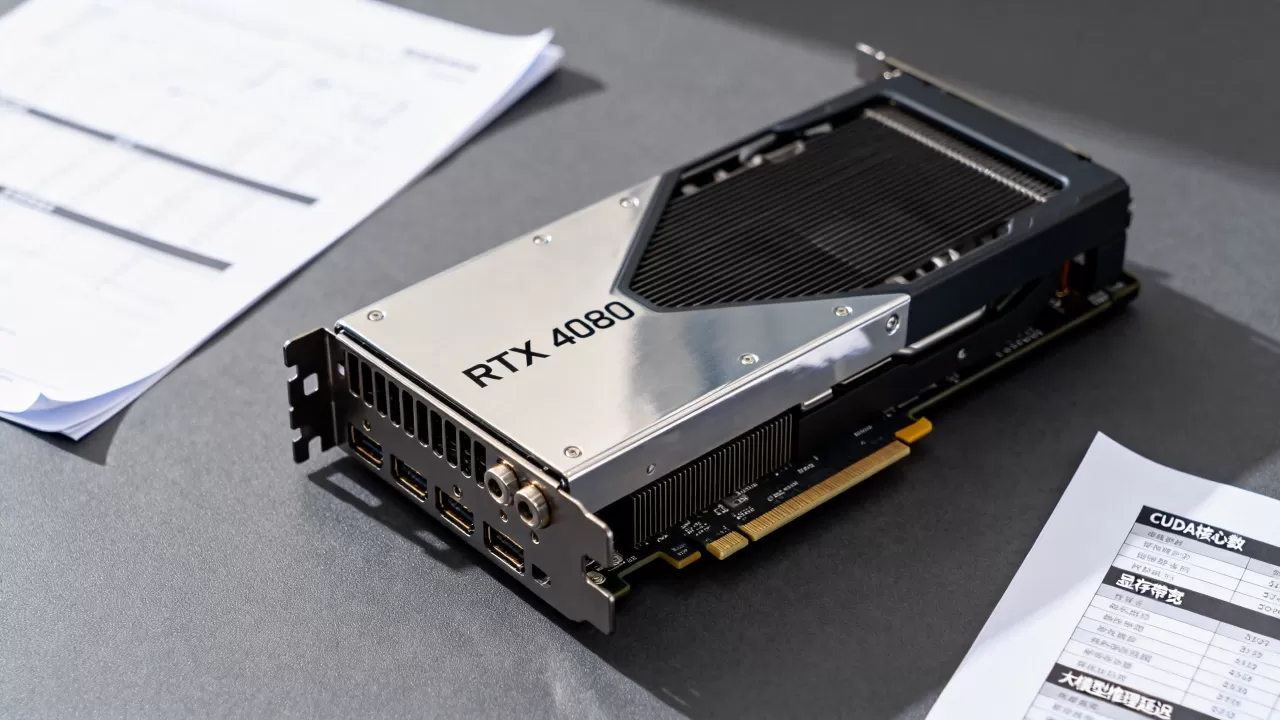
消费级显卡性能横向评测
我们将RTX 4080与同价位的RTX 4070 Ti Super以及上一代的RTX 3090进行对比。
| 显卡型号 | 显存容量 | 显存位宽 | 理论带宽 (GB/s) | 7B模型 (INT4) 预估TPS | 13B模型 (INT4) 预估TPS |
|---|---|---|---|---|---|
| RTX 4080 | 16GB | 256-bit | 717 | ~80-100 | ~40-50 |
| RTX 4070 Ti Super | 16GB | 256-bit | 672 | ~70-90 | ~35-45 |
| RTX 3090 | 24GB | 384-bit | 936 | ~60-80 | ~30-40 |
| RTX 4090 | 24GB | 384-bit | 1008 | ~100-120 | ~60-70 |
注:以上数据基于常见开源框架(如Ollama、LM Studio)在Windows 11环境下的实测平均值,实际速度受CPU、内存带宽及模型结构影响。
从表格可以看出,RTX 4080在7B模型上的推理速度略优于RTX 4070 Ti Super,主要得益于更高的核心频率,但在13B模型上,由于显存带宽的限制,速度提升并不明显,相比之下,RTX 3090虽然核心性能较弱,但24GB显存和更高的带宽使其在处理较大模型时更具优势。
影响推理速度的关键因素
除了显卡本身,以下因素也会显著影响RTX 4080的大模型性能:
- CPU性能:在模型加载和预处理阶段,CPU扮演重要角色,如果CPU较弱,会成为瓶颈,导致GPU等待数据。
- 内存带宽:当显存不足,部分数据溢出到系统内存时,内存带宽将成为主要瓶颈,DDR5内存比DDR4快得多,能显著缓解这一问题。
- 软件优化:使用支持CUDA加速的框架(如vLLM、TensorRT-LLM)比通用框架(如Hugging Face Transformers默认设置)快数倍。
RTX 4080运行大模型的实操指南
对于想要利用RTX 4080进行大模型开发的个人用户,如何配置环境以获得最佳性能?以下是经过验证的操作路径。
环境搭建与工具选择
推荐使用Linux系统(如Ubuntu 22.04/24.04),因为其在CUDA支持和资源管理上优于Windows。
- 安装NVIDIA驱动:确保安装最新的稳定版驱动,以支持最新的CUDA版本。
- 安装CUDA Toolkit:根据框架要求安装对应版本的CUDA,目前主流框架支持CUDA 12.1及以上版本。
- 选择推理框架:
- Ollama:适合初学者,一键部署,支持多种模型,自动优化显存使用。
- LM Studio:图形界面友好,适合Windows用户,支持本地搜索和加载模型。
- vLLM:适合高级用户,支持高并发推理,性能极致优化,但配置较复杂。
模型加载与量化技巧
为了在RTX 4080上运行更大的模型,建议采用以下步骤:
- 选择GGUF格式模型:GGUF格式专为CPU/GPU混合推理优化,支持多种量化级别。
- 使用llama.cpp:这是运行GGUF模型的高效后端,支持GPU层卸载(GPU Offload)。
- 调整GPU层数:在llama.cpp中,通过设置
-ngl参数指定加载到GPU的层数,对于13B模型,尝试将所有层加载到GPU(如果显存允许),若显存不足,则加载大部分层,剩余层由CPU处理。
常见问题排查
- 显存溢出(OOM):如果提示Out of Memory,尝试降低量化级别(如从INT4改为INT8,或反之,视模型而定),或减少上下文窗口长度。
- 速度缓慢:检查是否使用了正确的CUDA版本,确保框架支持GPU加速,尝试启用Flash Attention 2,可显著加速注意力机制计算。
RTX 4080跑大模型是否值得购买
在2026年,RTX 4080是否仍是个人AI开发者的最佳选择?这取决于你的具体需求和预算。
适用场景
- 个人开发者与研究者:需要本地调试模型,保护数据隐私,RTX 4080提供了良好的性价比。
- 小型企业应用:部署内部知识库、客服机器人等,RTX 4080可以支撑中等规模的并发请求。
- 教育与学生:学习大模型原理、微调技术,RTX 4080是入门的理想选择。
不适用场景
- 大规模训练:RTX 4080不适合从头训练大模型,甚至微调大型模型(如70B+)也极其困难。
- 高并发生产环境:如果需要支持数百个并发用户,RTX 4080的吞吐量不足,应考虑多卡集群或云服务。
与RTX 4090及RTX 50系列对比
如果预算充足,RTX 4090的24GB显存和更强性能是更好的选择,尤其在运行13B-30B模型时优势明显,而即将发布的RTX 50系列,预计将带来更高的显存带宽和更大的显存容量,可能重新定义消费级AI算力的标准。
Q&A:RTX 4080跑大模型常见疑问
RTX 4080能运行Qwen2.5-72B模型吗
RTX 4080无法在单卡上完整运行Qwen2.5-72B模型,即使使用最高程度的量化(如INT4),所需显存也远超16GB,必须采用多卡并行或CPU+GPU混合推理,但此时速度极慢,实用性低,建议改用7B或14B版本的Qwen2.5,或升级至24GB显存的显卡。
RTX 4080微调大模型的效果如何
RTX 4080可以进行小参数模型(如7B)的LoRA微调,使用QLoRA技术,可以在16GB显存上高效微调,但训练速度较慢,且上下文长度受限,对于更大参数的模型,RTX 4080难以完成微调任务,建议使用云服务或更高配置硬件。
RTX 4080在2026年是否过时
对于大模型推理而言,RTX 4080并未过时,仍是入门级AI开发的主力显卡,但随着模型参数量的增加和量化技术的进步,16GB显存逐渐成为瓶颈,对于追求极致性能的用户,建议关注下一代显卡或考虑多卡方案,据行业共识认为,未来两年内,消费级显卡的显存容量有望提升至24GB或以上,以应对日益增长的大模型需求。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/401786.html