FPTree算法通过构建频繁模式树,以极低的内存开销和单次扫描数据库的效率,成为解决海量数据关联规则挖掘的核心技术,尤其适合处理高密度、高维度的交易数据场景。
在数据挖掘的浩瀚海洋中,如何从数以亿计的交易记录中快速提炼出有价值的商品关联关系,一直是零售、电商及金融风控领域的痛点,传统的Apriori算法虽然经典,但在面对大数据量时,其产生的候选集爆炸问题往往导致计算效率低下,甚至引发系统崩溃,相比之下,FPTree(Frequent Pattern Tree,频繁模式树)算法通过一种独特的树形结构,将复杂的数据库压缩为紧凑的节点网络,实现了“一次扫描,全局挖掘”的高效操作,这种技术不仅大幅降低了I/O开销,更在处理实时推荐系统时展现出惊人的速度优势,成为现代数据智能基础设施中不可或缺的一环。
FPTree算法的核心原理与架构解析
要理解FPTree为何高效,首先需要拆解其内部构造逻辑,它并非简单地存储原始数据,而是通过一种层级化的方式,将频繁项集以路径的形式组织起来,这种结构类似于一个共享前缀的字典树,但专门针对频繁项进行优化。
构建流程详解
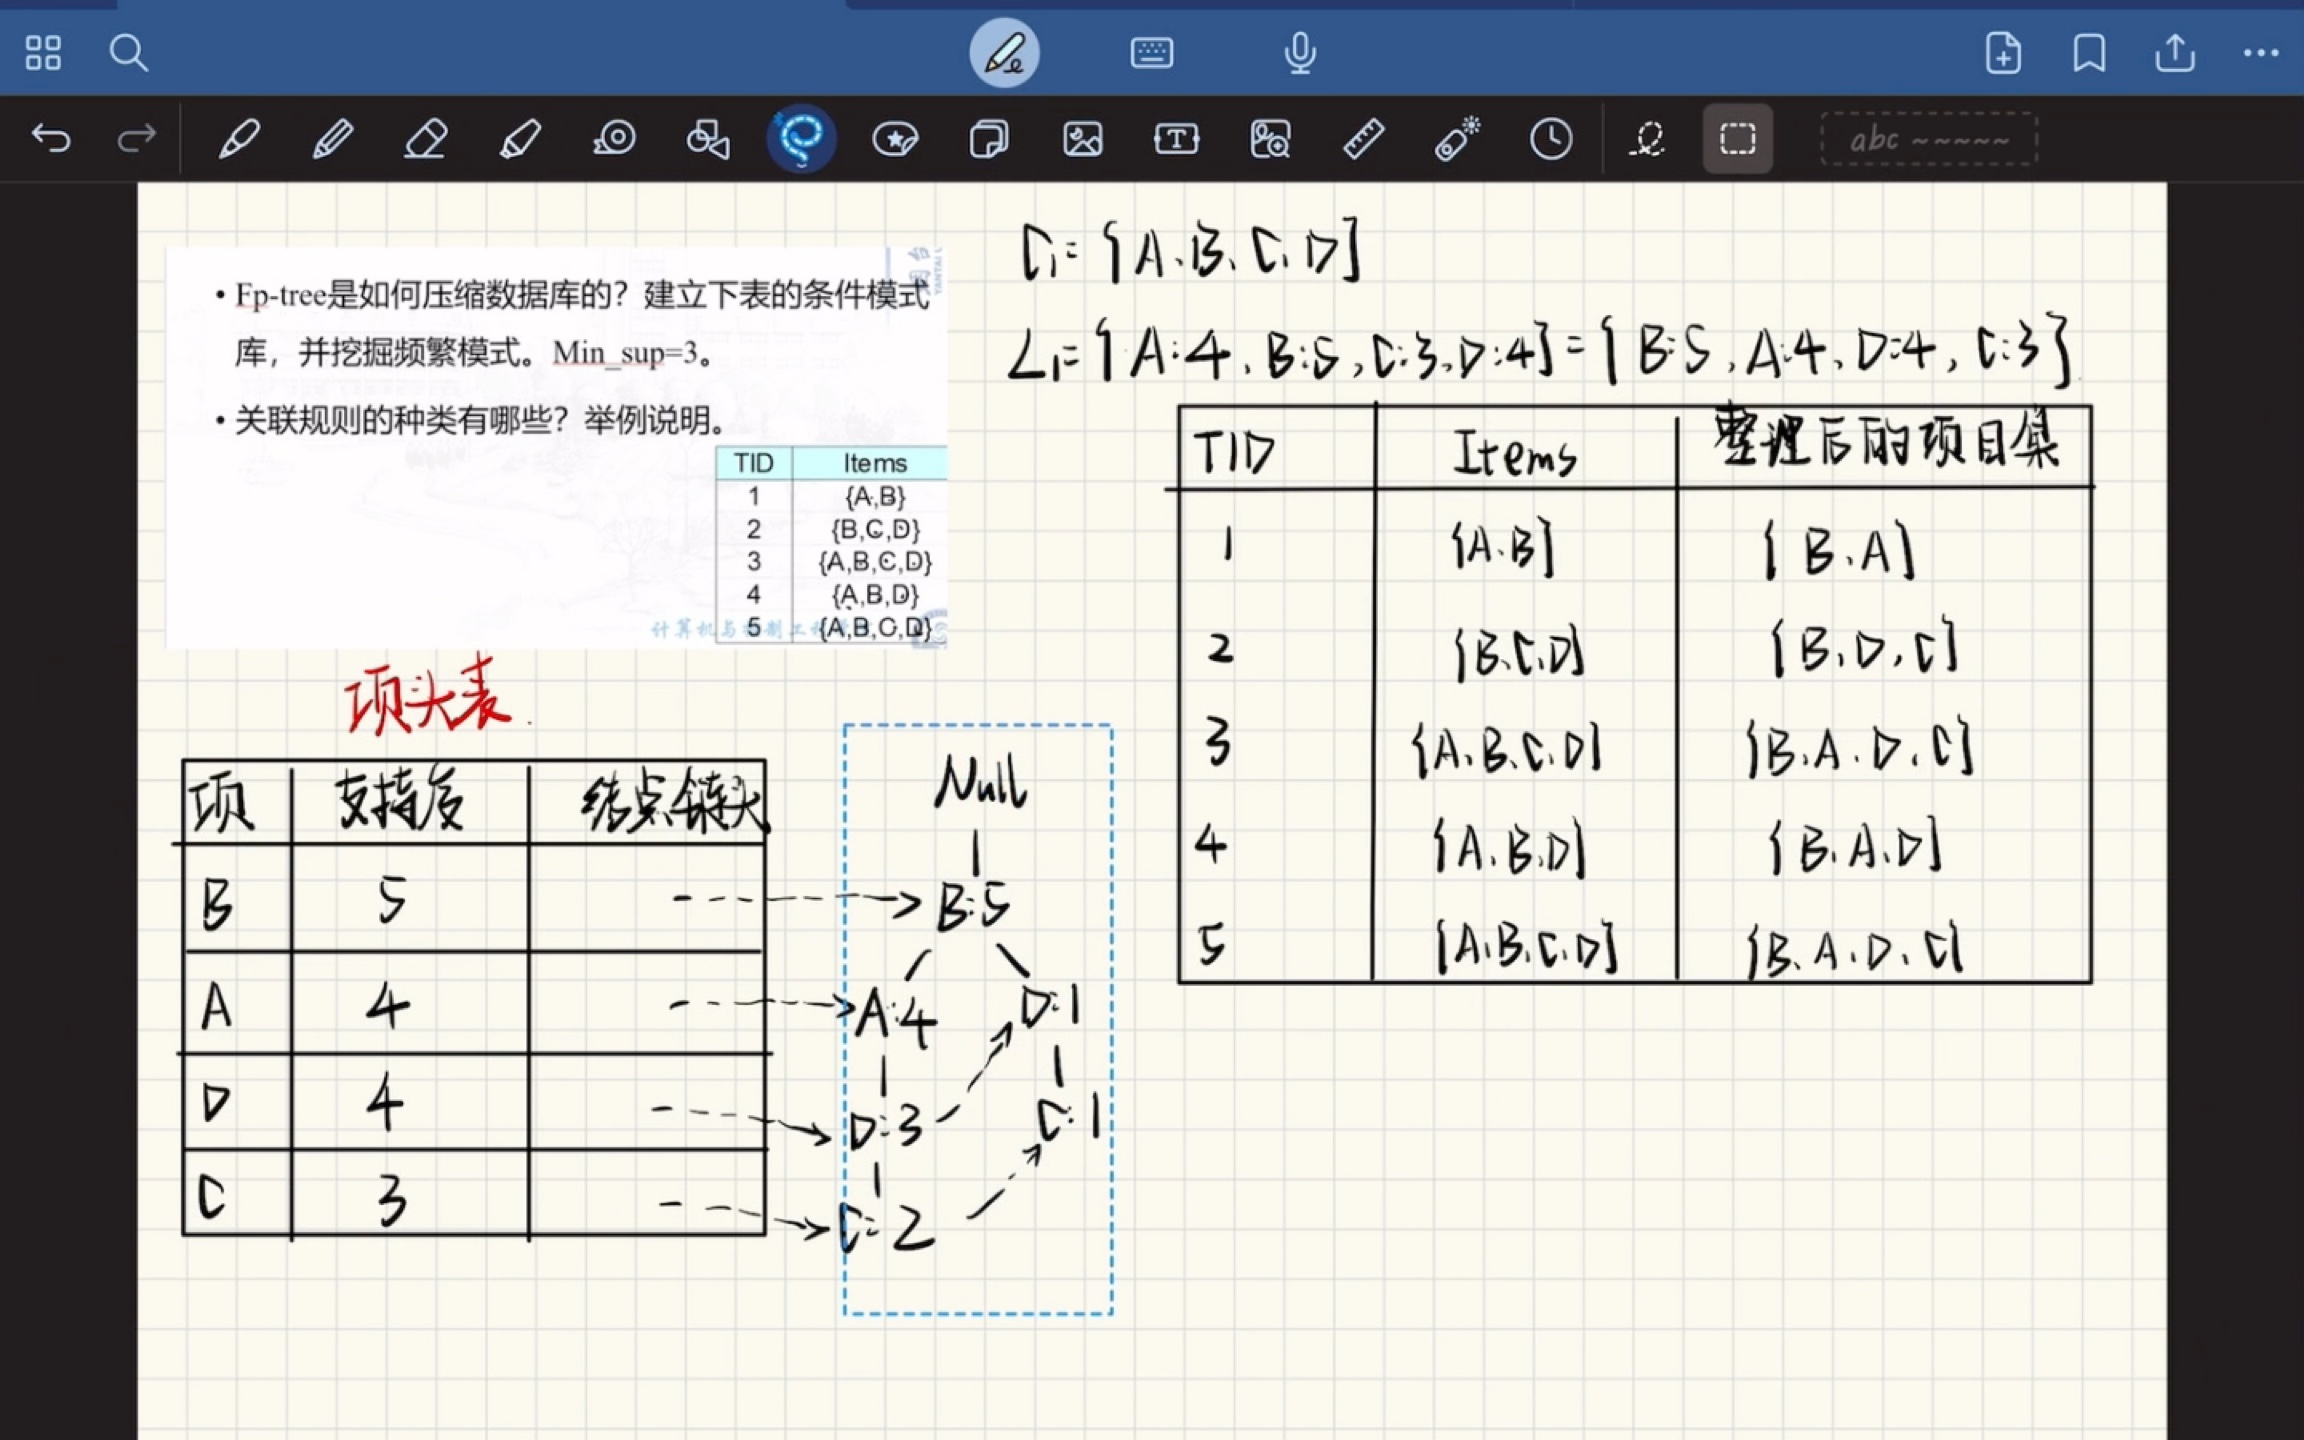
构建FPTree的过程可以概括为两个主要阶段:扫描统计与树构建。
第一阶段:全局扫描与阈值过滤
算法首先需要对原始事务数据库进行一次完整的扫描,在这次扫描中,系统会统计每个单项(Item)出现的频率,随后,根据预设的最小支持度(Min-Support)阈值,剔除那些出现次数不足的“低频项”,这一步至关重要,因为它直接决定了后续树结构的规模,业内专家指出,合理的阈值设定能减少较大比例的无效节点,从而显著降低内存占用。
第二阶段:有序插入与路径共享
在确定频繁项后,算法会对每个事务中的项按照全局频率降序排列,从根节点开始,逐个插入这些有序项,如果当前路径上已存在相同的项节点,则增加其计数;如果不存在,则创建新节点并链接,这种“共享前缀”机制是FPTree节省空间的核心,如果“牛奶”和“面包”经常一起购买,它们在树中的路径会高度重合,避免了重复存储。
条件模式基与递归挖掘
树构建完成后,挖掘工作便转向递归过程,对于树中的每一个频繁项,算法会寻找其对应的“条件模式基”(Conditional Pattern Base),这相当于从叶子节点回溯到根节点,收集所有包含该节点的路径及其计数,随后,基于这些条件模式基,构建一个小型的“条件FPTree”,并在其上递归执行相同的挖掘过程,这种分而治之的策略,使得算法能够并行处理不同的分支,极大提升了计算效率。
FPTree与Apriori的性能对比及选型建议
在实际业务落地中,选择何种算法往往取决于数据规模与业务需求,许多企业在初期尝试使用Apriori,但在数据量增长后迅速遭遇瓶颈,深入理解两者的差异对于技术选型至关重要。
计算效率与资源消耗对比
Apriori算法基于“向下封闭性”原理,需要多次扫描数据库以生成候选集,随着数据维度的增加,候选集的数量呈指数级增长,导致CPU和内存资源被大量消耗,而FPTree仅需两次扫描:一次用于统计频率,一次用于构建树,在挖掘阶段,它完全在内存中的树结构上进行,无需再次访问磁盘,据统计,在处理百万级以上的交易记录时,FPTree的执行速度通常比Apriori快数倍至数十倍,尤其是在支持度阈值较低的情况下,优势更为明显。
适用场景与局限性分析
尽管FPTree性能卓越,但它并非万能钥匙。
- 适用场景:适用于内存充足、数据量巨大且需要实时或近实时反馈的场景,如电商实时推荐、银行反欺诈监控。
- 局限性:如果数据稀疏或支持度阈值设置过高,可能导致树结构过于庞大,反而增加内存压力,对于非事务型数据(如文本序列),FPTree的直接适用性较差,需先进行特征工程转换。
如何选择合适的关联规则挖掘工具
对于中小型企业或数据量在万级以下的场景,Apriori因其逻辑简单、易于实现,仍是不错的入门选择,但对于追求高性能的大数据平台,FPTree及其变种(如FP-Growth)是更优解,主流的大数据框架如Spark MLlib已内置了高效的FP-Growth实现,开发者可直接调用API进行分布式计算,无需从头造轮子。
FPTree在实际业务中的落地实操指南
理论的价值在于实践,下面我们将通过具体的操作步骤,展示如何在实际项目中部署FPTree算法,以解决典型的关联规则挖掘问题。
数据预处理的关键步骤
原始数据往往杂乱无章,直接输入算法会导致结果失真。
- 数据清洗:去除空值、异常值和重复记录,在电商数据中,需过滤掉测试订单或退货订单。
- 事务格式化:将数据转换为“事务ID-商品列表”的格式,确保每个事务中的商品项是唯一的,且顺序无关(顺序将在构建树时处理)。
- 编码转换:如果商品名称为中文或长字符串,建议转换为整数ID,以提升哈希查找效率。
参数调优与阈值设定
支持度(Min-Support)和置信度(Min-Confidence)是两个核心参数。
- 支持度:决定哪些项被视为“频繁”,阈值设得太低,会产生海量规则,噪音极大;设得太高,可能遗漏潜在的重要关联,建议从01或05开始测试,根据业务容忍度调整。
- 置信度:决定规则的可靠性,高置信度意味着强关联,但可能规则数量较少,通常结合提升度(Lift)一起分析,提升度大于1才表示正相关。
代码实现示例(基于Python/Spark)
在实际开发中,推荐使用Spark MLlib中的FPGroup类,以下是一个简化的操作路径:
环境准备
确保已安装PySpark库,并配置好Hadoop环境。
核心代码逻辑
from pyspark.ml.fpm import FPGrowth
# 1. 加载数据,格式为DataFrame,列名为'items',值为列表
df = spark.read.csv("hdfs://path/to/data", header=True, inferSchema=True)
# 2. 初始化FP-Growth模型
fpGrowth = FPGrowth(itemsCol="items", minSupport=0.01, minConfidence=0.1)
# 3. 训练模型
model = fpGrowth.fit(df)
# 4. 获取频繁项集
frequentItemsets = model.freqItemsets
# 5. 获取关联规则
rules = model.generateAssociationRules(minConfidence=0.1)
# 6. 展示结果
rules.show()
通过上述步骤,你可以快速获得一组高置信度的关联规则。“购买尿布的用户有80%的概率也购买啤酒”,这类洞察可直接用于货架摆放优化或捆绑销售策略。
FPTree常见问题解答(Q&A)
FPTree与Apriori相比,内存占用情况如何?
FPTree在内存占用上具有显著优势,因为它将数据压缩为树结构,避免了Apriori中庞大的候选集生成过程,如果数据极度稀疏或支持度极低,树节点可能过多,导致内存峰值升高,一般情况下,对于中等密度数据,FPTree的内存效率远高于Apriori。
如何处理非结构化文本数据的关联挖掘?
FPTree主要针对事务型数据(如购物篮),对于文本数据,需先进行分词、去停用词、TF-IDF加权等预处理,将文本转化为“文档-关键词”的事务形式,然后再应用FPTree,也可结合NLP技术提取实体关系,转化为结构化事务后再进行挖掘。
FPTree算法在实时推荐系统中的延迟表现如何?
在实时推荐场景中,FPTree的离线训练部分可能耗时较长,但在线推理部分极快,通常采用“离线训练+在线更新”的架构:夜间批量训练生成规则库,白天在线服务直接查询规则库进行推荐,对于动态变化的数据,可采用增量式FPTree变种,将更新延迟控制在秒级至分钟级,满足大多数实时业务需求。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/463189.html