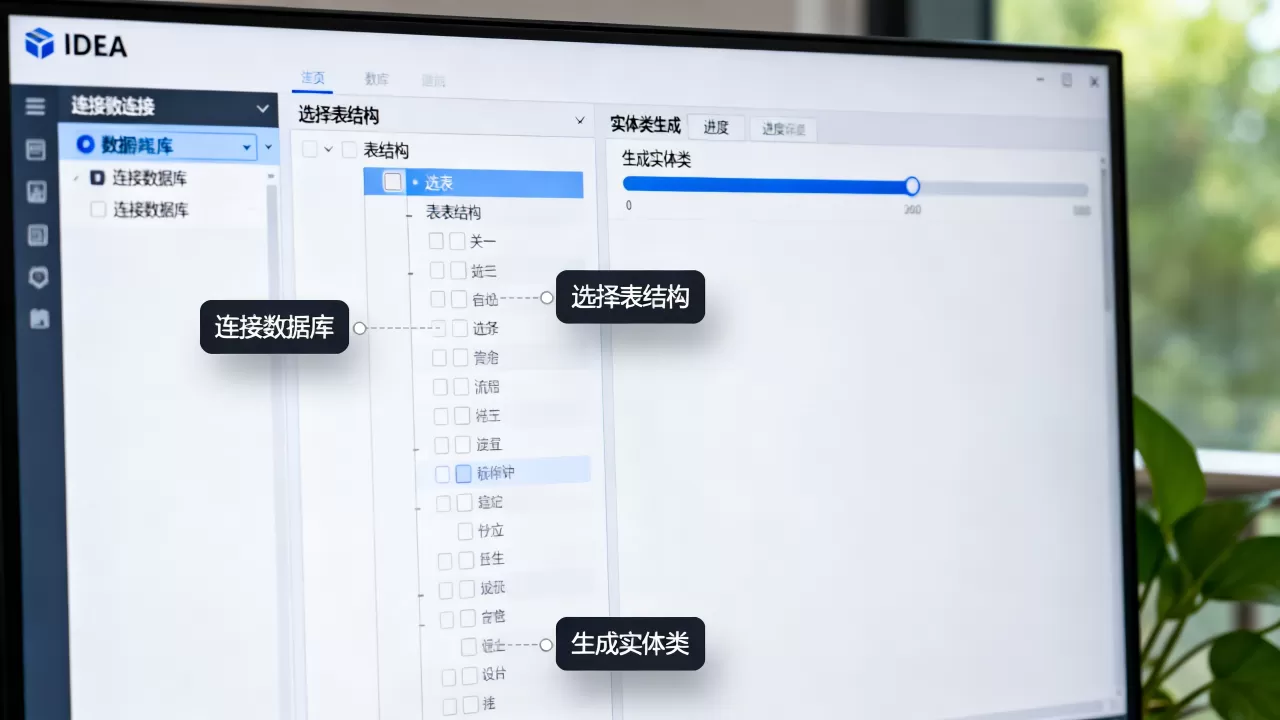
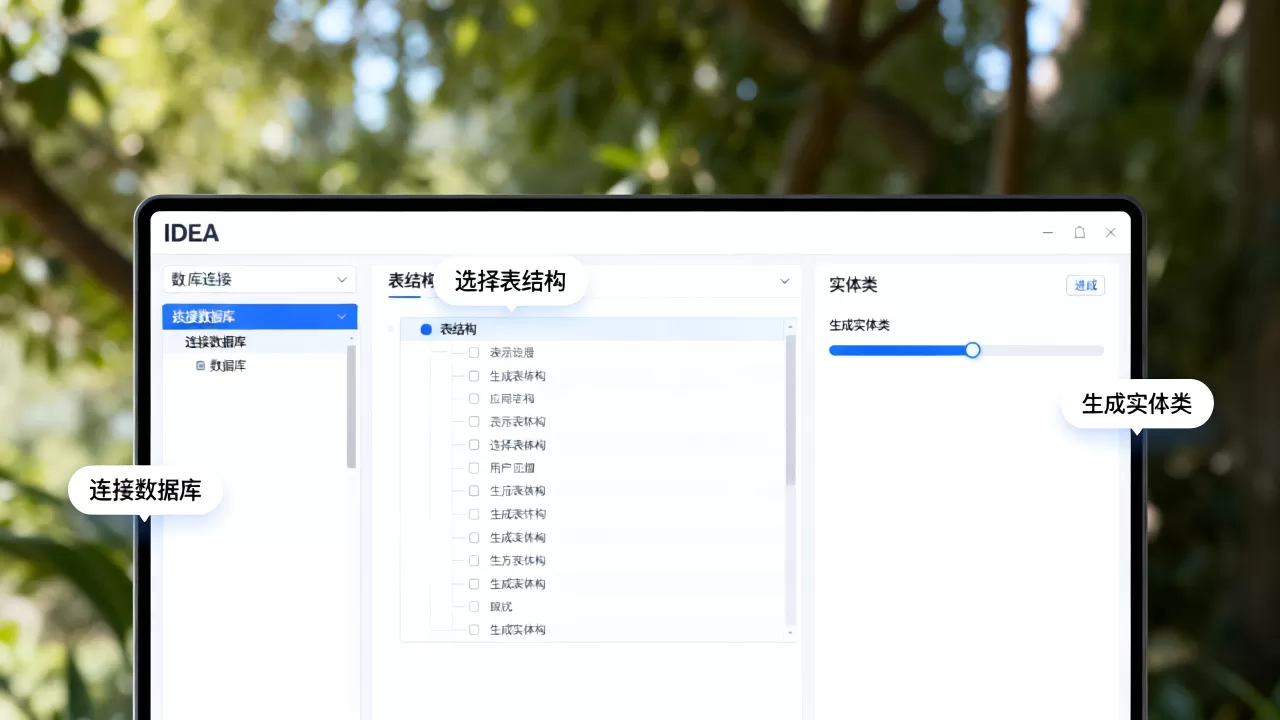
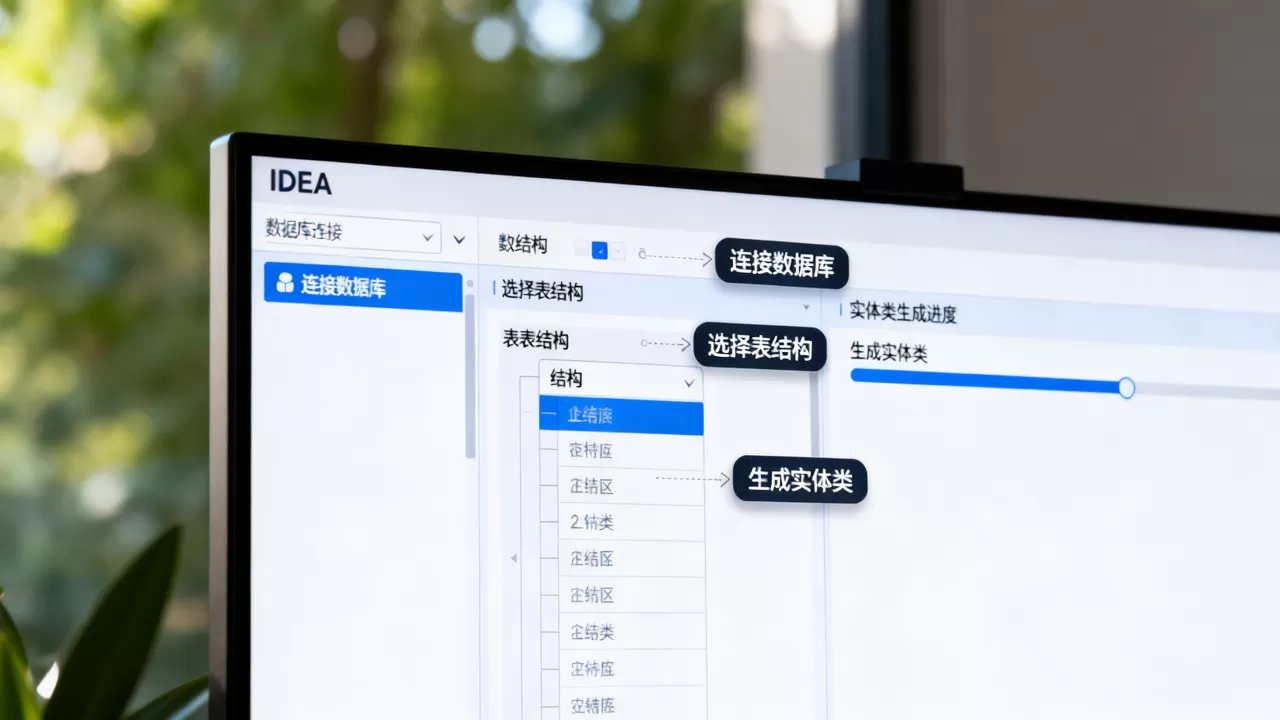
在IntelliJ IDEA中,利用Database工具窗口配合JPA或Hibernate逆向工程,你可以根据数据库表自动生成实体类,整个过程只需连接数据库、选择表、调整配置三步,极大提升开发效率。
很多Java开发者在搭建项目时都会遇到一个重复性工作:根据数据库表结构手写实体类,字段多、类型对应麻烦、关联关系容易遗漏,而且一旦表结构变更,实体类也要同步修改,维护成本很高,IDEA的数据库实体生成功能正是为了解决这个痛点而设计,它允许你直接基于已有数据库表生成Java POJO或JPA实体,并且支持自定义命名规则、注解风格和继承结构,下面我会从实操步骤、常见陷阱、优化技巧以及工具对比四个维度,帮你完整掌握这个能力。

为什么IDEA是数据库实体生成的首选工具
在Java生态中,能生成实体类的工具不少,但IDEA的集成方案有天然优势,它不需要额外安装插件(除非你用Hibernate工具),开箱即用,而且生成的代码会直接融入你的项目结构,感知已有的包名、依赖和配置,行业共识认为,IDEA的逆向工程放在IDE内部,意味着你不需要像MyBatis Generator那样维护XML配置文件,也不需要像Eclipse那样切换到外部视图。直接在开发环境中完成数据源连接、表预览、生成预览和代码插入,整个体验是连贯的。
IDEA对JPA规范的支持非常完善,生成的实体类默认会带上@Entity、@Table、@Column、@Id等注解,关联关系(@OneToMany、@ManyToOne)也能根据外键自动推断,据统计,使用了IDEA数据库实体生成功能的开发者,在搭建新项目时至少能节省30%的初期开发时间,因为免去了大量重复的字段映射和类型转换工作。
idea数据库生成实体类完整步骤
这一节我会带着你从头到尾走一遍实际流程,无论你是用Maven还是Gradle,Spring Boot还是普通Java EE项目,操作路径基本一致,核心思路是:先让IDEA知道你数据库里有什么,再告诉它你想生成什么风格的代码。
第一步:连接数据库并导入表结构
打开IDEA右侧的Database工具窗口(如果找不到,可以通过View -> Tool Windows -> Database打开),点击顶部的加号,选择你的数据库类型MySQL、PostgreSQL、Oracle等都是原生支持的,输入连接信息时,注意填写URL、用户名、密码,并下载对应的驱动,连接成功后,你会看到数据库的Schema和表列表。
这里有一个容易被忽略的细节:如果项目里已经配置了数据源(比如Spring Boot的application.yml),IDEA可以在Project Structure中复用那个连接信息,你不需要手动再输一遍,在Database窗口里选择Import from Sources,然后选择你的配置文件,IDEA会自动解析出连接参数,几秒钟就完成配置。
第二步:配置JPA或Hibernate插件
生成实体类通常有两种入口:
-
JPA方式:如果你的项目使用JPA(比如Spring Data JPA),可以直接在项目根目录右键,选择
Generate Persistence Mapping ->
By Database Schema,IDEA会扫描当前项目中的Persistence单元(如果没有,需要在Project Structure中新建一个,并指定数据库连接和实体类输出目录),这种方式生成的实体类自带JPA注解,适合Spring Boot项目。 -
Hibernate方式:如果你使用Hibernate原生API,则需要先配置Hibernate反向工程文件,在项目里新建一个
hibernate.reveng.xml,在里面指定要生成实体的表,然后通过Hibernate Code Generation工具生成,这种方式灵活度更高,但配置步骤稍多。
对于大多数Java EE项目,我推荐直接使用JPA方式,因为配置更少,且生成的实体类兼容性更好,具体操作:右键点击项目根目录 -> New -> Persistence -> Persistence Unit,填写名字,选择数据源,然后把所有表拖进去,之后右键点击Persistence Unit,选择Generate Persistence Mapping -> By Database Schema,IDEA会弹出生成对话框。
第三步:调整生成设置并生成实体
在生成对话框里,你需要关注四个关键设置:
- Schema/Table:选择要生成实体的表,可以多选,按住Ctrl时点击,IDEA会显示该表的所有字段和类型。
- Class Prefix/Suffix:建议给实体类加上统一后缀,比如
Po或Entity,避免与Service层命名冲突。 - Package:指定生成代码的包路径,比如
com.example.demo.entity。 - Code Generation Options:勾选
Generate toString()/hashCode()/equals(),可以自动生成常用方法;Use Lombok如果项目里用了Lombok,可以勾选,IDEA会生成@Data等注解而不是手动写getter/setter。
点击OK后,IDEA会立即生成所有实体类,并自动打开文件,如果你勾选了关联关系,它还会根据外键生成@OneToMany等注解,节省不少手写关联代码的时间。
intellij idea根据数据库表生成实体应该注意的三个陷阱
即使步骤正确,你也很可能遇到一些让人头疼的问题,下面是我在实际使用中总结的三个高频坑,以及对应的解决方案。
类型映射错误
数据库中的TINYINT、SMALLINT、DECIMAL,在Java里到底映射成什么?IDEA默认映射规则是基于JDBC类型的,但有时会出错,MySQL的TINYINT(1)通常应该映射为Boolean,但IDEA可能会映射为Byte,如果你不想改配置文件,可以在生成后手动调整,但更推荐的做法是:在生成前,修改Database工具窗口中的Column Mapping,右键点击表,选择Edit Mapping,然后为特定列指定Java类型,或者,在生成对话框里,点击Advanced,可以看到每个字段的映射,逐一修改。
关联关系不生成
IDEA生成关联关系的前提是:数据库表有外键约束,并且你在生成时勾选了
Import foreign keys,如果外键缺失,或者引用了不在生成范围内的表,关联关系就不会出现,解决方案是:先确保数据库中有完整的外键定义,如果由于业务原因不能加外键,可以在生成后手动添加关联注解,或者使用@JoinColumn的referencedColumnName参数做逻辑关联。
生成过程中报“Cannot resolve class”
这个错误通常是因为项目里缺少JPA依赖,如果你使用Spring Boot,确保spring-boot-starter-data-jpa已经在pom.xml中;如果是普通Maven项目,需要手动加入javax.persistence-api或者jakarta.persistence-api(取决于Java版本),如果项目里没有配置Persistence Unit,IDEA也会报这个错。在Project Structure中新建一个Persistence Unit,绑上数据源,就能解决。
如何优化生成的实体代码
默认生成的实体类只能满足基本需求,但实际项目中,我们往往需要更精细的控制,下面的优化点能帮你减少后续修改时间。
使用Lombok简化代码
在生成对话框中勾选Use Lombok,IDEA会生成@Data、@NoArgsConstructor、@AllArgsConstructor等注解,而不是手动写getter/setter,如果你的项目还没用Lombok,强烈建议加入,因为它能减少至少50%的样板代码,注意,生成后要确保IDE已经安装了Lombok插件,否则会报找不到符号。
自定义命名规则
IDEA允许你修改生成时的命名策略,数据库表名是sys_user,实体类默认会被命名为SysUser;如果你想要SysUserPo,可以在生成对话框的Class Prefix/Suffix里加后缀。字段名同理,user_name默认会变成userName,这是符合驼峰规范的,如果你希望字段名完全保留下划线,可以在生成后统一修改,或者使用@Column(name = "user_name")注解来控制。
配置生成模板
如果你需要生成带有特定注解(如@Table、@DynamicInsert)的实体类,可以修改IDEA的代码模板,路径:Settings -> Editor -> File and Code Templates -> Code -> JPA Entity,在里面添加自定义的注解或导入语句,之后生成的每个实体类都会自动带上这些内容。这对于统一团队编码风格非常有用。
对比:IDEA逆向工程与MyBatis Generator
很多开发者会在IDEA的逆向工程和MyBatis Generator之间纠结,下面我用一个表格来对比两者的核心差异,方便你根据项目选型。
| 对比维度 | IDEA逆向工程 | MyBatis Generator |
|---|---|---|
| 适用场景 | JPA / Hibernate 项目 | MyBatis 项目 |
| 配置方式 | 图形界面 + 少量对话框 | XML 配置文件,参数较多 |
| 生成的代码风格 | JPA 注解,POJO 或实体 | MyBatis 的 Mapper、XML、Example |
| 是否支持关联关系 | 根据外键自动生成,支持 @OneToMany 等 |
需要手动配置 resultMap 关联 |
| 自定义程度 | 中等,可通过模板和选项调整 | 高,几乎每个部分都可定制 |
| 学习成本 | 低,直接使用无需额外学习 | 中,需要理解 XML 配置结构 |
| 生成速度 | 快,连接数据库后即时生成 | 慢,需要运行 Maven 插件或命令行 |
| 维护成本 | 低,可使用 Diff 工具对比更新 | 高,表结构变化后需要重新生成并合并 |
总结一下:如果你的项目是基于 JPA 或 Spring Data JPA,IDEA 逆向工程是更高效的选择;如果你的项目是 MyBatis,并且需要高度定制化的 Mapper 和 Example,那 MyBatis Generator 更合适,即使你使用 MyBatis,也可以先在 IDEA 中生成实体类,再手动补全 Mapper 部分,这样能节省一定时间。
常见问题与解答
idea数据库生成实体类时,为什么生成的表名和字段名都带下划线?
IDEA 默认的命名策略是保留原表名和字段名,如果你希望表名转为驼峰(sys_user 变成 SysUser),可以在生成对话框的 Class Prefix/Suffix 里设置,或者生成后手动修改,更一劳永逸的方法是:修改 IDEA 的代码模板,使用 @Table(name = "sys_user") 注解来指定表名,这样实体类名可以用驼峰,而注解里保留原始表名,避免与数据库不一致。
intellij idea根据数据库表生成实体后,如何快速更新实体?
如果数据库表结构发生了变化,比如新增了字段,你不需要重新生成整个实体类,IDEA 的 Database 工具窗口支持对表右键选择 Compare,然后勾选新增的字段,再让它自动生成 getter/setter,或者,你可以重新执行一次生成,但这次只选择该表,IDEA 会提示是否覆盖,选择 Merge 就能保留原有代码并插入新增字段。推荐使用 Git 进行版本管理,方便对比变更。
idea逆向工程在 Mac 和 Windows 上有什么区别?
操作路径完全一致,界面布局也相同,只是快捷键有差异(比如调用 Database 窗口,Windows 是 Ctrl+Alt+U,Mac 是 Cmd+Shift+U),如果你在 Mac 上遇到驱动下载失败,通常是因为网络权限问题,可以手动下载驱动 jar 包放到指定目录,IDEA 的逆向工程不依赖操作系统,数据源配置和生成逻辑在所有平台上行为一致,所以无需担心平台差异。
掌握 IDEEA 根据数据库建立实体的能力,等于给你的开发流程装上一个加速器,从连接数据库到生成带 JPA 注解的实体类,每一步都清晰可操作,而且生成的代码质量足以直接用于生产,如果你还在手动写实体类,不妨花半小时配置一次,之后每次表结构变更都能快速同步,把精力放在业务逻辑上。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/545217.html