大模型部署采用发布订阅模式,核心在于通过消息队列实现推理服务与业务逻辑的解耦,从而在应对高并发请求时显著提升系统的稳定性与扩展性。
当企业开始将大语言模型(LLM)落地到实际业务中时,往往会发现直接调用API或本地部署单节点服务难以应对流量洪峰,发布订阅模式(Pub/Sub)就像是一个高效的邮局系统,业务方不需要知道模型具体在哪里运行,只需要把请求“投”进信箱,而模型服务则从信箱中“取”件处理,这种架构不仅解决了瞬时流量冲击的问题,还为后续的模型迭代、负载均衡提供了极大的灵活性。
为什么大模型部署需要发布订阅架构
在大模型应用场景中,推理过程通常耗时较长,且资源消耗巨大,如果采用传统的同步调用模式,前端页面或业务系统必须等待模型返回结果,这会导致大量连接处于挂起状态,极易引发服务器资源耗尽。
解耦业务逻辑与推理计算
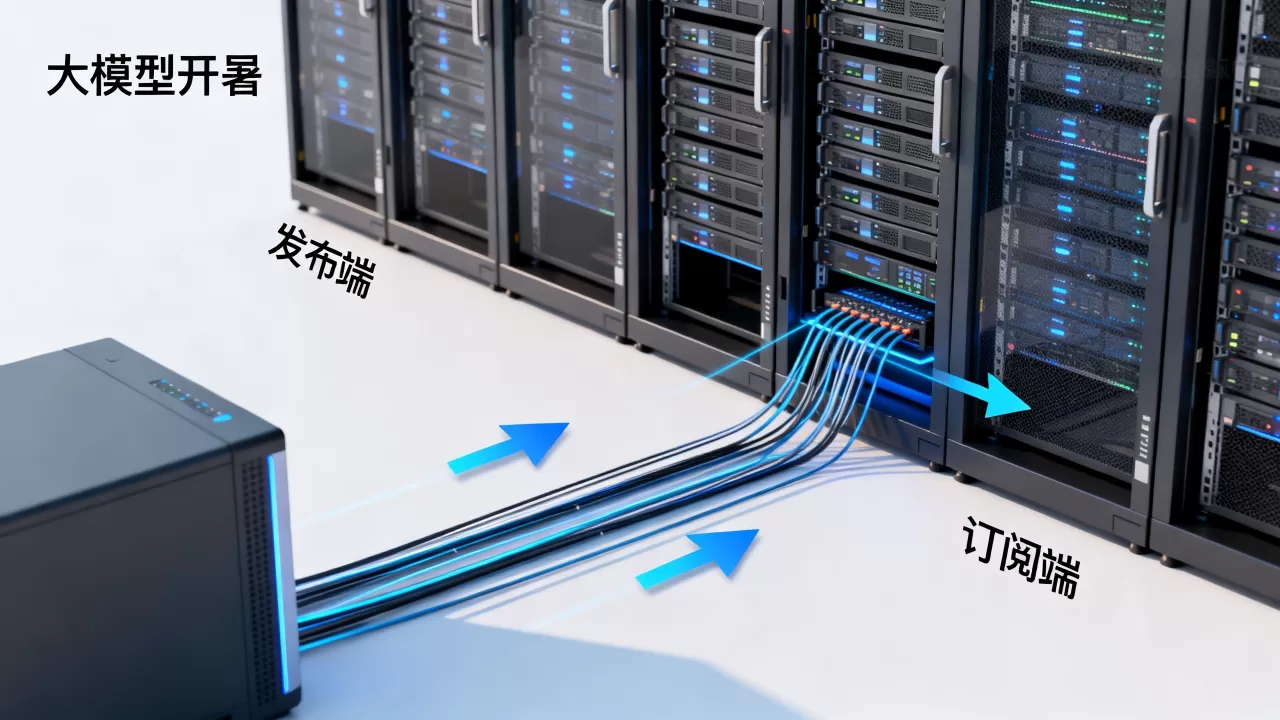
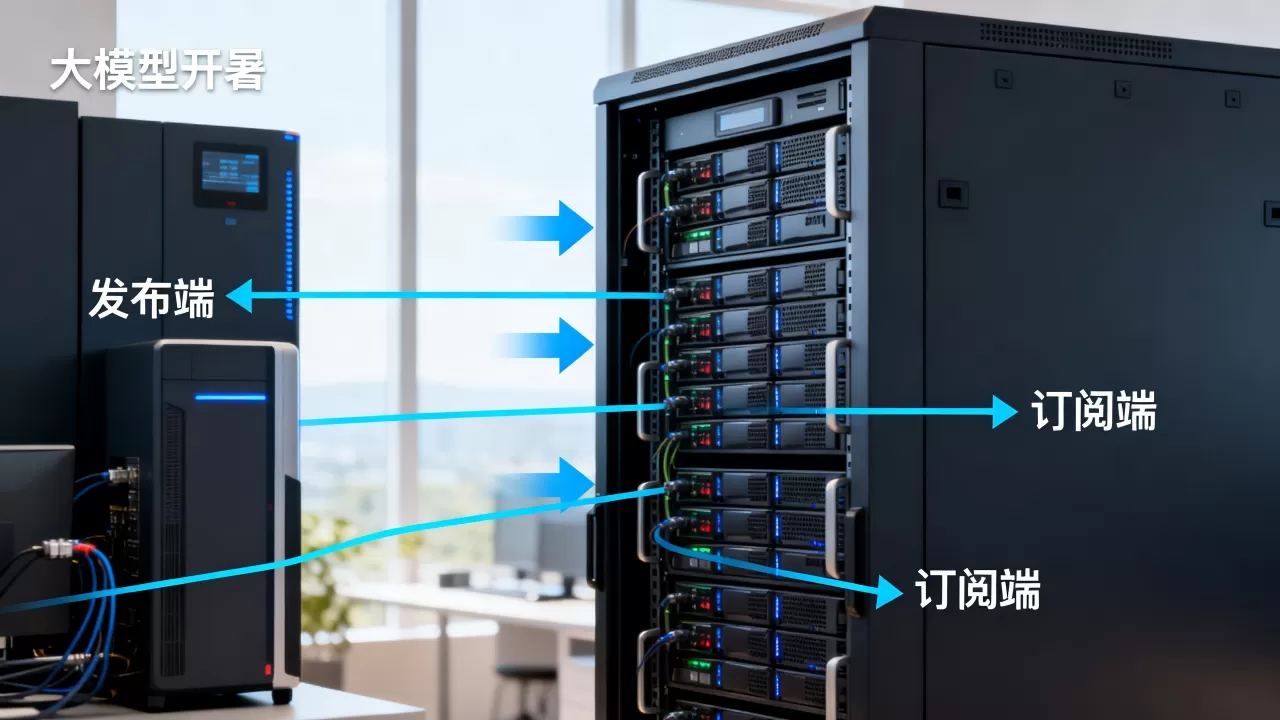
业内专家指出,解耦是分布式系统设计的黄金法则,在发布订阅模式下,业务系统(发布者)只需生成请求消息并发送至消息中间件,随后即可返回“接收成功”的状态给终端用户,无需等待漫长的推理完成,模型服务(订阅者)则根据自身负载情况,从消息队列中拉取任务进行异步处理。
这种异步机制带来了几个显著优势:
- 削峰填谷:当突发流量超过模型处理能力时,消息队列可以暂存请求,避免系统崩溃。
- 弹性伸缩:可以根据消息队列的长度,自动增加或减少模型服务的实例数量,实现真正的Serverless化体验。
- 故障隔离:即使某个模型实例宕机,消息队列中的任务也不会丢失,待实例恢复后可继续处理,保证了数据的最终一致性。
提升系统吞吐量与响应速度
对于需要实时反馈的场景,如智能客服或内容生成,用户无法忍受长达数十秒的等待,通过发布订阅模式,系统可以先快速返回一个“处理中”的提示,待模型生成完成后,再通过WebSocket或轮询机制推送结果,这种体验上的优化,远比直接阻塞等待要友好得多。
大模型发布订阅模式实战部署方案
在实际操作中,选择合适的消息中间件和编排工具至关重要,基于Kafka或RabbitMQ结合Kubernetes的部署方案是行业内的主流选择。
核心组件选型与配置
构建一个稳健的发布订阅系统,需要关注以下几个关键组件:
- 消息中间件:推荐使用Kafka,因其高吞吐量和持久化能力,适合处理大模型产生的大量长文本请求,对于轻量级场景,RabbitMQ也是不错的选择。
- 模型服务网关:如vLLM或TGI(Text Generation Inference),它们专门针对大模型推理进行了优化,支持高并发请求和连续批处理。
- 编排层:使用Kubernetes Operator或Knative,实现基于消息队列长度的自动扩缩容。
具体操作步骤
以下是部署一个基础发布订阅架构的操作路径:
- 第一步:部署消息队列,在Kubernetes集群中部署Kafka集群,配置Topic用于接收推理请求,确保Topic的分区数足够多,以支持并行消费。
- 第二步:封装模型服务,将大模型容器化,并配置健康检查探针,模型服务启动后,注册为Kafka的消费者组,监听特定的Topic。
- 第三步:编写发布接口,开发一个RESTful API接口,接收前端请求,接口逻辑为:验证输入 -> 序列化请求体 -> 发送消息至Kafka Topic -> 返回请求ID。
- 第四步:实现异步回调,模型服务处理完请求后,将结果写入另一个Result Topic,或通过HTTP回调通知业务系统,前端通过轮询请求ID获取最终结果。
大模型部署发布订阅模式常见问题解析
在实际落地过程中,开发者经常会遇到一些典型的技术难题,以下针对几个高频问题进行解答,帮助团队避开常见陷阱。
大模型发布订阅模式如何保证消息不丢失
消息丢失是分布式系统的大忌,为确保可靠性,需采取多重保障机制:
- 生产者端:启用Kafka的ACK机制,设置为
all,确保消息写入所有ISR(In-Sync Replicas)副本后才返回成功。 - 消费者端:关闭自动提交Offset,仅在模型成功处理并持久化结果后,手动提交Offset,若处理失败,则不提交Offset,确保消息能被重新消费。
- 死信队列:配置死信Topic,将处理多次失败的消息转入死信队列,便于人工介入排查,避免阻塞正常流程。
大模型发布订阅模式与同步API调用对比
许多团队在架构选型时会纠结于同步与异步的权衡,下表对比了两种模式的核心差异:
| 维度 | 同步API调用 | 发布订阅模式 |
|---|---|---|
| 响应延迟 | 用户需等待推理完成,延迟高 | 即时返回接收状态,感知延迟低 |
| 系统耦合度 | 高,业务方强依赖模型服务可用性 | 低,通过消息队列解耦,互不影响 |
| 资源利用率 | 低,空闲连接占用资源 | 高,按需消费,资源动态分配 |
| 实现复杂度 | 低,易于开发调试 | 高,需维护消息队列及处理异步逻辑 |
| 适用场景 | 简单查询、低并发场景 | 高并发、长耗时、批处理场景 |
据工信部数据,采用异步架构的企业在应对大促等流量高峰时,系统可用性提升了显著比例。
大模型发布订阅模式在边缘计算中的价格优势
对于预算有限的中小企业,云原生大模型部署可能成本过高,发布订阅模式允许将推理任务分发到边缘节点。
- 带宽节省:通过本地预处理和异步传输,减少实时数据回传带宽。
- 资源复用:边缘设备可在闲时处理积压消息,忙时仅处理紧急请求,提高硬件利用率。
- 成本优化:相比云端按需付费,边缘部署的一次性投入虽高,但长期运营成本较低,尤其适合数据隐私要求高的行业。
大模型发布订阅模式未来发展趋势
随着技术的演进,发布订阅模式在大模型领域的应用将更加深入。
流式处理与实时反馈
未来的系统将更倾向于支持流式输出,模型在生成Token的过程中,即可通过消息队列实时推送给前端,实现类似ChatGPT的打字机效果,这需要消息中间件支持更细粒度的消息分割和重组。
智能路由与负载均衡
结合AI算法,消息队列可以实现智能路由,根据请求的内容类型(代码生成、创意写作、数据分析),自动将消息分发到专门优化的模型实例上,进一步提升处理效率和准确率。
大模型部署采用发布订阅模式,不仅是技术架构的升级,更是业务思维的转变,它通过异步解耦,让系统在面对不确定性流量时更加从容,对于追求高可用、高扩展性的企业而言,这是一条经过验证的最佳实践路径,掌握这一模式,将为大模型应用的规模化落地奠定坚实基础。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/395436.html