io流api就是Java里所有数据读写操作的统一抽象,它用InputStream/OutputStream和Reader/Writer四大家族把文件、网络、内存等数据源全部包装成“管道”,你只负责往里读或写,剩下的脏活累活交给API。
很多初学者看到“io流api”这个名词就头大,因为它既有一堆抽象类,又有一堆实现类,还分字节流和字符流,其实你不用怕,把它想象成一个自来水系统就好:水龙头是数据源,水管是流,水表是你的程序,今天这篇文章,我用大白话把Java io流怎么用、io流api有哪些核心成员、以及和NIO的区别一次讲透,最后再给你几个能直接跑的java文件流操作实例。
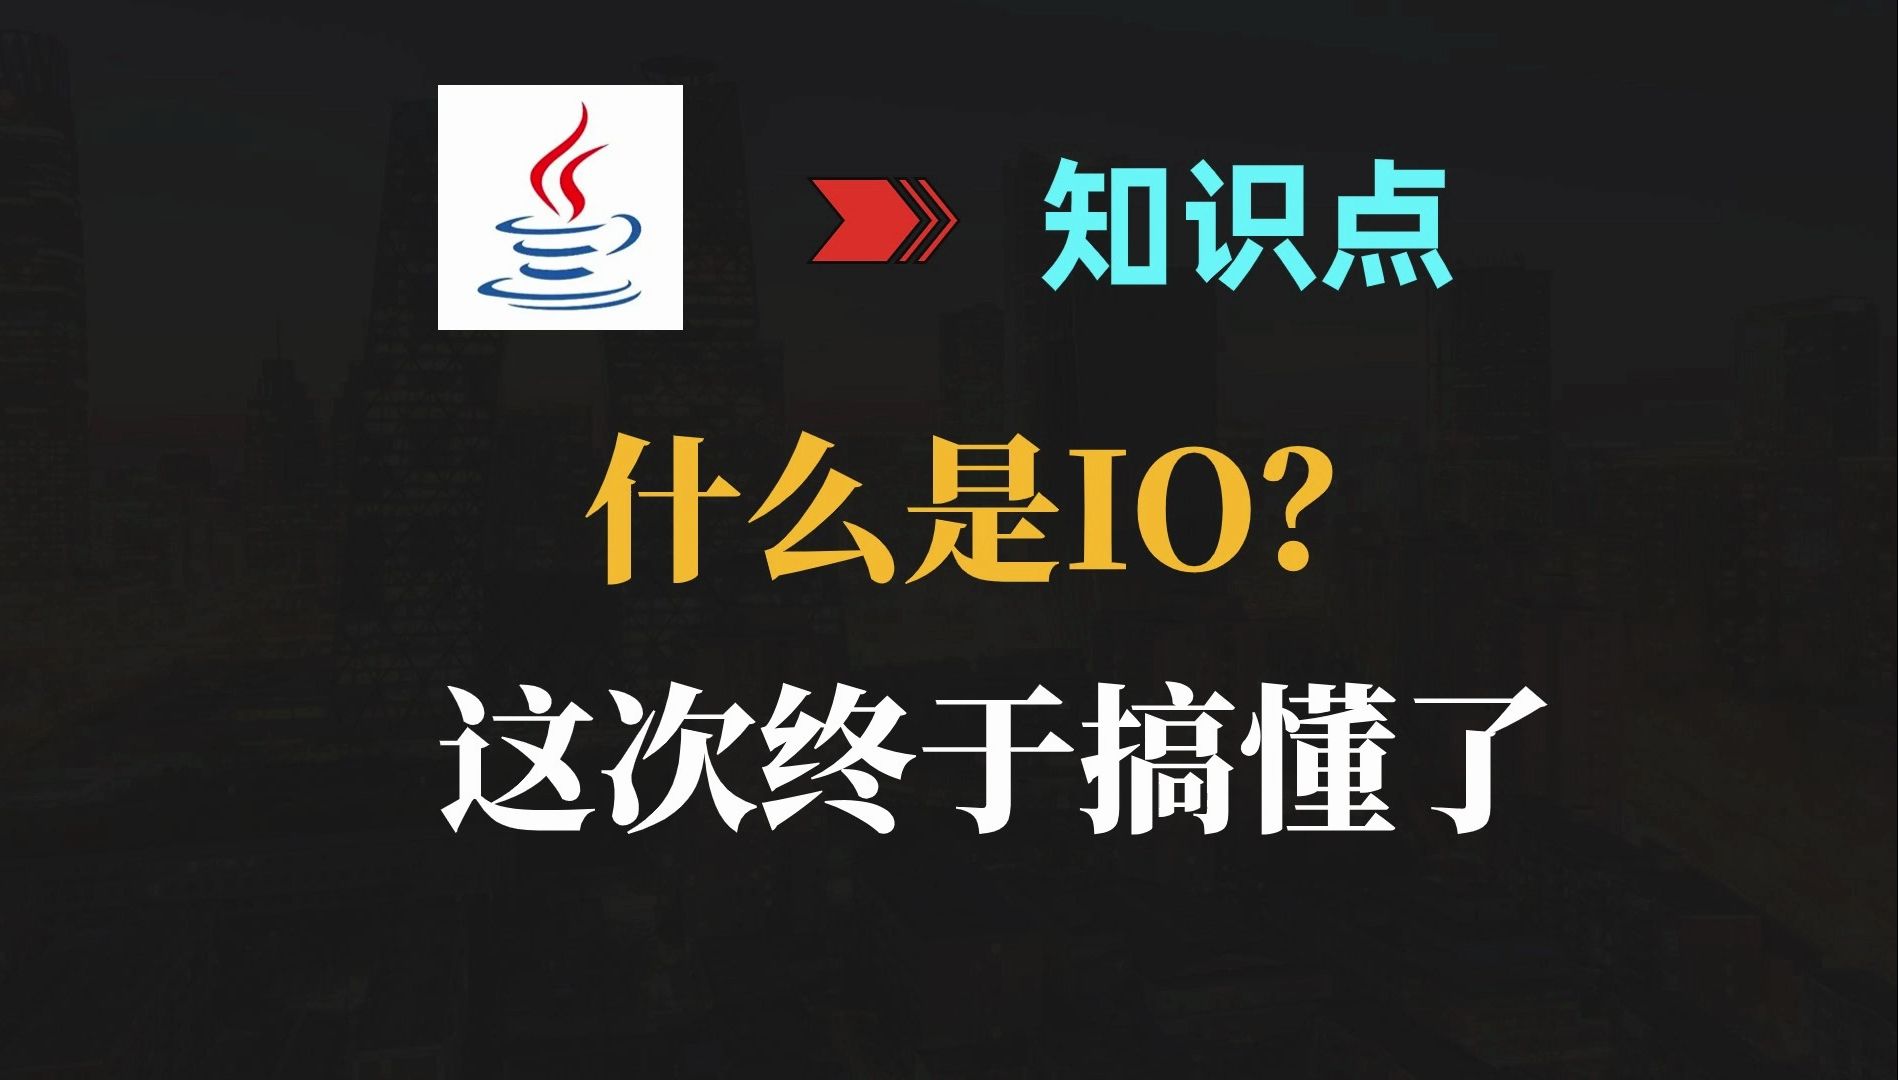

IO流API的核心骨架:四个抽象父类
Java的io流api设计得很规整,所有流都继承自四个抽象父类,你可以把字节流和字符流理解成两套并行的“运输队”,一套运二进制,一套运文本。
InputStream和OutputStream:字节流的搬运工
- InputStream 负责从数据源读字节,核心方法是
read(),一次读一个字节,返回-1表示读完了。 - OutputStream 负责把字节写出去,核心方法是
write(int b),配合flush()把缓冲区的数据强制刷出去。
这两个类直接和文件、网络、图片、音频打交道,凡是文件后缀是.jpg、.mp4、.zip的,都得靠它们。
Reader和Writer:字符流的贴心管家
- Reader 专门读字符,一次读一个
char,内部自动处理编码。 - Writer 写字符,写字符串时特别方便,比一个个写字节省心多了。
文件是纯文本(比如.txt、.java、.xml),就用字符流,注意,字符流底层还是字节流,只是多了一层编码转换的“翻译官”。
一句话分清四者的职责
| 抽象类 | 读/写 | 处理单位 | 典型场景 |
|---|---|---|---|
| InputStream | 读 | 字节 | 图片、音频、二进制协议 |
| OutputStream | 写 | 字节 | 文件复制、网络发送 |
| Reader | 读 | 字符 | 读取配置文件、源码 |
| Writer | 写 | 字符 | 写日志、生成HTML |
java io流和nio区别:新老搬运工的对决
行内人聊io流api时,总绕不开NIO,NIO不是“新的IO流”,而是“非阻塞IO”,它们俩的区别,可以用一个快递站来比喻。
传统IO:每个包裹都要一个快递员
Java标准io流api是阻塞式的,你调用 read() 时,线程就卡在那里等数据,数据不来不干活,处理多个连接时,就得开多个线程,每个线程守着一个流,这种模式在文件不大时挺好用,但遇到高并发的网络请求,线程一多,系统就喘不过气。
NIO:一个快递员管所有包裹
NIO引入了一个叫“Selector”的调度员,一个线程可以同时监控成千上万个通道(Channel),哪个通道有数据了,就处理哪个,没有数据就去忙别的,这就是非阻塞,用NIO写聊天服务器、网关程序,性能能提升一大截。
实际项目里怎么选
- 操作普通文件、读取小配置文件、写日志用标准io流api就够了,简单直接,代码好维护。
- 处理高并发网络连接、需要同时管理大量Socket选NIO,或者直接上Netty这种封装好的框架。
- 传输大文件(几个GB以上)建议用NIO的
FileChannel,它支持零拷贝,减少数据在内核和用户空间之间来回倒腾。
业内专家指出,绝大多数业务系统的性能瓶颈并不在io流api本身,而在数据库查询和网络延迟,所以别盲目追求NIO,先把手头的文件读写写对。
实操:java文件流操作实例
光说不练假把式,下面给你三个最常用的java文件流操作实例,覆盖复制文件、读文本、写文本这三个高频场景,代码我都简化过,直接复制就能跑。
用字节流复制文件(推荐方式一)
try (FileInputStream in = new FileInputStream("source.jpg");
     FileOutputStream out = new FileOutputStream("copy.jpg")) {
    byte[] buffer = new byte[1024];
    int len;
    while ((len = in.read(buffer)) != -1) {
        out.write(buffer, 0, len);
    }
}
这段代码用了 try-with-resources 语法,流会自动关闭。buffer 数组是临时中转站,一次读1024个字节,比逐字节读快得多。
用字符流读取文本文件(推荐方式二)
try (BufferedReader reader = new BufferedReader(new FileReader("data.txt"))) {
    String line;
    while ((line = reader.readLine()) != null) {
        System.out.println(line);
    }
}
BufferedReader 自带缓冲区,readLine() 一次读一行,处理日志文件、CSV文件特别顺手。
用Writer写文件(推荐方式三)
try (BufferedWriter writer = new BufferedWriter(new FileWriter("output.txt", true))) {
    writer.write("这一行是追加内容");
    writer.newLine();
}
注意 new FileWriter("output.txt", true) 里的 true 表示追加模式,不传的话会把原文件清空重写,这一点经常有人踩坑。
处理中文字符不乱码
读文本时遇到乱码,十有八九是编码没对上,Java默认使用平台编码,Windows中文系统常见GBK,Linux常见UTF-8,稳妥的做法是明确指定编码:
BufferedReader reader = new BufferedReader(
    new InputStreamReader(new FileInputStream("file.txt"), "UTF-8")
);
字符流和字节流之间通过 InputStreamReader 和 OutputStreamWriter 搭桥,桥的参数就是编码格式。
Java io流api有哪些常用实现类
面试官和实际开发中,有八个类出现频率最高,我把它们分成三组,帮你记。
- 文件操作组:
FileInputStream、FileOutputStream、FileReader、FileWriter,它们直接对接文件,是入门必学。 - 缓冲性能组:
BufferedInputStream、BufferedOutputStream、BufferedReader、BufferedWriter,它们给底层流加缓冲区,大幅减少磁盘读写次数。 - 转换桥接组:
InputStreamReader、OutputStreamWriter,负责字节流和字符流互相转换,还能指定字符集。
还有一种流叫数据流:DataInputStream 和 DataOutputStream,它们能直接读写Java基本数据类型,比如把一个 int 写进文件,再用 DataInputStream 读回来,不会丢位数,但这种格式只有Java自己认识,不推荐用来做跨语言数据交换。
IO流的关闭顺序与最佳实践
这是新手最容易忽略的地方,流开多了不关,文件一直被占用,Windows会直接报“文件正在被另一个进程使用”,Linux下文件描述符也会泄漏。
关闭的基本规则
- 后开的先关,如果先关外层缓冲流,再关内层文件流,系统会报错。
- 用
try-with-resources就不用管顺序,它自动逆序关闭所有资源。
经典的反面教材
FileInputStream in = null;
try {
    in = new FileInputStream("test.txt");
    // 读操作
} finally {
    in.close(); // 如果读操作抛异常,in可能还是null,空指针
}
正确写法是把
close() 也放进 finally 里再套一层判断,但这样代码很啰嗦,所以Java 7之后官方推荐直接放弃 finally,改用 try-with-resources。
IO流API常见面试题与避坑指南
行业共识认为,IO流这块面试题翻来覆去就那几个点,但每个点都藏着坑。
为什么字节流不用缓冲区也能写,字符流不行
字节流可以直接调用 write(int) 把字节写到操作系统,但每次写都是一次系统调用,性能很差,字符流内部通常带编码转换器,转换过程需要缓冲,否则一个字符一个字符地写,效率低到发指,所以字符流往往要裹一层 BufferedWriter。
read()方法返回的为什么是int而不是byte
因为 byte 是8位,取值范围 -128 到 127,而 read() 需要返回 -1 来表示“流结束”,如果用 byte 类型,-1 和正常的字节值冲突,就没法区分“读到数据”和“读完了”,这是API设计上的精妙之处。
复制文件时字节数组多大合适
- 1KB到8KB之间比较常见,太大分配内存慢,太小调用次数多。
- 实际性能还跟操作系统和磁盘有关,没有绝对最优解。
- 追求极致性能直接用
FileChannel.transferTo(),零拷贝更香。
Q&A:关于io流api的疑问解答
问题1:io流api和File类是什么关系?
File类只管文件元数据,比如路径、大小、是否存在,不负责内容读写,真正读写文件内容的是io流api,File更像是文件的“身份证”,流才是“搬运工”,两者常配合使用,比如先用 File.exists() 判断文件在不在,再创建流去读。
问题2:io流api在Java 8和Java 17里有什么区别?
核心抽象类没变,但Java 11在Files类里加了很多便捷方法,Files.readString() 可以一行读整个文本文件,Files.writeString() 一行写字符串,这些方法内部封装了字符流和编码处理,适合小文件,大文件还是用传统的流可靠。
问题3:为什么有时候flush()了数据还是没写进文件?
flush() 只能把Java缓冲区里的数据推给操作系统,操作系统还可能有自己的页缓存,真正落盘需要调用 FileDescriptor.sync() 或者等系统自动刷盘,如果外层流没有关闭,close() 会先调用 flush(),但如果你只调 flush() 而忘了关流,缓冲区倒是清了,但连接没释放,依然可能丢数据。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/587947.html