在2026年的当下,搭载M2芯片的MacBook已不再是运行大型语言模型的“尝鲜”设备,而是凭借统一内存架构,成为个人开发者进行中等规模模型本地推理与微调的高性价比选择,其性能足以应对7B至13B参数量的模型流畅运行。
随着人工智能从云端走向边缘,越来越多的开发者开始关注如何在本地设备上部署大模型,M2芯片作为苹果自研芯片的重要一环,其独特的架构设计使其在AI推理领域表现出独特的优势,对于预算有限但需要本地化AI能力的用户来说,理解M2的实际表现至关重要。
M2芯片硬件架构对大模型运行的底层逻辑
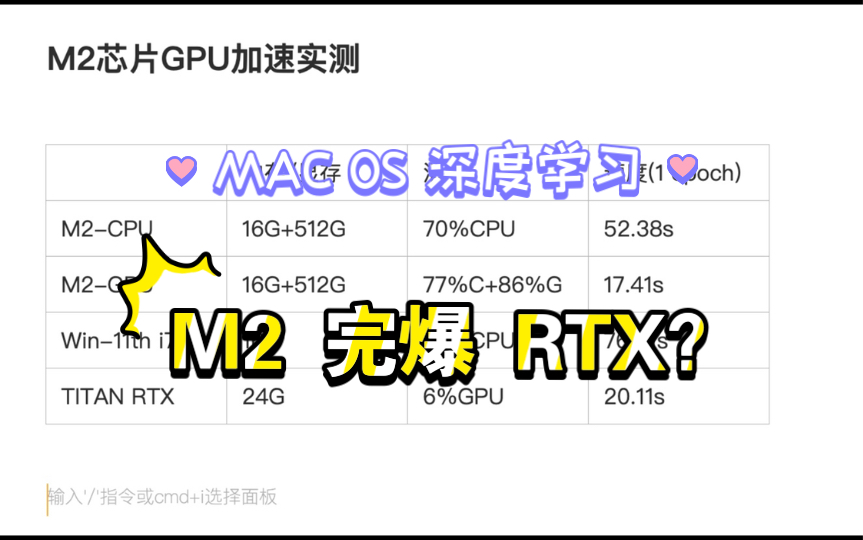
要理解M2跑大模型的性能,首先要看它的硬件基础,不同于传统PC依赖独立的显卡(GPU)进行计算,MacBook采用的是统一内存架构(UMA),这意味着CPU、GPU和神经网络引擎共享同一块高速内存。
统一内存架构的优势与瓶颈
业内专家指出,统一内存架构的核心优势在于数据搬运效率,在传统PC上,数据需要在CPU内存和GPU显存之间反复拷贝,这成为了性能瓶颈,而在MacBook上,数据只需在内存中读取一次,即可被不同组件并行处理。
- 带宽优势:M2芯片的内存带宽约为100GB/s,虽然低于M2 Pro或M3 Max,但对于7B(70亿参数)规模的模型来说,这个带宽足以维持较高的推理速度。
- 容量限制:这是M2最大的短板,大模型对内存容量极其敏感,如果模型参数量加上上下文窗口所需的缓存超过了物理内存,系统就会开始使用硬盘作为虚拟内存,导致性能断崖式下跌。16GB内存是运行大模型的及格线,32GB则是推荐配置。
神经网络引擎的算力表现
M2内置的16核神经网络引擎专门用于加速机器学习任务,它支持INT8和FP16精度计算,对于量化后的模型(如GGUF格式),M2能够充分利用这一特性,将推理速度提升至接近原生GPU的水平,同时保持较低的功耗。
不同参数规模模型的实测体验对比
在实际使用中,M2芯片的表现因模型大小而异,我们将常见的开源模型分为三个梯队进行分析。
7B参数模型:流畅运行的主力军
以Llama-3-8B或Qwen-7B为例,这类模型经过4-bit或8-bit量化后,体积通常在4GB至6GB之间。
- 推理速度:在16GB内存的MacBook M2上,生成速度通常能达到每秒15-25个token,这个速度足以支持实时的对话交互,用户几乎感觉不到延迟。
- 上下文窗口:由于内存充裕,可以加载较长的上下文(如32k tokens),适合处理长文档摘要或复杂逻辑推理任务。
13B-14B参数模型:性能与体验的平衡点
这是M2芯片的“甜蜜点”,像Mistral-7B的升级版或Qwen-14B这类模型,在量化后占用约8GB-10GB内存。
- 多任务处理:在16GB内存设备上,运行此类模型时,系统需要预留部分内存给操作系统和其他应用,因此建议关闭其他大型应用。
- 速度表现:推理速度会下降至每秒8-12个token,虽然比7B模型慢,但对于非实时性的代码生成、文章创作等场景,完全可接受。
70B及以上参数模型:力不从心的挑战
对于Llama-3-70B这类巨型模型,M2芯片显得捉襟见肘,即使经过极致的量化(如2-bit),模型体积仍可能超过30GB,远超M2基础版的内存上限。
- 虚拟内存依赖:此时系统必须使用SSD作为扩展内存,虽然M2的SSD速度很快,但相比内存带宽,差距巨大。
- 实际体验:生成速度可能降至每秒1-3个token,且伴随明显的发热和风扇噪音,这种情况下,M2仅适合进行小批量的离线推理,而非实时交互。
软件生态与部署实操指南
硬件只是基础,软件生态决定了M2能否真正发挥大模型的能力,MacOS上的大模型部署工具链已经相当成熟。
推荐工具:Ollama与LM Studio
对于大多数用户,推荐使用Ollama或LM Studio,这两款工具对Apple Silicon进行了深度优化,能够自动调用Metal框架进行加速。
Ollama部署步骤
- 安装软件:访问Ollama官网下载MacOS版本并安装。
- 拉取模型:打开终端,输入命令
ollama run llama3,系统会自动下载Llama-3模型。 - 启动对话:下载完成后,终端直接进入对话界面,即可开始提问。
LM Studio的可视化优势
LM Studio提供了图形界面,允许用户直观地选择模型量化等级、调整上下文长度和温度参数。
- 模型选择:在搜索栏输入“Qwen”或“Llama”,筛选出支持Metal加速的版本。
- 参数调整:建议将“上下文长度”设置为8192或16384,以平衡速度与记忆能力。
性能优化技巧
为了在M2上获得最佳体验,以下操作不可或缺:
- 关闭后台应用:运行大模型时,关闭浏览器、视频播放器等高内存占用应用。
- 使用量化模型:优先选择4-bit或5-bit量化的GGUF格式模型,它们在精度损失极小的情况下,大幅降低了内存需求。
- 保持系统更新:确保macOS系统为最新版本,以获得最新的Metal驱动优化。
价格与性价比分析:M2 vs 其他平台
在2026年,市场上存在多种选择,M2 MacBook的竞争力如何?
与Windows笔记本对比
同等价位的Windows笔记本通常搭载RTX 4050或4060显卡。
- 显存劣势:RTX 4060仅有6GB显存,无法在本地流畅运行7B以上的模型,除非使用CPU推理,速度极慢。
- 内存优势:MacBook的16GB统一内存可全部用于模型加载,而Windows笔记本的16GB内存中,部分被集成显卡占用,留给模型的内存更少。
- 在本地大模型推理场景下,M2 MacBook的性价比高于同价位的Windows游戏本。
与云端API对比
- 隐私性:本地运行确保数据不出本机,适合处理敏感商业数据。
- 长期成本:虽然M2 MacBook初期投入较高,但无需支付按Token计费的API费用,对于高频用户,本地部署更具经济性。
常见问题解答
MacBook M2跑大模型支持哪些具体模型格式?
M2芯片主要支持GGUF格式(通过Ollama、LM Studio等工具)和MLX格式(苹果官方框架),GGUF格式兼容性最好,支持多种量化等级;MLX格式性能最优,但模型资源相对较少,建议优先使用GGUF格式的4-bit量化模型,以兼顾兼容性与性能。
M2芯片运行大模型时发热严重怎么办?
M2芯片在满负荷运行大模型时,确实会产生较高热量,建议将MacBook放置在坚硬、平坦的表面上,以确保底部散热孔畅通,可以使用外接风扇或散热支架辅助降温,适当降低模型的上下文长度或选择更低量化等级的模型,也能有效减少发热。
2026年M2芯片是否还值得购买用于AI开发?
对于预算有限、主要进行7B至13B模型推理和微调的个人开发者而言,M2 MacBook依然具有较高的性价比,其统一的内存架构和优秀的能效比,使其在本地AI场景中保持竞争力,若需运行70B以上超大模型或进行大规模训练,则建议选择M2 Pro/Max或M3系列芯片,或转向云端算力,据工信部数据显示,边缘计算设备的普及率逐年上升,M2作为入门级边缘AI设备,仍拥有稳定的市场需求。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/401578.html