AI模型和大模型有什么区别?大模型和普通模型的区别

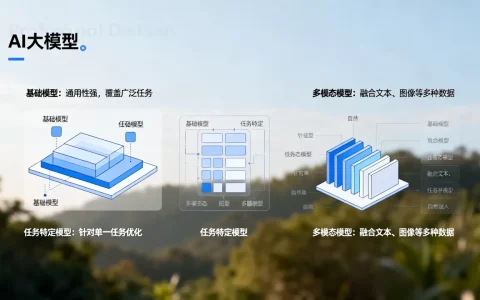
AI模型是大模型的基础组件,而大模型是参数量极大、具备通用推理能力的超级AI模型;简言之,大模型属于AI模型的一个子集,但并非所有AI模型都是大模型。

在日常技术讨论中,这两个概念经常被混用,导致很多企业在选型时产生困惑,要理清它们的区别,不能只看名词,更要看背后的技术架构、应用场景以及成本结构,这不仅仅是字面上的差异,更是计算资源、训练逻辑和落地方式的根本不同。
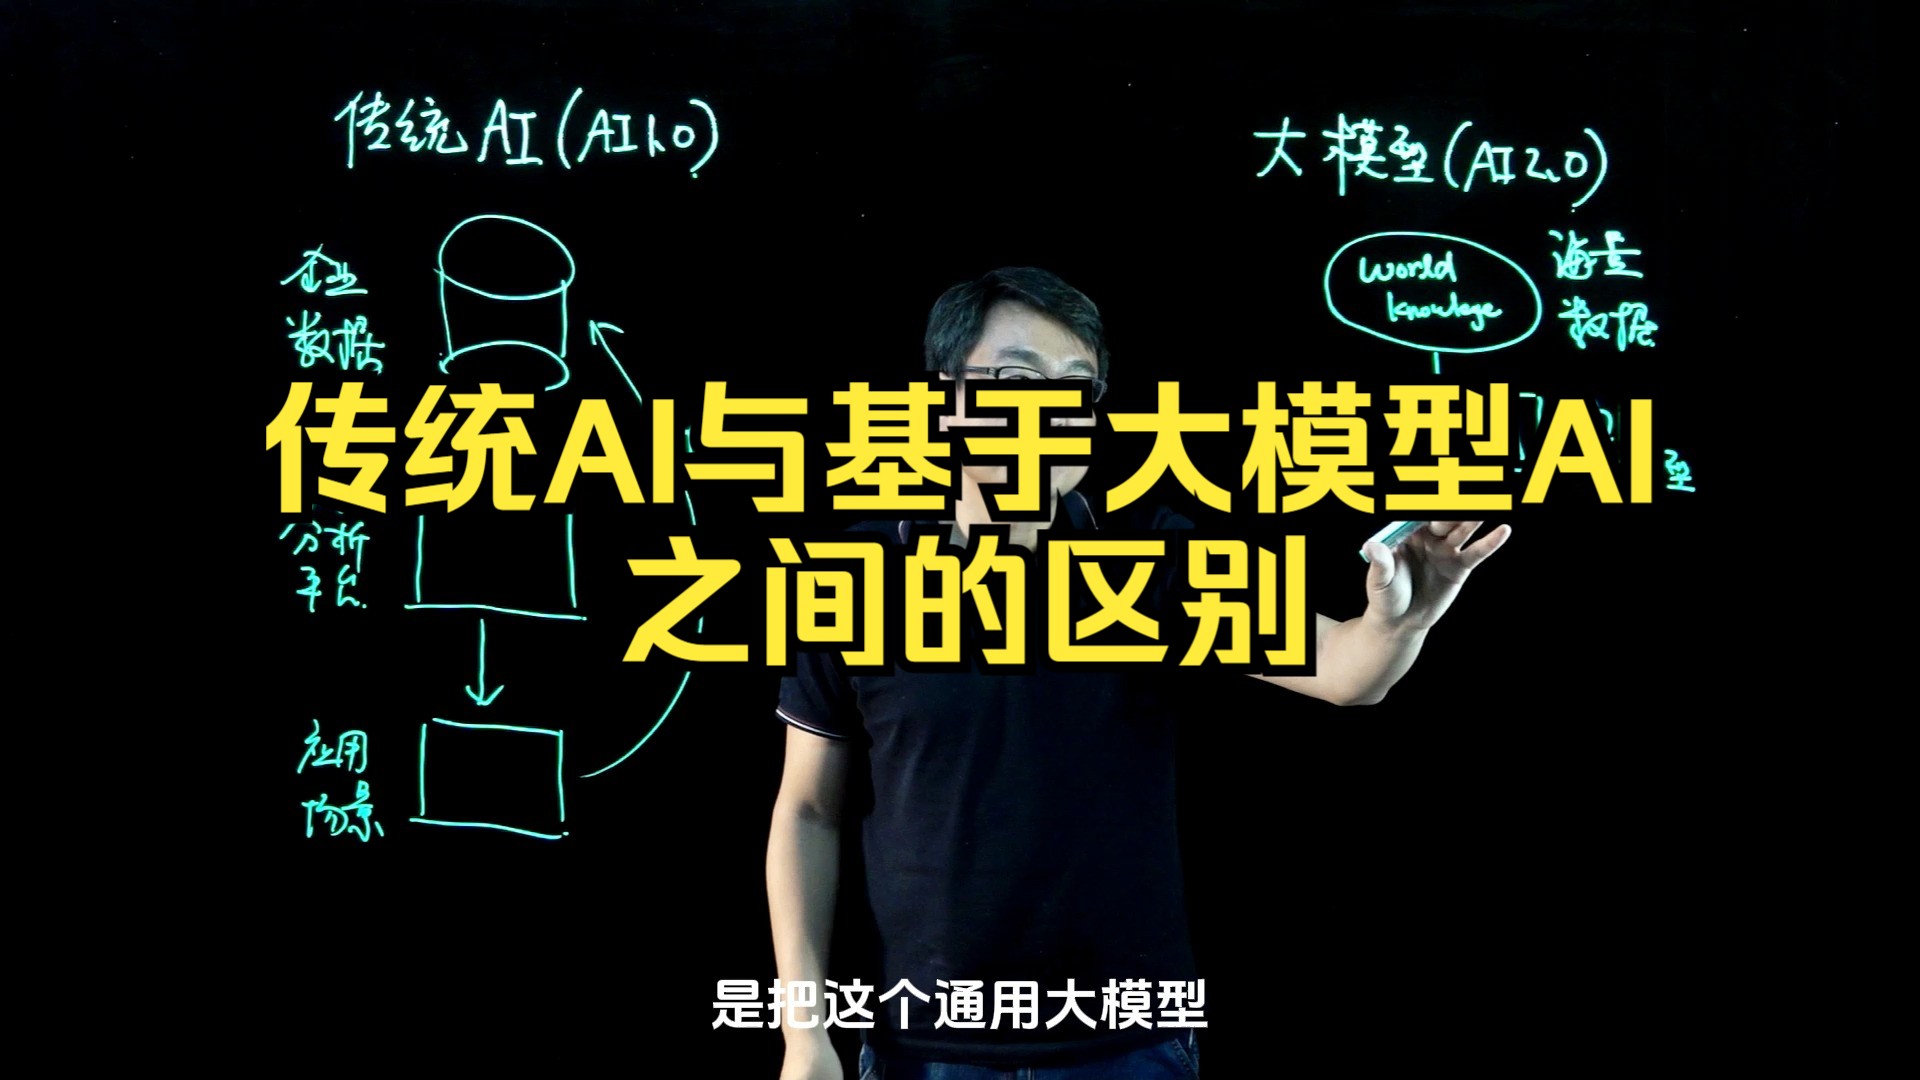
传统AI与基于大模型AI之间的区别
加载中
传统AI与基于大模型AI之间的区别

AI模型与大模型的核心定义差异

什么是AI模型

AI模型是一个广泛的概念,指代任何通过算法从数据中学习规律并做出预测或决策的系统,它可以小到只有几百个参数,用于识别猫狗图片;也可以中等规模,用于预测某地区的降雨概率,业内专家指出,传统的机器学习模型(如线性回归、决策树)和早期的深度学习模型都属于这一范畴,它们的特点通常是“专才”,即在特定任务上表现优异,但缺乏泛化能力。

什么是大模型

大模型(Large Language Models, LLMs 或 Foundation Models)是AI模型的一种特殊形态,其核心特征在于“大”参数量通常在数十亿甚至万亿级别,这种规模赋予了它们强大的涌现能力,即当模型大到一定程度时,会表现出小模型不具备的能力,如零样本学习、逻辑推理和多模态理解,行业共识认为,大模型更像是一个“通才”,它不再局限于单一任务,而是能够处理文本、代码、图像等多种形式的输入和输出。

技术架构与训练逻辑对比

数据规模与算力需求
AI模型和大模型有什么区别?大模型和普通模型的区别

两者的最大区别在于对数据和算力的依赖程度。
传统AI模型:通常依赖高质量、小规模的标注数据,训练过程相对轻量,普通服务器甚至高性能PC即可运行,训练一个垃圾邮件分类器,可能只需要几千封邮件的数据和几小时的计算时间。
大模型:需要海量、多模态的互联网数据进行预训练,训练过程需要成千上万张GPU卡协同工作,耗时数月,能耗巨大,据工信部相关技术白皮书显示,训练一个千亿参数的大模型,其算力成本是传统模型的数百倍。

泛化能力与微调方式

传统AI模型:采用“任务驱动”模式,解决A问题训练A模型,解决B问题训练B模型,模型之间互不相通,迁移成本高。
大模型:采用“预训练+微调”模式,先在海量通用数据上进行预训练,掌握语言和世界知识的基础,然后通过少量特定数据微调(Fine-tuning)即可适应新任务,这种范式极大地降低了应用开发门槛。

应用场景与落地实践指南

何时选择传统AI模型

在以下场景中,传统AI模型依然是更优解,因为它们成本低、响应快、可解释性强:
1. 资源受限环境:如嵌入式设备、物联网传感器,无法承载大模型的庞大体积。
2. 高实时性要求:如高频交易算法、工业控制回路,需要毫秒级响应,大模型的推理延迟往往难以满足。
3. 数据隐私敏感:如医疗、金融核心数据,无法上传至云端大模型,需在本地部署轻量级模型。

何时选择大模型

当业务涉及复杂逻辑
AI模型和大模型有什么区别?大模型和普通模型的区别

、创意生成或非结构化数据处理时,大模型具有压倒性优势:
1. 内容创作与营销:自动生成文案、脚本、代码片段,大幅提升内容生产效率。
2. 智能客服与问答:理解用户自然语言意图,提供多轮对话服务,而非简单的关键词匹配。
3. 复杂决策辅助:分析长篇报告、合同条款,提取关键信息并进行逻辑推理。

成本结构与选型策略分析

初始投入与运营成本

企业在选型时,必须算一笔经济账。
传统AI模型:初始开发成本较低,但维护成本高,随着业务场景增加,需要不断训练新模型,人力成本随业务复杂度线性增长。
大模型:初始接入成本低(通过API调用),但长期运营成本高,每次调用都产生Token费用,且随着用户量增加,API调用费用可能迅速攀升,若选择私有化部署大模型,则需承担高昂的硬件采购和维护成本。

如何评估性价比

建议采用“混合架构”策略,对于简单、高频、标准化的任务,使用轻量级传统模型;对于复杂、低频、需要创意的任务,调用大模型API,这种组合既能控制成本,又能保证用户体验,据统计,多数成功落地的企业都采用了这种分层架构,而非盲目追求全量大模型化。

常见误区与避坑指南

大模型万能论

很多用户认为大模型无所不能,实际上它在事实准确性上存在“幻觉”问题,在医疗诊断、法律判决等高风险领域,必须结合传统模型进行校验,不能直接依赖大模型的输出。

数据越多越好

对于传统AI模型,数据质量远比数量重要,脏数据会导致模型偏差甚至失效,而对于大模型,虽然需要海量数据,但清洗和去重同样关键,低质量数据会稀释模型的知识密度。
AI模型和大模型有什么区别?大模型和普通模型的区别

忽视算力瓶颈

大模型的推理速度受限于算力,在并发量高时,可能出现响应延迟,企业在引入大模型前,必须进行压力测试,评估现有基础设施是否支撑得住高峰期的流量。

未来趋势与演进方向

随着技术的进步,AI模型与大模型的界限正在逐渐模糊,传统模型通过蒸馏技术(Distillation)变得更大、更强;大模型通过量化和剪枝技术变得更小、更快,可能会出现“中等规模模型”成为主流,它们在性能和成本之间找到最佳平衡点。

AI模型和大模型的区别

常见问题解答

大模型和传统AI模型哪个更适合中小企业?

中小企业通常资源有限,建议优先使用基于API的大模型服务,避免高昂的硬件投入,但对于核心业务数据,可结合轻量级传统模型进行本地化处理,以平衡成本与隐私。

大模型的训练数据从哪里来?

大模型的预训练数据主要来自互联网公开文本、书籍、代码库等多模态数据,这些数据经过严格的清洗、去重和过滤,以确保质量和安全性。

AI模型和大模型的区别主要体现在参数规模上吗?

参数规模是直观区别,但核心差异在于泛化能力和涌现特性,大模型凭借海量参数实现了从“专用”到“通用”的跨越,而传统模型受限于参数规模,难以具备这种通用推理能力。

首发原创文章,作者:王坚‌,如若转载,请注明出处:https://test.idctop.com/article/385227.html

赞 (0)
个人使用云主机好吗?云主机和虚拟主机哪个更适合个人建站
上一篇 2026年6月15日 09:43
AIoT平台研发价格是多少?物联网平台开发费用明细
下一篇 2026年6月15日 09:46

相关推荐

  • 服务器功率一般多大?服务器功率怎么计算

    服务器功率并非固定数值,而是随负载动态变化的物理量,通常待机时仅为峰值功率的20%-30%,满载时则接近额定值,合理选型与散热管理是降低PUE的关键,很多刚接触数据中心运维的朋友,容易陷入一个误区:认为服务器功率就是机箱上贴的那张标签写的瓦数,那张标签代表的是“最大潜在消耗”,而在实际运行中,服务器就像一辆汽车……

    2026年7月6日
    12500
  • 服务器RAC的安装步骤有哪些?,如何配置高可用性?

    Oracle RAC(Real Application Clusters)通过多节点共享数据库,实现高可用与横向扩展,是核心业务系统应对服务器故障的首选方案,服务器RAC是什么?核心概念与误解澄清很多运维人员初次接触时,以为RAC就是多台服务器跑同一个数据库,简单堆硬件就行,其实不然,RAC的核心在于共享存储架……

    2026年7月21日
    1300
  • 大模型的DS-1000代码评测是什么?DS-1000代码评测标准详解

    DS-1000是专为评估大型语言模型代码生成能力设计的基准测试集,它通过模拟真实编程任务,量化模型在代码补全、生成及调试方面的实际表现,是目前衡量AI编程助手核心竞争力的关键标尺,在人工智能飞速发展的今天,代码生成不再是简单的文本拼接,而是涉及逻辑推理、语法规范和工程实践的复杂过程,开发者们不再满足于模型能否写……

    2026年6月21日
    4400
  • 如何实现分布式缓存?分布式缓存有哪些常见方案

    分布式缓存通过Redis或Memcached等中间件,将热点数据存储在内存中,显著降低数据库压力并提升系统响应速度,是构建高并发架构的核心组件,在2026年的互联网技术语境下,分布式缓存已经不再是可选的优化手段,而是现代微服务架构的标配,想象一下,你的电商大促活动瞬间涌入百万级用户,如果每个请求都去查询关系型数……

    2026年7月5日
    3700
  • IPv6服务器租用配置怎么做,有哪些注意事项?

    租用IPv6服务器并配置IPv6网络是当前应对IPv4地址枯竭、提升网络访问速度和兼容性的最佳选择,只需在租用时选择支持IPv6的机房和线路,再根据操作系统进行简单配置即可实现,为什么需要IPv6服务器?——ipv6服务器对比ipv4优势IPv4地址枯竭的现状全球IPv4地址早在2019年就已分配完毕,运营商和……

    2026年8月19日
    400
  • 服务器域名泛解析怎么设置?,有哪些注意事项?

    服务器域名泛解析设置的核心操作是通过在DNS解析中添加一条 * 记录,将所有次级域名指向同一服务器IP,再配合服务端虚拟主机配置,即可实现统一解析,但盲目配置可能带来安全风险,需结合业务场景做针对性调整,服务器域名泛解析设置怎么做?泛解析的完整流程包含DNS配置和服务器端适配两个环节,遗漏任何一步都会导致解析失……

    2026年7月29日
    600
  • Java附件上传功能如何实现,有哪些常用组件推荐?

    Java附件上传的核心在于选择合适的实现方式并严格控制文件大小、类型和执行权限,否则项目上线后很容易出现内存溢出、安全漏洞或存储混乱,java附件上传代码实现:从原生Servlet到框架封装实现代码的方式决定了后续维护的复杂度,原生Servlet 3.0够基础,而Spring MVC的MultipartFile……

    2026年7月24日
    600
  • 大模型的BEiT是什么预训练方法?BEiT预训练原理详解

    大模型中的BEiT并非传统视觉预训练方法,而是一种基于“图像分词”的掩码自编码机制,它将图像视为由离散标记组成的序列,通过预测被遮挡部分的标记来学习视觉表征,这种方法彻底改变了计算机视觉领域对图像处理的底层逻辑,让模型不再仅仅关注像素级的差异,而是转向理解语义级的结构,对于正在探索多模态大模型架构的技术人员而言……

    2026年6月21日
    2200
  • IDC销售网站源码如何选择?源码多少钱一套?

    选择IDC销售网站源码,核心是匹配业务规模与功能需求,而非盲目追求大而全, 一套契合的源码能让你在主机、域名、云产品等销售流程中事半功倍,选错则可能陷入维护泥潭,下面从功能对比、选型维度、价格分析和部署实战四个层面,帮你做出明智决策,IDC销售网站源码功能对比:开源与商业到底差在哪?功能是源码的核心价值,我们挑……

    2026年8月5日
    500
  • ai大模型有哪些类别?主流ai大模型分类及特点

    2026年AI大模型主要分为通用基础大模型、垂直行业大模型以及端侧轻量化大模型三大类,选择时需根据算力成本、数据隐私及具体业务场景进行匹配,如今提到人工智能,大家脑海里浮现的往往是能写代码、能画图甚至能聊天的“全能选手”,但如果你真的打算把这些技术落地到企业或个人项目中,会发现“大模型”这个词背后其实有着严格的……

    2026年6月15日
    5900

发表回复

您的邮箱地址不会被公开。 必填项已用 * 标注