2026年AI大模型学习硬件的核心选择逻辑已从单纯追求显卡算力转向“显存带宽+本地部署能力+能效比”的综合平衡,对于个人开发者,RTX 4090仍是性价比首选,而对于预算有限者,Mac Studio或国产AI加速卡提供了更具实用价值的替代方案。
随着大语言模型从云端走向边缘,本地部署已成为技术爱好者的必修课,硬件不再仅仅是计算工具,而是决定你能否流畅运行70B参数模型、能否实现低延迟推理的关键瓶颈,很多初学者容易陷入“唯参数论”的误区,认为核心数越多越好,却忽视了显存容量和带宽对模型加载速度的决定性影响。
显存容量:决定模型大小的硬门槛
在本地运行大模型时,显存(VRAM)是首要考量指标,模型权重必须完全载入显存才能实现极速推理,否则频繁在内存和显存间交换数据会导致速度断崖式下跌。
不同显存容量的适用场景
业内专家指出,显存大小直接决定了你所能调用的模型规模,以下是基于2026年主流模型压缩技术下的通用参考:
- 8GB-12GB显存:仅适合运行量化后的7B-13B小参数模型,或用于简单的文本生成任务,适合入门学习,但面对复杂逻辑推理时会感到吃力。
- 16GB-24GB显存:这是个人创作者的“甜点区”,可以流畅运行30B-40B参数的模型,或者通过模型并行技术运行70B模型,NVIDIA RTX 3090/4090凭借24GB大显存,依然是构建本地AI实验室的主力军。
- 48GB及以上显存:适合专业开发者和企业级应用,单卡即可运行未经量化的70B模型,或双卡/多卡协同运行更大规模的基座模型。
显存带宽的重要性
除了容量,带宽同样关键,HBM3显存相比传统GDDR6,在相同容量下能提供数倍的数据吞吐率,这意味着即使两张卡显存相同,搭载HBM3的硬件在生成Token的速度上也会显著领先。
算力芯片对比:NVIDIA、Apple与国产阵营
2026年的硬件生态更加多元化,不同芯片架构在AI推理和训练上的表现各有千秋。
NVIDIA GPU:生态霸主地位稳固
CUDA生态依然是AI开发的默认标准,绝大多数开源模型、框架和教程都优先支持NVIDIA硬件,对于希望无缝接入Hugging Face社区资源的用户来说,NVIDIA显卡几乎是唯一选择,尽管价格较高,但其兼容性和稳定性降低了开发中的调试成本。
Apple Silicon:能效比与统一内存优势
Mac Studio或配备M系列芯片的MacBook Pro凭借统一内存架构,在运行大模型时展现出独特优势,用户可以将高达192GB的统一内存视为显存使用,这意味着用相对低廉的成本就能加载超大参数模型。
- 优势:静音、低功耗、无需额外散热设备。
- 劣势:推理速度通常慢于同价位NVIDIA显卡,且部分底层算子优化不如CUDA成熟。
- 适用人群:注重便携性、主要进行推理而非训练的用户。
国产AI加速卡:性价比与自主可控
近年来,华为昇腾、寒武纪等国产芯片在软件栈优化上取得突破,对于关注数据隐私、有国产化替代需求的机构,这些硬件提供了可行的解决方案,虽然生态丰富度尚不及NVIDIA,但在特定场景下的性价比极具竞争力。
2026年主流硬件配置推荐与价格区间
根据预算和需求,以下是几类典型配置建议,数据基于2026年市场平均水平,具体价格随供需波动。
入门级:学习与实践
- 配置:二手RTX 3090 24GB 或 RTX 4060 Ti 16GB
- 预算范围:人民币3000-6000元
- 适用模型:Llama-3-8B, Qwen-7B(量化版)
-
特点:低成本入门,适合理解大模型基本原理,体验本地部署流程。
进阶级:高效开发与创作
- 配置:RTX 4090 24GB 或 Mac Studio M2 Ultra
- 预算范围:人民币15000-30000元
- 适用模型:Llama-3-70B(量化版), Qwen-72B, Mixtral-8x7B
- 特点:平衡性能与成本,能够处理大多数复杂任务,支持微调小型模型。
专业级:模型训练与大规模推理
- 配置:双RTX 4090 或 A100/H100租赁/购买
- 预算范围:人民币50000元以上
- 适用模型:全参数微调70B+模型,私有化部署企业级知识库
- 特点:极致性能,适合专业团队进行模型迭代和大规模数据处理。
组装建议
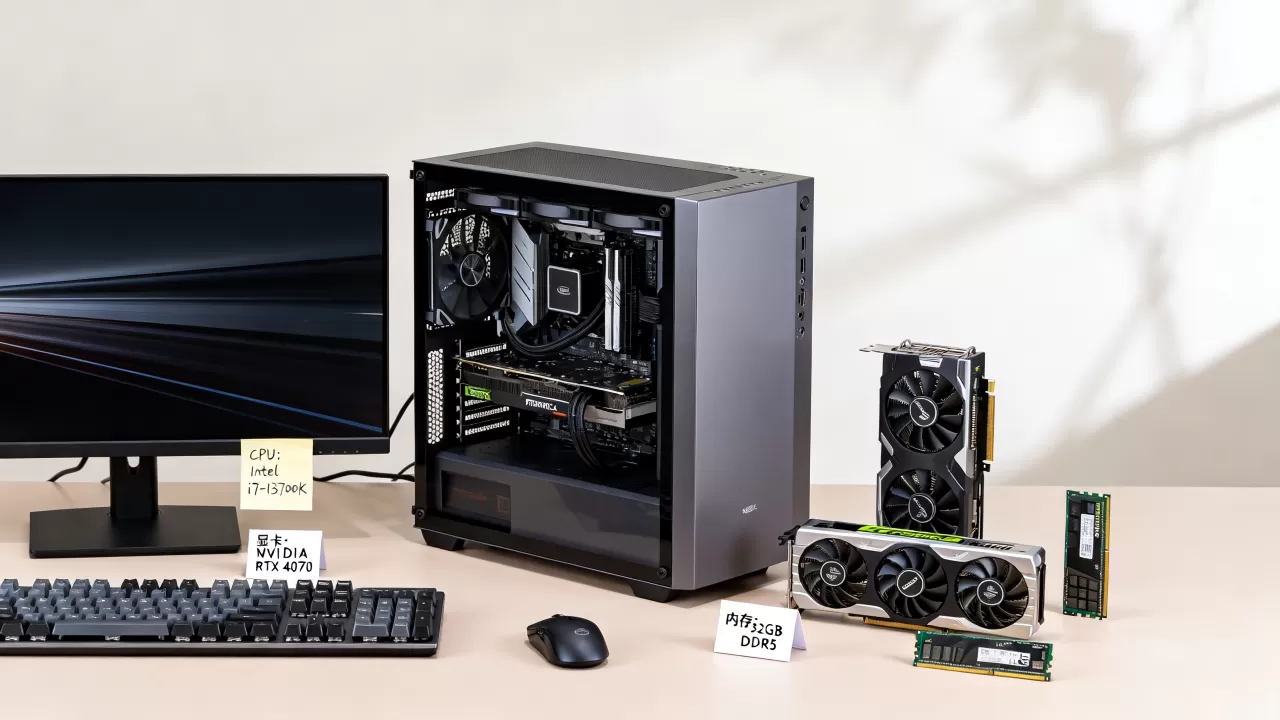
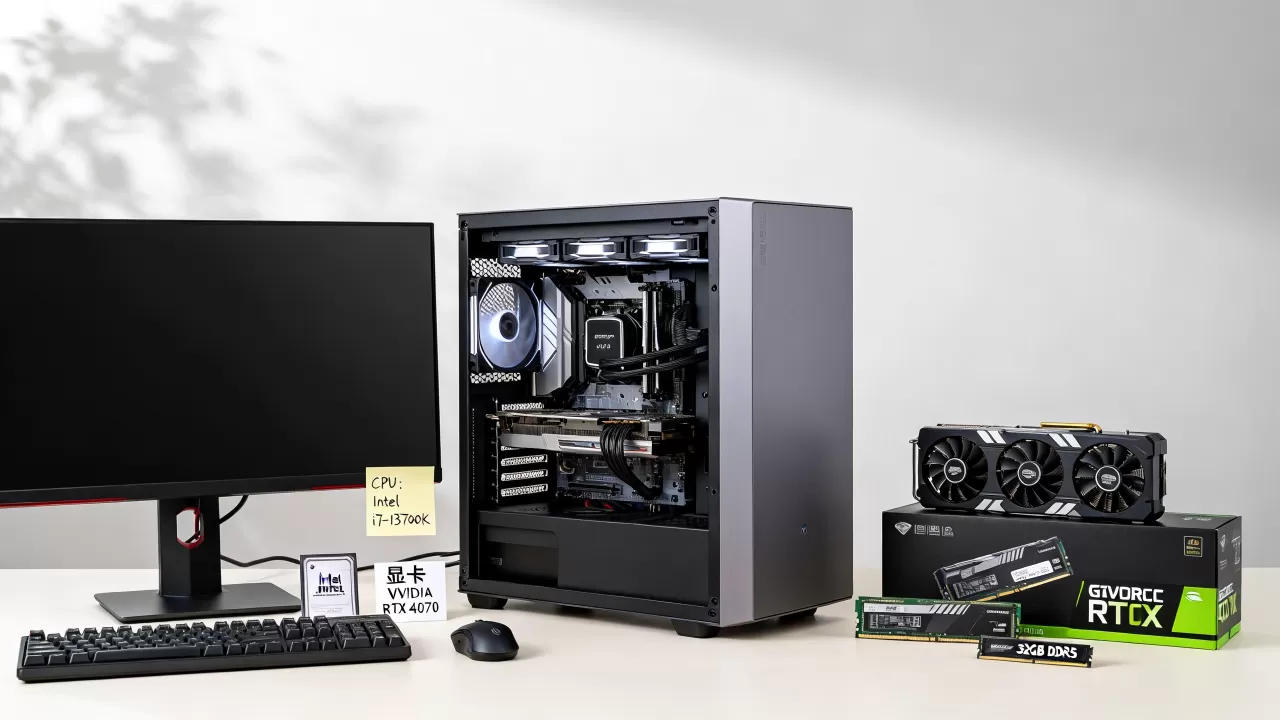
若选择DIY组装NVIDIA平台,请注意电源功率需预留至少800W余量,并确保机箱散热良好,多卡并行时,需关注PCIe通道数和主板支持情况,避免带宽瓶颈。
实操指南:如何搭建本地AI环境
拥有硬件后,软件环境的搭建同样重要,以下是标准化的操作流程,适用于大多数Linux和Windows用户。
第一步:安装基础驱动与CUDA
对于NVIDIA用户,确保安装最新版本的显卡驱动和CUDA Toolkit,这是运行大多数AI框架的前提。
第二步:选择推理框架
目前主流的本地推理框架包括Ollama、LM Studio和Text Generation WebUI。
- Ollama:适合命令行用户,安装简单,支持一键拉取模型。
- LM Studio:提供图形界面,适合新手快速测试不同模型效果。
- Text Generation WebUI (oobabooga):功能最丰富,支持多种模型格式和插件扩展,适合进阶用户。
第三步:模型下载与量化
从Hugging Face或ModelScope下载模型时,优先选择GGUF格式的模型,以便在CPU和NPU上也能获得较好性能,使用llama.cpp等工具对模型进行量化(如Q4_K_M),可在保持较高精度的同时大幅降低显存占用。
第四步:测试与优化
运行基准测试脚本,监控GPU利用率、温度和显存占用,根据结果调整批处理大小(Batch Size)和上下文长度(Context Length),以找到性能与速度的最佳平衡点。
AI大模型学习硬件常见问题解答
AI大模型学习硬件怎么选性价比最高?
性价比最高的选择取决于你的具体任务,如果主要进行推理,二手RTX 3090 24GB是目前公认的高性价比之选,因其大显存能运行较大参数模型,若预算充足且追求最新技术,RTX 4090是最佳选择,对于非NVIDIA用户,Mac Studio M系列芯片在统一内存优势下,能以较低成本实现大模型加载,适合对速度要求不极致的用户。
本地部署大模型需要多大内存?
系统内存(RAM)主要用于模型加载前的预处理和量化转换,若显存不足,系统内存可充当临时交换空间,但速度极慢,建议系统内存至少为16GB,若计划运行超大模型且显存不足,建议配置32GB或64GB以上系统内存,并启用Swap分区,对于纯GPU推理,系统内存只需满足操作系统和基础应用需求即可,重点仍在于显存容量。
2026年国产AI硬件能否替代NVIDIA?
在推理场景下,国产AI硬件如华为昇腾910B等已能较好支持主流大模型,且在特定行业应用中具备成本和政策优势,在开发生态、社区支持和模型兼容性方面,NVIDIA仍占据主导地位,对于个人学习者和初创团队,NVIDIA仍是更稳妥的选择;对于有明确国产化需求或大规模部署的企业,国产硬件正成为可行的替代方案,但需投入更多精力进行适配和优化。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/378267.html