在服务器上运行深度学习(Deep Learning)是一个系统工程,涉及硬件配置、环境搭建、代码优化和任务调度等多个环节,以下是详细的操作指南,分为 准备阶段、环境配置、代码运行 和 进阶优化 四个部分。
第一阶段:前期准备与硬件检查
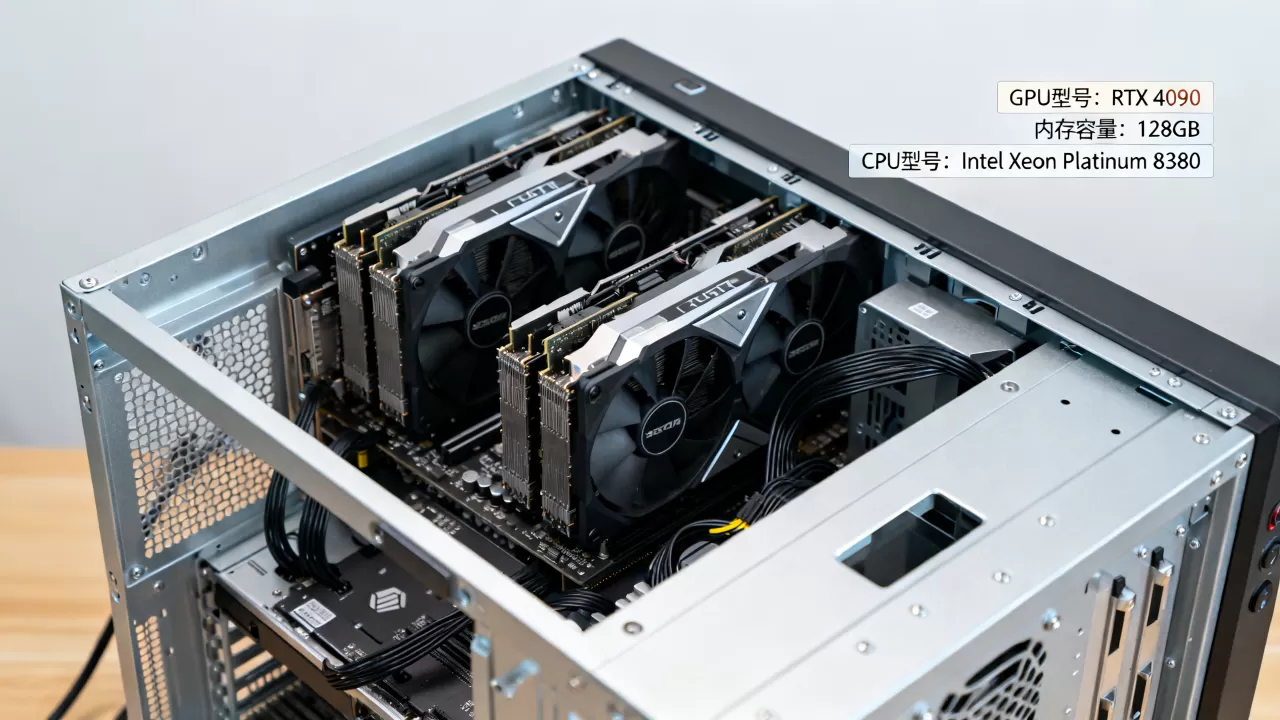
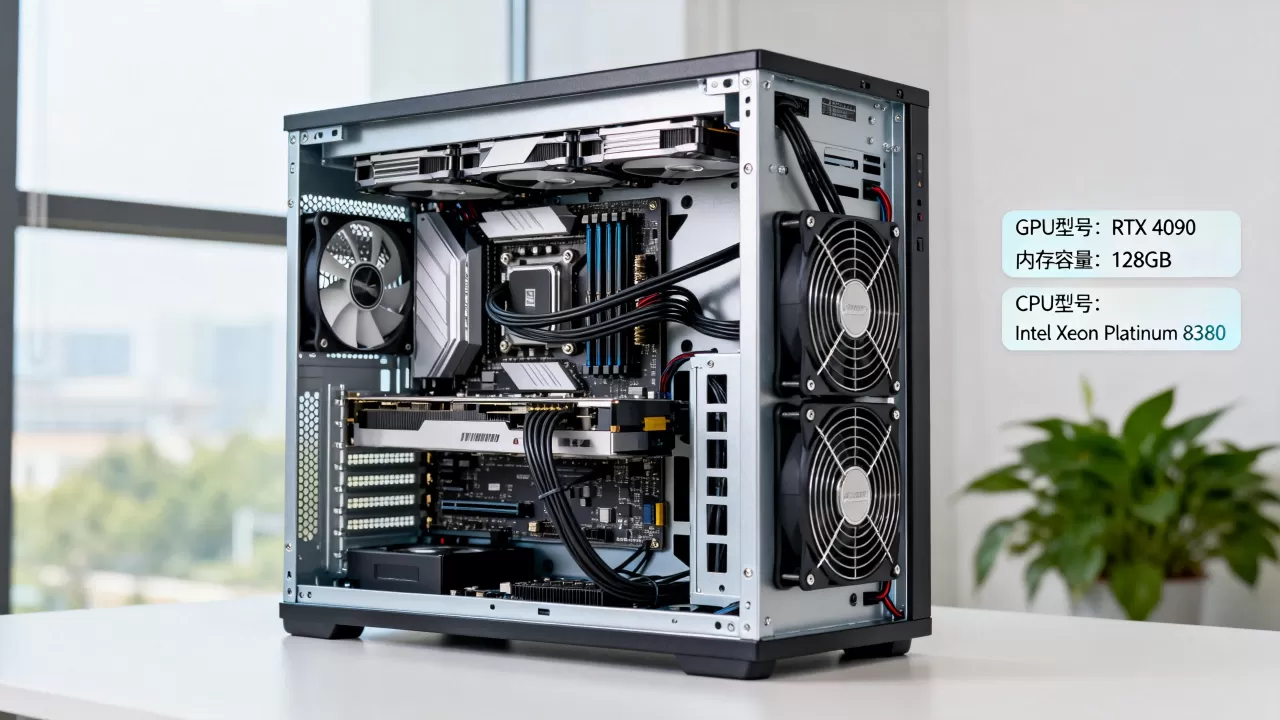
在开始之前,你需要确认服务器的硬件资源是否满足需求。
-
检查 GPU 资源
深度学习主要依赖 GPU 加速,登录服务器后,使用以下命令检查显卡状态:nvidia-smi
- 查看显存(Memory-Usage)是否充足。
- 查看驱动版本(Driver Version)和 CUDA 版本(CUDA Version)。
-
检查 CPU 和内存
- 数据预处理通常消耗大量 CPU 资源。
nproc          # 查看 CPU 核心数
free -h        # 查看内存使用情况
- 数据预处理通常消耗大量 CPU 资源。
-
网络连接
- 确保服务器能访问互联网,以便下载数据集和依赖包。
- 如果服务器在内网,可能需要配置代理(Proxy)。
第二阶段:环境配置(核心步骤)
推荐使用 Anaconda/Miniconda 管理 Python 环境,使用 Docker 隔离环境(可选但推荐)。
方案 A:使用 Conda(最常用)
-
创建虚拟环境
conda create -n dl_env python=3.9
conda activate dl_env
-
安装 PyTorch 或 TensorFlow
- PyTorch 示例
(根据
nvidia-smi显示的 CUDA 版本选择):# CUDA 11.8 pip install torch torchvision torchaudio --index-url https://download.pytorch.org/whl/cu118
- TensorFlow 示例:
pip install tensorflow-gpu # 注意:TF 2.x 默认支持 GPU,无需单独安装 -gpu 版本
- PyTorch 示例
-
安装其他常用库
pip install numpy pandas matplotlib opencv-python scikit-learn
方案 B:使用 Docker(推荐用于生产环境)
Docker 可以确保环境一致性,避免“在我机器上能跑”的问题。
- 拉取官方镜像:
docker pull nvidia/cuda:11.8.0-devel-ubuntu22.04
- 启动容器并挂载代码和数据目录:
docker run -it --gpus all -v /host/path/to/code:/code -v /host/path/data:/data nvidia/cuda:11.8.0-devel-ubuntu22.04 /bin/bash
第三阶段:代码运行与调试
数据准备
- 将数据集上传到服务器(使用
scp、rsync或wget)。 - 建议:将数据集放在高速存储(如 SSD 或 NVMe)上,避免 I/O 瓶颈。
- 如果使用大型数据集,考虑转换为高效格式(如 TFRecord、LMDB 或 Parquet)。
编写训练脚本
确保代码中正确调用 GPU:
import torch
# 检查 GPU 是否可用
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
print(f"Using device: {device}")
# 将模型和数据移动到 GPU
model = model.to(device)
data = data.to(device)
后台运行(防止断开连接中断训练)
使用 nohup 或 screen/tmux 保持进程在后台运行。
- 使用 nohup:
nohup python train.py > train.log 2>&1 &
- 使用 tmux(推荐):
tmux new -s dl_session  # 创建新会话
python train.py         # 运行代码
# 按 Ctrl+B, 然后按 D 退出会话(程序仍在后台运行)
# 使用 tmux attach -t dl_session 重新进入
监控训练过程
- 实时监控 GPU:
watch -n 1 nvidia-smi
- 记录日志:使用 TensorBoard 或 Weights & Biases (W&B) 可视化训练曲线。
tensorboard --logdir=./logs --host=0.0.0.0 --port=6006
注意:如果服务器无图形界面,需通过本地浏览器映射端口访问。
第四阶段:进阶优化与常见问题
多卡并行(Multi-GPU)
如果服务器有多张 GPU,可以使用 PyTorch 的 DistributedDataParallel (DDP) 或 DataParallel (DP)。
# 简单示例:使用 DataParallel
model = torch.nn.DataParallel(model).to(device)
显存优化
- 梯度累积(Gradient Accumulation):当 batch size 太大导致 OOM(Out Of Memory)时,可减小 batch size 并增加梯度累积步数。
- 混合精度训练(AMP):使用
torch.cuda.amp加速训练并减少显存占用。
scaler = torch.cuda.amp.GradScaler()
with torch.cuda.amp.autocast():
    outputs = model(inputs)
    loss = criterion(outputs, labels)
scaler.scale(loss).backward()
scaler.step(optimizer)
scaler.update()
常见错误排查
| 问题 | 可能原因 | 解决方案 |
|---|---|---|
CUDA out of memory |
显存不足 | 减小 batch size;使用梯度累积;检查是否有僵尸进程占用显存(fuser -v /dev/nvidia) |
No module named 'torch' |
环境未激活 | 执行 conda activate dl_env |
Permission denied |
权限不足 | 使用 sudo 或修改文件权限 chmod |
| 训练速度极慢 | CPU 瓶颈 | 增加 DataLoader 的 num_workers;使用 SSD 存储数据 |
总结流程图
graph TD
    A[登录服务器] --> B[检查 GPU: nvidia-smi]
    B --> C{选择环境方案}
    C -->|轻量级| D[Conda 创建环境]
    C -->|生产级| E[Docker 容器]
    D --> F[安装 PyTorch/TF]
    E --> F
    F --> G[上传数据与代码]
    G --> H[配置 DataLoader 优化 I/O]
    H --> I[后台运行训练: nohup/tmux]
    I --> J[监控: nvidia-smi + TensorBoard]
    J --> K{训练完成?}
    K -->|否| I
    K -->|是| L[保存模型 & 清理资源]
如果你是初学者,建议从 单卡 + Conda + 小数据集 开始,熟悉流程后再扩展到多卡和大模型。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/481218.html