华为DWS使用C程序开发并不复杂,核心流程就是“环境准备->头文件引入->连接管理->SQL执行->结果处理”,这五个环节走通,基本就能应对绝大多数业务场景。
华为DWS(GaussDB(DWS))作为企业级数据仓库,官方推荐的接口包括JDBC、ODBC、Python和C API,很多人误以为C程序在DWS上很难跑通,实际上它的libpq库已经封装好了底层通信协议,用起来比想象中顺手,下面结合我自己的实操经验,把从零开始到上线部署的完整链路拆开讲清楚。

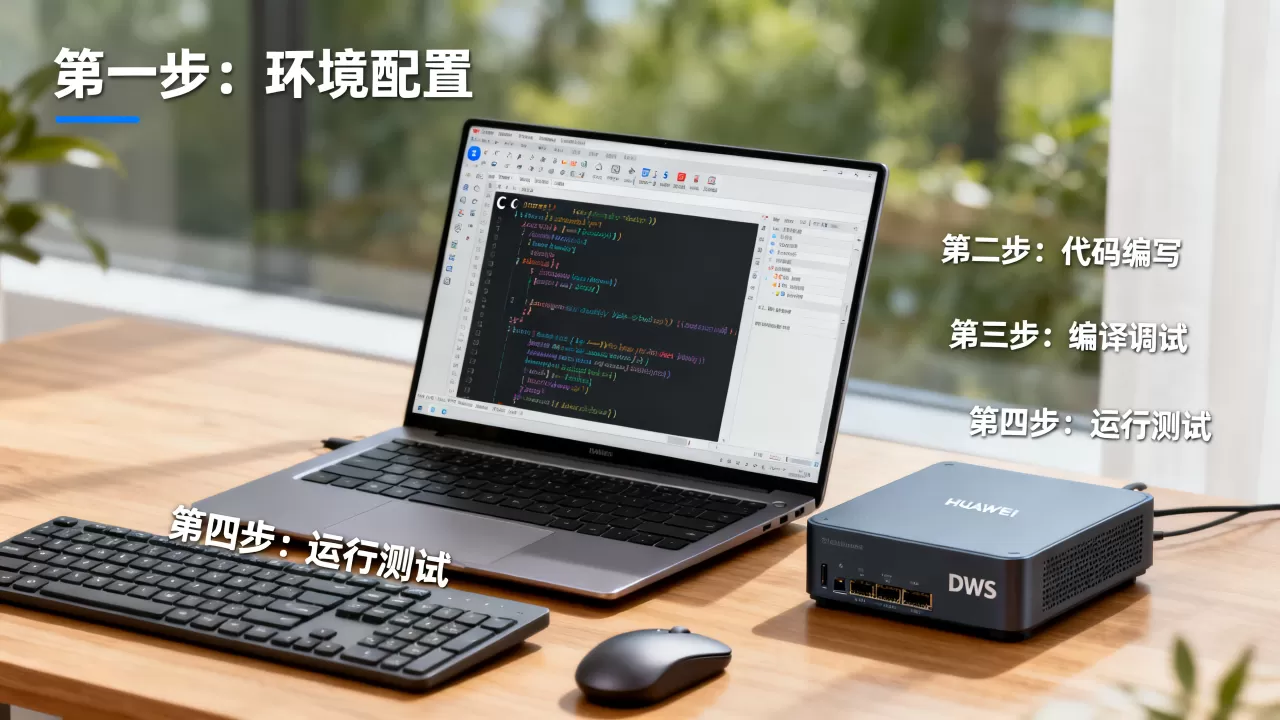
华为dws使用流程中的C程序连接步骤
C程序接入DWS,第一步不是写代码,而是搞清楚你的网络和账号权限,DWS集群默认只在VPC内部开放端口,如果你本机直连,大概率会卡在连接超时这一步。
前置环境检查清单
在动手写代码之前,先对照下面这组条件自查,能省掉后续大量排查时间:
- 获取集群的内网IP和数据库端口(默认8000),在DWS控制台的“集群详情”页面可以看到。
- 确保客户端机器与DWS集群处于同一VPC,或者已配置好对等连接与安全组放行规则。
- 准备好数据库管理员账号或具有对应schema读写权限的业务账号。
- 确认操作系统是Linux x86_64或ARM架构,DWS官方驱动包对这两种架构支持最完善。
- 安装gcc编译器,版本建议4.8.5以上,因为DWS的C头文件用到了部分C99标准特性。
获取并编译libpq驱动
DWS的C语言驱动本质是PostgreSQL的libpq增强版,但千万别直接拿开源的libpq编译,两者在认证协议和加密传输上有差异,正确做法是:
- 登录华为云官网,进入DWS产品页,在“下载客户端”区域找到DWS Linux版C SDK压缩包。
- 解压后目录结构包含
include和lib两个子目录,include里有postgresql/libpq-fe.h,lib里有libpq.so和libpgport.a。 - 编译时用
gcc -I./include your_program.c -L./lib -lpq -o your_program,注意还需要加上-lssl -lcrypto,因为DWS默认开启SSL连接。
这里有个坑务必记住:运行时会报“libpq.so.5: cannot open shared object file”,解决办法是把
lib目录路径加入/etc/ld.so.conf,然后执行ldconfig。
华为dws C程序开发环境搭建与连接池配置
环境搭好只是开始,真正决定程序健壮性的是连接管理方式,DWS对并发连接数有限制,默认单CN节点最大连接数是200左右,如果每次请求都建立新连接,业务量稍大就会触发“sorry, too many clients already”错误。
连接参数的结构体设置
DWS的C API使用PQconnectdb函数建立连接,参数透传走的是连接字符串,一个最简配置长这样:
PGconn conn = PQconnectdb("host=192.168.1.10 port=8000 dbname=postgres user=admin password=your_pwd sslmode=require");
if (PQstatus(conn) != CONNECTION_OK) {
    fprintf(stderr, "连接失败: %s", PQerrorMessage(conn));
}
实际项目中,建议把连接参数集中放在配置文件中,用PQconnectdbParams按key-value数组传入,避免密码硬编码在代码里,同时把connect_timeout设为5秒,keepalives_idle设为180秒,防止网络抖动导致连接假死。
手写连接池的取舍
很多C程序员习惯自己搞一个简单的连接池,用pthread_mutex锁保护空闲队列,这种方案在并发低于50时完全够用,代码也就一百行左右,一旦超过这个规模,建议直接上成熟的连接池中间件,比如pgbouncer,它能以事务级复用连接,把有效并发放大数倍。
行业共识认为,连接池的最小空闲连接数应设为集群CN节点数的两倍,最大连接数不要超过DWS允许上限的80%,预留20%给管理操作和临时查询,避免业务高峰把所有连接都占满。
C程序操作DWS的SQL执行与结果处理细节
连接建立后,接下来就是SQL执行环节,这一部分最能体现C API的设计哲学:它给了你所有控制权,但也要求你管好内存和错误状态。
执行查询的推荐模式
标准流程是“PQsendQuery -> PQgetResult循环 -> PQclear释放”,不建议使用老的PQexec,虽然它一步到位,但在大批量数据拉取时,它会一次性把结果集加载进内存,容易把客户端内存顶爆,改用异步模式:
PQsendQuery(conn, sql);
while ((res = PQgetResult(conn)) != NULL) {
    int rows = PQntuples(res);
    for (int i = 0; i < rows; i++) {
        char val = PQgetvalue(res, i, 0);
        // 业务处理
    }
    PQclear(res);
}
这种写法配合PQsetSingleRowMode,可以实现逐行流式读取,处理千万级查询结果时内存占用恒定不变,这是DWS C开发中最实用的技巧之一。
异常事务与回滚
由于DWS支持完整的事务ACID特性,C程序中必须显式处理事务边界,常见的坑是:某条SQL执行失败后,事务仍处于中断状态,后续所有语句都会报“current transaction is aborted”。
正确做法是在每条语句执行后检查PQresultStatus的返回值,如果是PGRES_FATAL_ERROR,立即执行ROLLBACK,再决定是否重试或退出,同时建议在事务开启前设置SET statement_timeout = 30000,防止慢SQL拖死连接。
华为DWS的C程序性能调优和批量写入实测经验
DWS作为列式存储仓库,最忌讳C程序像操作MySQL那样,一条一条insert。行存表每秒最多只能扛住几百条的单条写入,而列存表批量导入能跑出每秒数百万行的吞吐。
批量导入的正确姿势
先创建外部表指向数据文件,再用INSERT INTO SELECT或者COPY命令装载,如果你数据已经生成在内存里,更推荐用COPY的二进制格式:
PGresult res = PQexec(conn, "COPY my_table FROM STDIN WITH BINARY");
然后通过PQputCopyData连续发送二进制数据块,最后发送PQputCopyEnd结束,实测下来,二进制COPY比文本COPY快30%以上,比单行INSERT快了不止两个数量级,如果你做的是实时数据接入,这个手法必须掌握。
减少网络往返的技巧
C程序与DWS交互,每一次PQexec都是一次完整的网络往返,对于批量参数化查询,可以用PQprepare和PQexecPrepared走预编译路径,将解析和规划开销削减一半,在OLAP场景下,如果多个SQL之间有依赖关系,可以考虑用DWS的存储过程封装,把一段复杂逻辑放进数据库端执行,C程序只负责调用,这样能大幅减少跨网络的数据传输。
部署运维阶段C程序的常见坑与排查手段
开发调试通过后,部署到生产环境又会冒出一堆新问题,这阶段最容易踩的坑是
数据库版本兼容性,DWS在持续演进,小版本升级后,老编译的C程序可能因为协议字段变化而异常,建议每次DWS集群升级后,重新用新版的SDK编译一次程序,宁可多花十分钟,也不要在半夜被告警吵醒。
还有一点比较隐蔽:DNS解析时长,C程序运行在K8s或容器环境里,连接串如果写的是域名而非常量IP,每次新建连接都会触发一次DNS查询,最坏情况会引入数百毫秒延迟,解决思路很直接,在/etc/hosts里固定映射,或者直接改用IP。
遇到问题先查PQerrorMessage的输出,再结合DWS的pg_stat_activity视图看当前会话在做什么,比如出现“Cannot get hostname for your address”这类报错,多半是DWS的log_hostname参数导致的反查超时,直接在集群参数组里关掉就好了。
华为DWS C开发常见问题解答
华为dws使用流程中,C程序连接不上集群怎么排查?
先确认安全组入方向规则是否放行了客户端IP对应端口,然后从客户端机器测试telnet 集群IP 8000,能通就检查pg_hba.conf里是否允许该IP网段的连接方式,不能通就用gs_guc工具检查监听配置,最后再用PQconnectdb打印出的错误信息定位。
C程序读写DWS的性能损耗主要来自哪里?
损耗排前三的因素是:网络往返次数、结果集解析方式、事务提交频率,网络往返用批量处理压缩,结果集解析用二进制模式减少转换开销,事务按批次提交而不是每条SQL一个提交点。
DWS的C驱动和JDBC驱动怎么选?
高吞吐、低延迟要求下C驱动更有优势,典型场景是实时数据采集、证券交易明细入库这类延迟敏感业务,JDBC在生态兼容性和快速开发上更强,适合报表分析类应用,小团队首选JDBC,C开发适合已有C代码资产或对内存占用极其敏感的场景。
最终还是要回到业务本身,如果你的团队已经有成熟的C语言基础库,那dws完全能接纳你现有的代码资产,按照上面这套流程走一遍,从环境搭建到生产落地,多数情况下一个礼拜内就能跑完验证,记住核心运维口诀:连接要复用、入库要走COPY、异常必须回滚,把这三件事抓实,你的C程序在DWS上跑得会比想象中更稳。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/590294.html