

大模型的监管核心在于建立“技术可控、责任可溯、安全可信”的动态平衡体系,而非简单的禁止或放任。
随着生成式人工智能从概念走向大规模落地,监管不再是悬在头顶的达摩克利斯之剑,而是行业健康发展的基础设施,2026年的监管环境已经发生了根本性转变,从早期的“野蛮生长”转向了“精细化治理”,企业不再需要猜测红线在哪里,而是拥有了一套清晰的操作指南,这种转变不仅降低了合规成本,更让优质内容得以在安全边界内自由流动。
大模型监管的核心逻辑与合规框架
监管的本质不是扼杀创新,而是确立边界,在当前的行业共识中,合规被视为大模型企业的核心竞争力之一。
算法备案与内容安全机制
对于国内的大模型开发者而言,完成算法备案是产品上线的前置条件,这并非形式主义的过场,而是对模型底层逻辑的一次全面体检。
备案流程的关键节点
- 主体资质审核:企业需证明其具备相应的技术能力、安全保障措施及法律责任承担能力。
- 算法机制测评:重点评估模型的价值观对齐情况、偏见消除能力以及生成内容的可控性。
- 安全评估报告:提交针对数据隐私保护、内容过滤机制的详细文档,确保模型不会生成违法不良信息。
业内专家指出,通过备案的过程,实际上也是企业自我纠偏的过程,许多初创团队在准备材料时,才发现自身数据清洗环节的漏洞,从而在上线前修复了潜在风险。
数据源头的合规治理
数据是大模型的燃料,也是监管的重点区域,未经授权的爬虫数据、侵犯版权的作品、包含个人隐私的信息,都是监管红线。
- 版权授权链条:企业必须确保训练数据拥有合法的使用权,这包括与出版社、图片库、代码平台签署正式授权协议。
- 个人信息去标识化
:在数据预处理阶段,必须采用技术手段对姓名、身份证号、联系方式等敏感信息进行脱敏处理。
- 数据来源透明度:建立完整的数据溯源档案,确保每一条训练数据都可追溯、可审计。
大模型监管中的责任界定与风险防控
当模型生成错误信息或造成损失时,责任由谁承担?这是用户和企业最关心的问题。
的责任归属
目前的主流观点认为,模型提供者承担主要的安全保障义务,而使用者承担内容使用的主体责任。
场景化责任划分
| 场景类型 | 主要责任方 | 具体说明 |
|---|---|---|
| 模型自身缺陷导致错误 | 模型提供者 | 如模型因训练数据偏差导致系统性歧视或事实性错误。 |
| 用户恶意诱导生成违规内容 | 用户 | 用户故意通过提示词工程绕过安全限制,生成违法信息。 |
| 第三方插件导致的数据泄露 | 插件开发者/平台 | 若模型调用的外部API存在安全漏洞,需依据合同约定划分责任。 |
这种责任划分机制,促使企业在设计产品时,必须嵌入更强大的用户行为监控和风险提示功能。
深度伪造与身份认证
随着AI生成视频和音频技术的普及,深度伪造(Deepfake)成为监管的新焦点。
- 强制标识义务:所有由AI生成的内容,必须在显著位置标注“AI生成”标识,这不仅是道德要求,更是法律义务。
- 水印技术嵌入:在图像、视频、音频的底层数据中嵌入不可见的数字水印,以便后续追踪和鉴别。
- 身份核验机制:对于涉及公众人物或敏感话题的生成内容,平台需建立更严格的人工审核或二次AI复核机制。
企业如何应对2026年大模型监管新规
面对日益完善的监管体系,企业不应视其为负担,而应将其视为构建信任的契机。
建立内部合规委员会
大型企业应设立专门的合规部门,由法律、技术、伦理专家共同组成。
- 定期审计:每季度对模型进行一次全面的安全评估,模拟各种极端输入场景,测试模型的鲁棒性。
- 快速响应机制:建立7×24小时的内容监控热线,一旦发现违规内容,能在分钟级内完成下架和处理。
- 员工培训:定期对研发和运营人员进行合规培训,确保每个人都能理解监管要求背后的逻辑。
技术层面的主动防御
合规不能仅靠人力,必须依靠技术手段。
- 红队测试(Red Teaming):组建专门的“红队”,模拟黑客或恶意用户,不断攻击模型的安全防线,找出漏洞并修复。
- 实时过滤系统:在模型输出端部署实时过滤器,对敏感词、违规图片、危险指令进行拦截。
- 版本迭代管理:每次模型升级前,必须进行回归测试,确保新功能不会引入新的安全风险。
用户教育与透明度报告
信任源于透明,企业应定期发布透明度报告,公开模型的能力边界、局限性以及处理用户投诉的数据。
- 能力边界说明:明确告知用户模型在数学计算、实时新闻、医疗诊断等领域的局限性,避免用户过度依赖。
- 投诉处理流程:提供便捷的反馈渠道,让用户能够轻松举报不当内容,并告知处理结果。
- 伦理准则公示:公开企业的AI伦理准则,展示企业在公平性、包容性、可持续性方面的承诺。
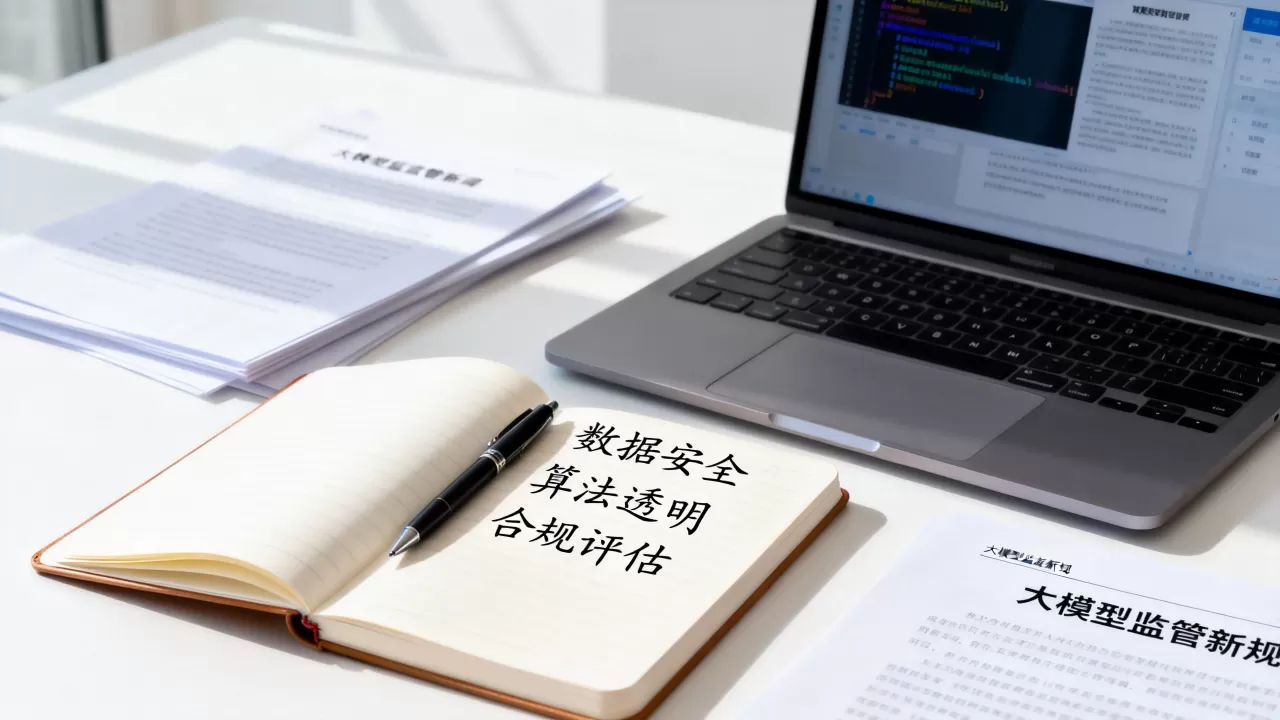
大模型监管的未来趋势与展望
监管不是一成不变的,它将随着技术的发展而动态调整。
从“事前审批”到“事中监测”
未来的监管将更加注重过程管理,监管机构可能会引入自动化监测工具,实时跟踪模型运行状态,而非仅仅依赖事前的备案。
国际标准的协调与合作
大模型无国界,但监管有边界,各国将在数据跨境流动、版权保护、安全标准等方面加强合作,推动形成全球统一的监管框架。
技术驱动的监管科技(RegTech)
监管本身也将智能化,利用AI技术来监测AI行为,将成为主流,使用专门的安全模型来识别其他大模型的潜在风险,提高监管效率。
Q&A:大模型监管常见疑问解答
大模型监管Regulation对中小企业影响大吗?
影响是显著的,但并非不可逾越,中小企业可以通过采用成熟的第三方合规服务、接入具备合规资质的大模型API来降低合规成本,监管政策的细化也为中小企业提供了清晰的指引,避免了因盲目探索而触碰红线。
大模型监管Regulation如何平衡创新与安全?
平衡的关键在于“分级分类”管理,对于高风险应用(如医疗、金融、自动驾驶),实行严格的准入和实时监测;对于低风险应用(如创意写作、日常聊天),则采取包容审慎的态度,鼓励创新,这种差异化监管既保障了公共安全,又释放了技术潜力。
大模型监管Regulation的具体执行标准在哪里查询?
具体执行标准通常由工信部、网信办等主管部门发布,企业应密切关注官方渠道发布的最新政策文件、技术标准指南以及合规指引,行业协会也会定期发布自律公约和最佳实践案例,供企业参考,据工信部数据,目前已有数十项人工智能相关国家标准正在制定或实施中,为企业提供了明确的操作依据。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/403286.html


评论列表(1条)
码住!“技术可控、责任可溯、安全可信”这句太戳了——之前公司测模型,光是提示词滥用就踩了三回红线,现在终于有谱了…mar