在Java中单独使用MapReduce最直接的方式是利用Hadoop的本地模式,通过配置mapreduce.framework.name=local,无需搭建集群即可运行MapReduce任务,适合学习和小规模数据处理。
Java单独使用MapReduce的本地模式配置
依赖环境准备
即使只打算在单机上跑MapReduce,也需要安装Hadoop发行版,你不需要启动任何守护进程,只用到了它的库文件和配置文件,按照这个Java单独使用MapReduce教程,你只需以下几步:

- 下载Hadoop二进制包,解压到本地目录,比如
C:hadoop或/usr/local/hadoop。 - 设置环境变量
HADOOP_HOME,并将$HADOOP_HOME/bin加入PATH。 - 在
$HADOOP_HOME/etc/hadoop/core-site.xml中配置fs.defaultFS为file:///,告诉框架使用本地文件系统。 - 在同一个目录下的
mapred-site.xml中配置mapreduce.framework.name为local,明确指定运行模式。 - 确保Hadoop的JAR包(如
hadoop-common、hadoop-mapreduce-client-core等)被项目引用,如果使用Maven,在pom.xml中添加依赖,版本号与安装的Hadoop保持一致。
行业共识认为,本地模式是学习MapReduce的最佳起点,因为它消除了集群环境的复杂性,让你专注于逻辑本身。
编写第一个MapReduce程序
一个标准程序包含三个核心部分:Mapper、Reducer和Driver(Job配置),下面是一个词频统计示例的骨架。
Mapper类:
- 继承
Mapper<LongWritable, Text, Text, IntWritable>。 - 重写
map方法,从输入行中提取单词,输出<单词, 1>。
Reducer类:
- 继承
Reducer<Text, IntWritable, Text, IntWritable>。 - 重写
reduce方法,对相同单词的计数求和,输出最终结果。
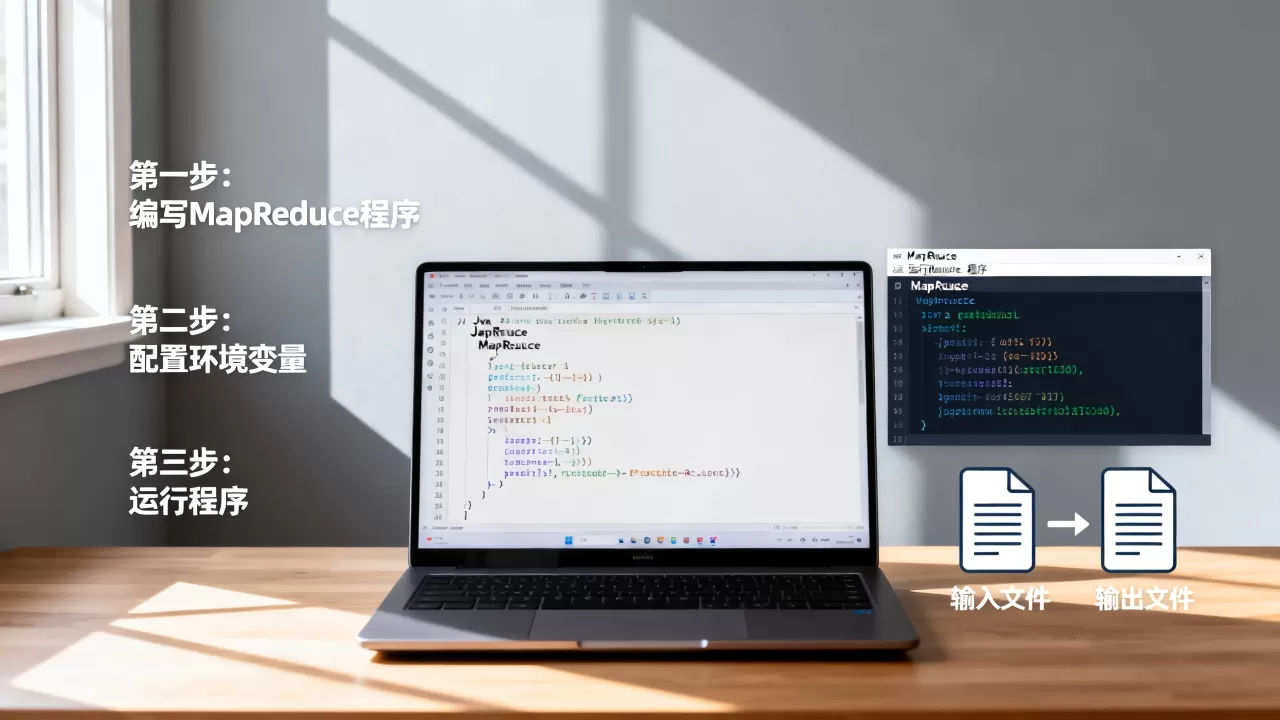
Driver类:
- 创建
Job实例,通过Job.getInstance()获取。 - 设置Mapper和Reducer类,以及它们的输出键值类型。
- 指定输入输出路径,使用
FileInputFormat.addInputPath和FileOutputFormat.setOutputPath。 - 调用
job.waitForCompletion(true)提交任务,本地模式下,任务会直接在当前JVM中运行。
本地运行与调试
本地模式最大的优势是调试简单,你可以在Mapper和Reducer里直接使用System.out.println输出日志,这些内容会打印在控制台,在IDE中设置断点,还可以单步跟踪,具体操作路径如下:
- 在IDE中创建一个Java类,包含main方法,把Driver代码放在里面。
- 设置输入路径为一个本地文件夹,里面放几个小文件作为测试数据。
- 设置输出路径为一个不存在的目录,每次运行前手动删除或让程序自动清理。
- 直接运行main方法,控制台会显示任务进度和日志。
对于初学者,这是快速验证逻辑的绝佳方式,你不需要任何集群知识,就能看到MapReduce的工作流程。
使用MapReduce框架时的常见问题
数据倾斜问题
当数据分布不均匀时,某些Reducer会处理大量数据,导致任务缓慢,在本地模式下,因为数据量小,倾斜不明显,但当你切换到集群模式时,这会是主要瓶颈,解决方案包括:
- 使用自定义分区器,根据业务逻辑均匀分配数据。
- 在Map端进行预聚合,减少传输量。
- 使用Combiner类,合并局部结果后再传给Reducer。
小文件问题
HDFS擅长处理大文件,大量小文件会导致NameNode压力过大,在本地模式下,文件系统直接是本地磁盘,所以小文件问题不突出,但如果你需要将本地程序迁移到集群,就要考虑使用
CombineFileInputFormat来合并小文件,减少Map任务数量。
业内专家指出,在本地学习阶段,可以忽略小文件问题,但进入生产环境前必须处理。
使用MapReduce处理大数据的实际场景
数据清洗与去重
许多数据清洗任务可以用MapReduce轻松完成,读取电商订单日志,使用Mapper提取用户ID和商品ID,Reducer中根据用户ID去重,最终输出唯一记录,本地模式下,你可以先处理一小部分数据验证逻辑,再全量运行,具体步骤:
- 编写Mapper,过滤出需要的字段,输出
<用户ID, 商品ID>。 - 在Reducer中,只输出一次每条记录,实现去重。
- 如果需要,使用MultipleOutputs将结果写入不同文件。
日志分析
比如分析网站访问日志,统计每个页面的浏览量,Mapper输出<页面URL, 1>,Reducer求和,本地模式可以快速测试,即使数据量达到几GB,只要机器内存足够,也能跑完,你可以调整mapreduce.task.io.sort.mb等参数来优化性能。
排序与TopN
MapReduce默认对键进行排序,所以可以利用这个特性实现全局排序,如果需要取TopN,可以在Map阶段先过滤出候选数据,Reducer中维护一个固定大小的堆,输出前N个结果,本地模式非常适合验证排序规则的准确性,你可以通过job.setSortComparatorClass自定义比较逻辑。
Java单独使用MapReduce与集群模式的对比
| 对比维度 | 本地模式 | 集群模式 |
|---|---|---|
| 运行环境 | 单JVM,无需守护进程 | 需要HDFS和YARN/MapReduce集群 |
| 数据规模 | 适合GB级以下 | 适合TB级以上 |
| 调试便利性 | 高,可直接IDE调试 | 低,需要查看日志和界面 |
| 学习成本 | 低,十分钟上手 | 高,需要配置集群 |
| 运行速度 | 相对较快(小数据量) | 依赖资源分配 |
| 硬件成本 | 无额外成本 | 需要多台服务器 |
通过这个表格可以清楚看出,Java单独使用MapReduce(本地模式)更适合学习、原型验证和轻量级任务,而生产环境下的海量数据,则必须依赖集群模式。
关于Java单独使用MapReduce的常见问题
Q1: Java单独使用MapReduce需要安装Hadoop完整版吗?
是的,即使只使用本地模式,也需要Hadoop的客户端库和相关配置文件,你可以通过Maven引入依赖,但完整版Hadoop安装包更方便,因为它包含了所有默认配置和运行脚本,而且目录结构清晰,方便你随时修改配置。
Q2: 单独使用MapReduce能处理多大数据量?
这取决于你的机器内存和磁盘,本地模式下,MapReduce将数据存储在本地文件系统,处理能力受限于单机,一般建议数据量不要超过几十GB,如果数据更大,应考虑使用集群模式或分布式计算框架,你可以通过调整mapreduce.map.memory.mb等参数适当扩展,但效果有限。
Q3: 单独使用MapReduce与使用Spark有什么主要区别?
MapReduce模型是典型的磁盘迭代计算,每一步都会将中间结果写入磁盘,而Spark基于内存计算,性能更优,但MapReduce适合批处理,稳定性高,且对资源要求较低,在本地模式下,MapReduce的启动速度更快,适合快速验证,Java MapReduce对比Spark,两者各有优劣,选择哪种取决于你的具体场景和团队技术栈。
掌握Java单独使用MapReduce,是深入理解分布式计算原理的基石,本地模式让你用最小成本跑通逻辑,为后续处理海量数据做好准备。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/548868.html