什么是非完全重复数据库,如何进行高效的数据去重?

理解“非完全重复数据库”的核心概念

在数据管理与架构设计中,“非完全重复数据库”通常指的是在数据规范化(Normalization)与查询性能(Performance)之间寻求平衡的一种设计状态,它既不是完全消除冗余的理想化状态,也不是完全无序的冗余状态,而是一种受控的、有目的的数据存储模式。

核心设计逻辑

为了实现这种平衡,开发者通常需要处理以下两个极端:
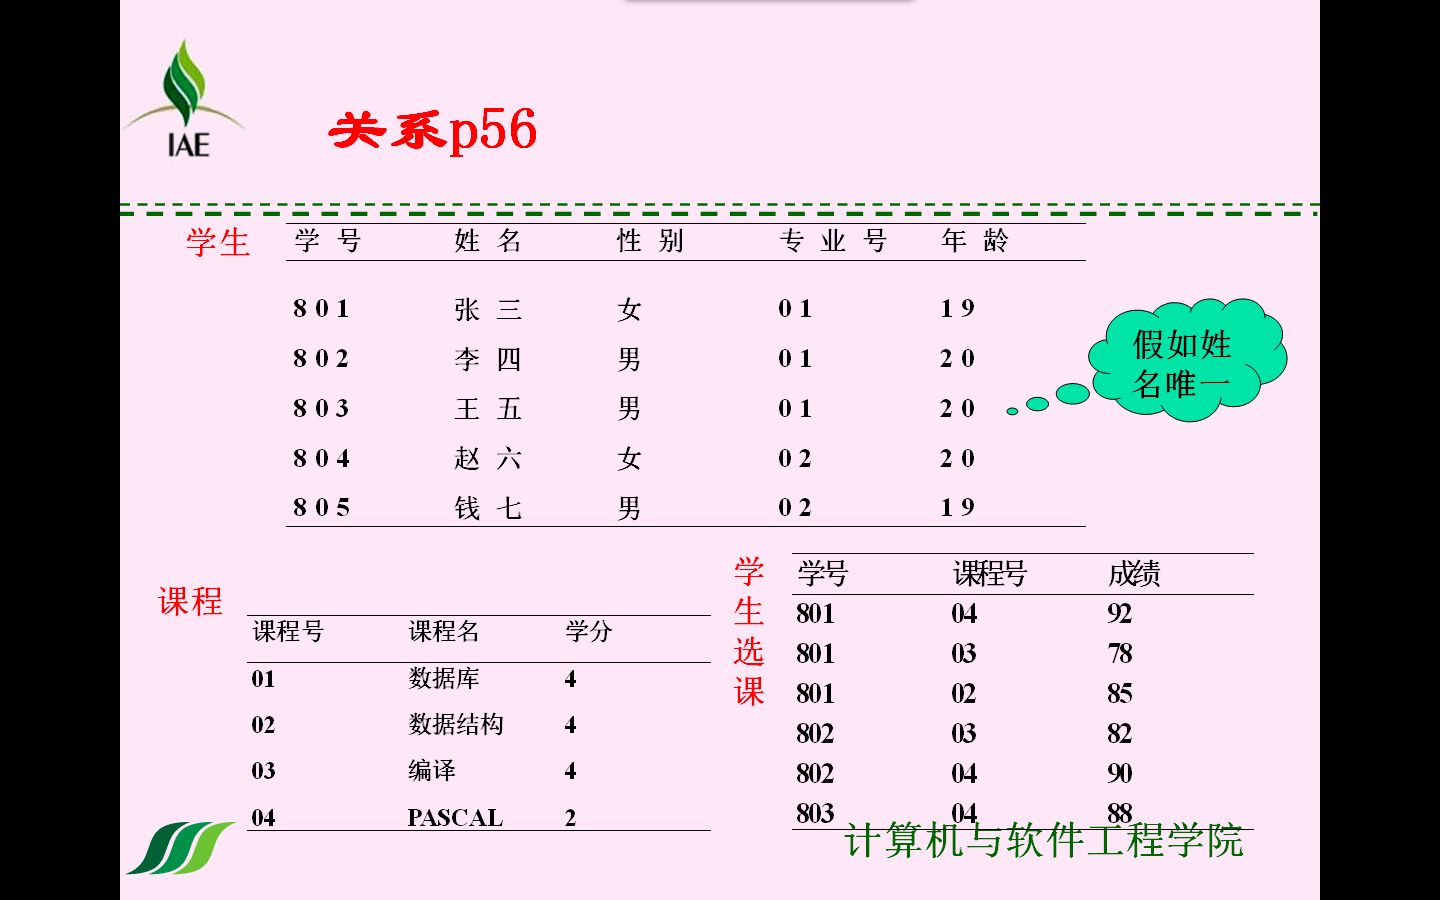
快速掌握数据库主码候选码主属性
加载中
快速掌握数据库主码候选码主属性
  • 完全规范化(Zero Redundancy):通过严格的范式(如 3NF 或 BCNF)消除所有数据冗余,虽然这保证了数据一致性,但在进行复杂查询时需要大量的 Join(连接) 操作,会导致严重的性能问题。
  • 完全冗余(High Redundancy)

    什么是非完全重复数据库,如何进行高效的数据去重?

    :为了极速查询,将所有相关数据存储在单张表中,虽然查询极快,但会导致数据更新异常、存储空间浪费以及维护成本极高。

非完全重复数据库的目标是在保证核心业务逻辑一致性的前提下,允许在特定维度上存在受控的冗余。

实现策略与技术手段

要构建这种高效的数据库结构,通常采用以下几种策略:

  • 适度反规范化(Controlled Denormalization):

    • 在高频查询的字段上保留冗余信息,在“订单表”中直接存储“用户姓名”,而不是每次都去“用户表”中关联查询。
    • 优点:大幅提升读取速度。
    • 风险:需要通过程序逻辑或触发器确保用户更名时,订单表中的姓名同步更新。
    • 什么是非完全重复数据库,如何进行高效的数据去重?

  • 增量数据管理(Incremental Data Management):

    • 不存储全量的历史快照,而是通过增量更新的方式记录数据的变化。
    • 使用 SCD(缓慢变化维) 技术来处理维度数据的变化,从而在不完全重复全量数据的情况下,保留历史追溯能力。
  • 数据清洗与去重(Data Deduplication):

    • 在数据进入数据库前,通过 ETL(抽取、转换、加载) 流程进行清洗。
    • 利用唯一约束(Unique Constraints)和主键(Primary Key)机制,从物理层面防止逻辑上的完全重复。

应用场景

这种设计模式广泛应用于以下领域:

  • 数据仓库(Data Warehouse)

    什么是非完全重复数据库,如何进行高效的数据去重?

    :在维度建模(星型模型或雪花模型)中,通过事实表和维度表的结合,实现查询效率与存储空间的平衡。

  • 分布式系统:在微服务架构中,为了实现服务自治,各服务可能会维护一份其他服务的局部冗余数据,以减少跨服务调用。
  • 大数据处理:在处理海量流式数据时,通常采用宽表设计,通过适度的冗余来换取大规模并行处理(MPP)的效率。

构建“非完全重复数据库”的关键不在于“消除冗余”,而在于“管理冗余”,优秀的架构师会根据读写比(Read/Write Ratio)、查询复杂度以及数据一致性要求,决定在哪些地方保留冗余,在哪些地方严格规范。

首发原创文章,作者:王坚‌,如若转载,请注明出处:https://test.idctop.com/article/491465.html

赞 (0)
服务器出现RST连接重置怎么办,TCP连接重置的原因有哪些?
上一篇 2026年7月13日 14:43
什么是分层混合式存储系统,混合存储和全闪存存储哪个好?
下一篇 2026年7月13日 14:50

相关推荐

  • 服务器主机做台式机值得买吗,性能怎么样?

    服务器主机完全可以当作台式机使用,并且在多核性能和扩展性上有明显优势,但需要接受更大的噪音和功耗,如果你对性价比敏感且动手能力强,它可能是捡垃圾的宝藏;但追求静音或单核性能,建议直接绕道,服务器主机当台式机用,到底划不划算?二手服务器主机价格极低,几百元就能买到双路Xeon加32GB内存的组合,这是同价位普通台……

    2026年7月25日
    900
  • IIS手机网站如何设置?,具体步骤是什么?

    要在IIS中成功设置手机网站,关键在于区分移动端与PC端的访问需求,通过URL重写模块实现智能跳转,并确保移动版网站的速度与适配性,为什么IIS手机网站设置影响SEO移动优先索引是当前搜索引擎的默认策略,百度等主流引擎会优先抓取并评估移动版内容,如果IIS上的手机网站配置不当,比如重定向错误或加载缓慢,直接导致……

    2026年8月12日
    1300
  • AI大模型和小模型区别是什么?大模型和小模型哪个更适合中小企业

    AI大模型与小模型的核心区别在于:大模型拥有通用泛化能力,适合复杂推理与创意生成;小模型则具备低延迟、低成本和私有化部署优势,适合垂直场景的高频实时处理,在2026年的技术语境下,人工智能不再是一个单一的黑盒,而是形成了从云端大脑到终端神经末梢的完整生态,理解这两者的差异,是选择技术栈、优化业务成本的关键,过去……

    2026年6月15日
    3300
  • 大模型全参数微调FT完整教程

    大模型全参数微调(Full Fine-Tuning)并非简单的代码运行,而是通过消耗大量算力资源,让模型彻底重写内部权重以适应特定垂直领域任务的最彻底方案,适合拥有充足GPU资源且对领域专业性要求极高的场景,在人工智能落地应用的深水区,许多开发者容易陷入一个误区:认为微调就是给模型“喂”几本行业手册,全参数微调……

    2026年6月17日
    2600
  • veth1接口用dhcp怎么配置inet6?,获取失败咋办?

    在Linux系统中,使用iface veth1 inet6 dhcp配置可以快速让veth虚拟网卡通过DHCPv6协议动态获取IPv6地址,实现自动化网络配置,iface veth1 inet6 dhcp 配置代表什么这一行代码出现在/etc/network/interfaces文件中,是Debian系Linu……

    2026年8月11日
    500
  • idc单位查询_查询单位类型

    查询IDC单位类型,最直接的方法是登录工信部官网确认企业是否持有IDC牌照,同时结合其服务模式判定是自建机房、租用资源还是纯粹代理,很多人在选IDC服务商时,都会被“自建”“中立”“运营商”这些词绕晕,其实分类不难,关键在于知道怎么查、查什么,下面直接拆解流程,帮你快速摸清任何一家IDC单位的底细,IDC单位类……

    2026年8月6日
    500
  • IP地址如何访问云服务器网站?,需要防护的IP地址是什么?

    使用IP地址直接访问云服务器网站存在显著的安全风险,所有暴露在公网且承载核心业务的源站IP都需要纳入防护范围,这是最容易被忽略但必须优先做的事情,云服务器网站用IP地址访问安全吗?隐藏的攻击面很多站长在搭建云服务器网站后,习惯直接用IP地址进行访问测试,甚至长期将IP暴露在公网,这种做法相当于把家门钥匙挂在门外……

    2026年8月20日
    400
  • 如何在IDEA中配置Tomcat服务器?,Tomcat常用配置有哪些?

    在IntelliJ IDEA中配置Tomcat服务器并掌握其常用配置参数,是Java Web开发入门的关键一环,本文将从零开始,详细演示IDEA配置Tomcat服务器的完整步骤,并深入解析Tomcat常用配置,帮助你快速搭建稳定高效的开发环境,IDEA配置Tomcat服务器的标准流程下载与安装Tomcat运行环……

    2026年8月1日
    700
  • 如何通过OBS接入华为SDK?,具体步骤是什么?

    华为SDK通过OBS接入,本质就是把推送业务涉及的回执数据、资源文件托管在华为云OBS桶中,再在SDK配置里完成桶的鉴权与读写参数对接,整个过程大约需要半小时, 这个说法不是官方定义,但把它理解成“让推送消息学会找文件、存文件”也没问题,今天这篇内容,就是把华为SDK接入文档里和OBS相关的部分,掰开揉碎讲清楚……

    2026年8月21日
    300
  • AI大模型有哪些优势?AI大模型对企业有哪些帮助

    AI大模型的核心优势在于通过自然语言交互实现效率倍增、通过多模态融合打破信息壁垒,并借助持续学习能力提供个性化服务,这使其成为企业数字化转型与个人生产力升级的关键基础设施,AI大模型如何重塑生产力与工作效率过去,处理海量文本或代码需要耗费大量人力进行重复性劳动,大模型能够瞬间理解上下文逻辑,将原本需要数小时的工……

    2026年6月14日
    2810

发表回复

您的邮箱地址不会被公开。 必填项已用 * 标注