“分组查询”通常指的是在数据库(如 SQL)或数据分析工具中,根据某些字段将数据划分为多个组,并对每个组进行聚合统计(如求和、计数、平均值等)的操作。
以下是关于 分组查询(GROUP BY) 的全面解析,包括 SQL 语法、核心概念、常见用法及注意事项。
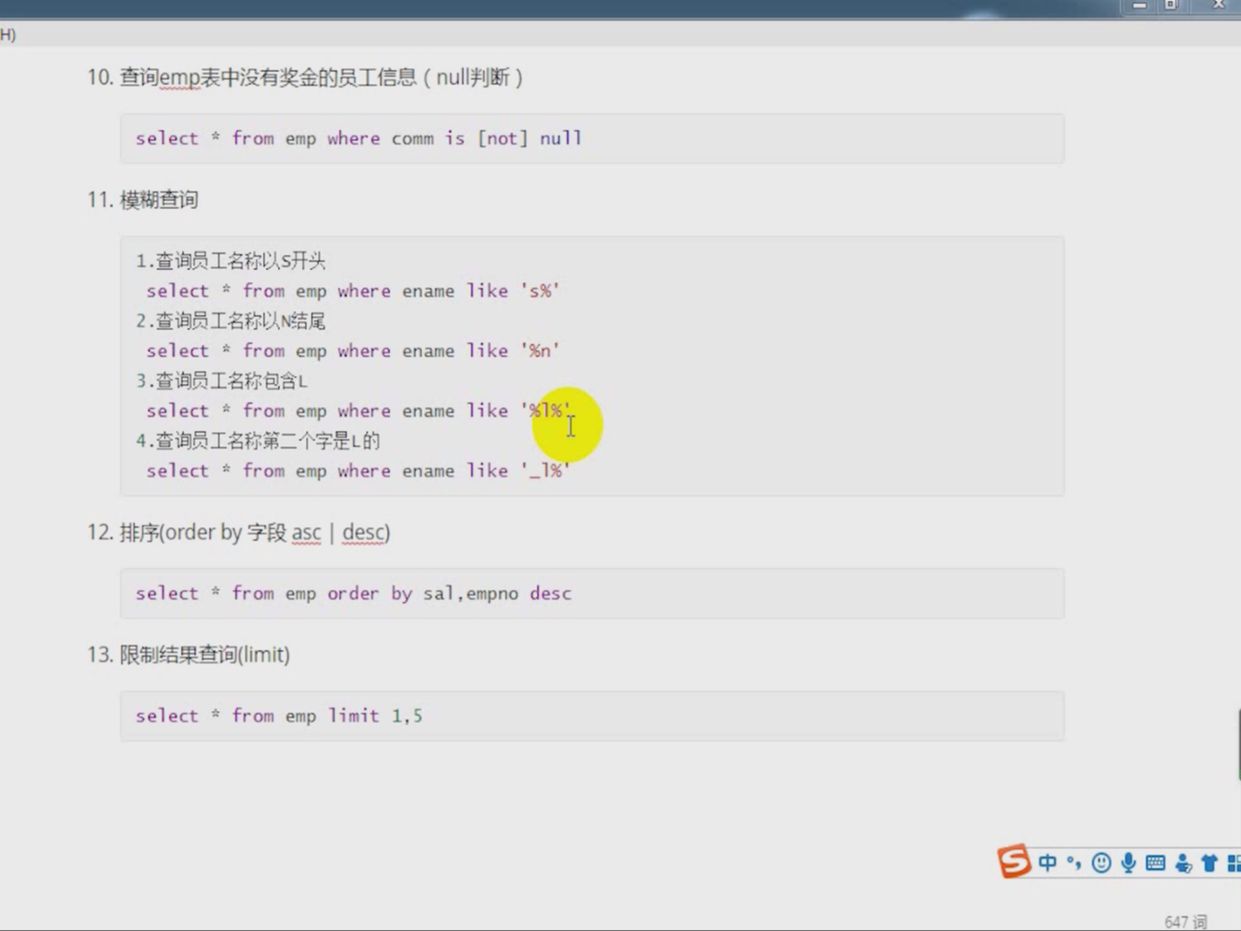
核心语法(以 SQL 为例)
SELECT
    column1,          -- 分组依据的列
    AGG_FUNC(column2) -- 聚合函数(如 COUNT, SUM, AVG, MAX, MIN)
FROM
    table_name
WHERE
    condition         -- 可选:在分组前过滤行
GROUP BY
    column1           -- 指定按哪些列分组
HAVING
    condition         -- 可选:在分组后过滤组
ORDER BY
    column1;          -- 可选:对结果排序
关键概念区分
| 关键字 | 作用时机 | 说明 |
|---|---|---|
| WHERE | 分组前 | 过滤原始数据行,不能使用聚合函数。 |
| GROUP BY | 分组时 | 将数据按指定列分组。 |
| HAVING | 分组后 | 过滤分组后的结果。可以使用聚合函数。 |
| ORDER BY | 最后 | 对最终查询结果进行排序。 |
✅ 记忆口诀:
WHERE过滤行,GROUP BY分组,HAVING过滤组。
常见场景与示例
假设有一张 sales 表:
| id | product | category | amount | date |
|---|---|---|---|---|
| 1 | Apple | Fruit | 10 | 2026-01-01 |
| 2 | Banana | Fruit | 20 | 2026-01-02 |
| 3 | Carrot | Veg | 15 | 2026-01-03 |
| 4 | Apple | Fruit | 30 | 2026-01-04 |
| 5 | Carrot | Veg | 5 | 2026-01-05 |
场景 1:按类别统计总销售额
SELECT
    category,
    SUM(amount) AS total_sales
FROM
    sales
GROUP BY
    category;
结果:
| category | total_sales |
|———-|————-|
| Fruit | 60 |
| Veg | 20 |
场景 2:按类别和产品统计,并筛选总销售额 > 25 的组
SELECT
    category,
    product,
    SUM(amount) AS total_sales
FROM
    sales
GROUP BY
    category, product
HAVING
    SUM(amount) > 25;
结果:
| category | product | total_sales |
|———-|———|————-|
| Fruit | Apple | 40 |
场景 3:先过滤再分组(WHERE + GROUP BY)
只统计 2026-01-02 之后的销售,再按类别汇总:
SELECT
    category,
    SUM(amount) AS total_sales
FROM
    sales
WHERE
    date >= '2026-01-03'
GROUP BY
    category;
结果:
| category | total_sales |
|———-|————-|
| Fruit | 30 |
| Veg | 20 |
常用聚合函数
| 函数 | 说明 | 示例 |
|---|---|---|
COUNT() |
计数 | COUNT() 或 COUNT(column) |
SUM() |
求和 | SUM(amount) |
AVG() |
平均值 | AVG(price) |
MAX() |
最大值 | MAX(salary) |
MIN() |
最小值 | MIN(score) |
常见错误与注意事项
-
SELECT 中的列必须出现在 GROUP BY 中
在标准 SQL 中,SELECT列表中的非聚合列必须包含在GROUP BY子句中。
❌ 错误:SELECT name, SUM(amount) FROM sales GROUP BY category;(name未分组)
✅ 正确:SELECT category, SUM(amount) FROM sales GROUP BY category;
-
NULL 值处理
GROUP BY会将NULL值视为一个独立的组。COUNT(column)会忽略NULL,但COUNT()会计算所有行(包括 NULL)。
-
性能优化
- 在
GROUP BY的列上建立索引可以显著提升查询性能。 - 避免在
GROUP BY中使用复杂表达式或函数,否则可能导致全表扫描。
- 在
-
HAVING vs WHERE
- 如果过滤条件不涉及聚合函数,优先使用
WHERE,因为它在分组前执行,效率更高。 - 只有当过滤条件涉及聚合结果(如
SUM > 100)时,才使用HAVING。
- 如果过滤条件不涉及聚合函数,优先使用
其他工具中的分组查询
-
Python (Pandas):
df.groupby('category')['amount'].sum() -
Excel:
使用“数据透视表”(Pivot Table)实现分组汇总。
-
Power BI / Tableau:
通过拖拽字段到“行”或“列”区域,并设置聚合方式(求和、计数等)实现分组。
如果你有具体的数据库类型(如 MySQL、PostgreSQL、Oracle)或具体的业务场景,可以提供更多细节,我可以给出更精准的查询语句。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/483767.html