服务器硬件准备
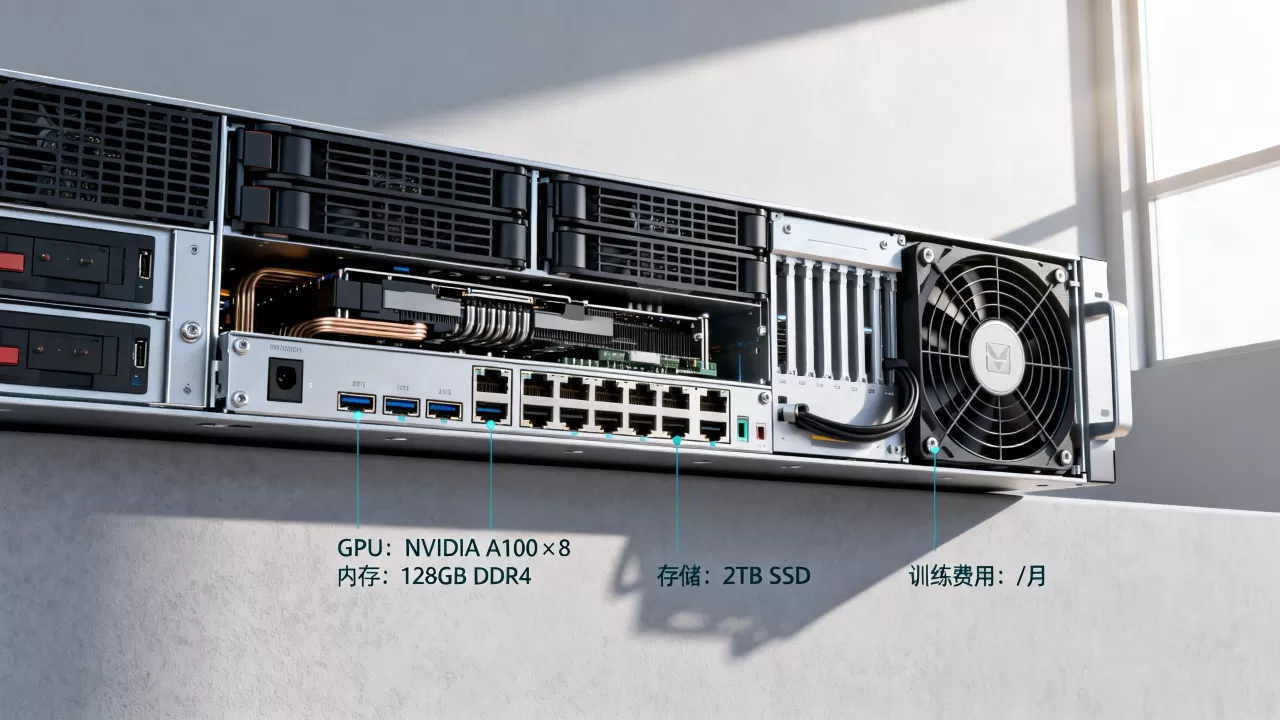
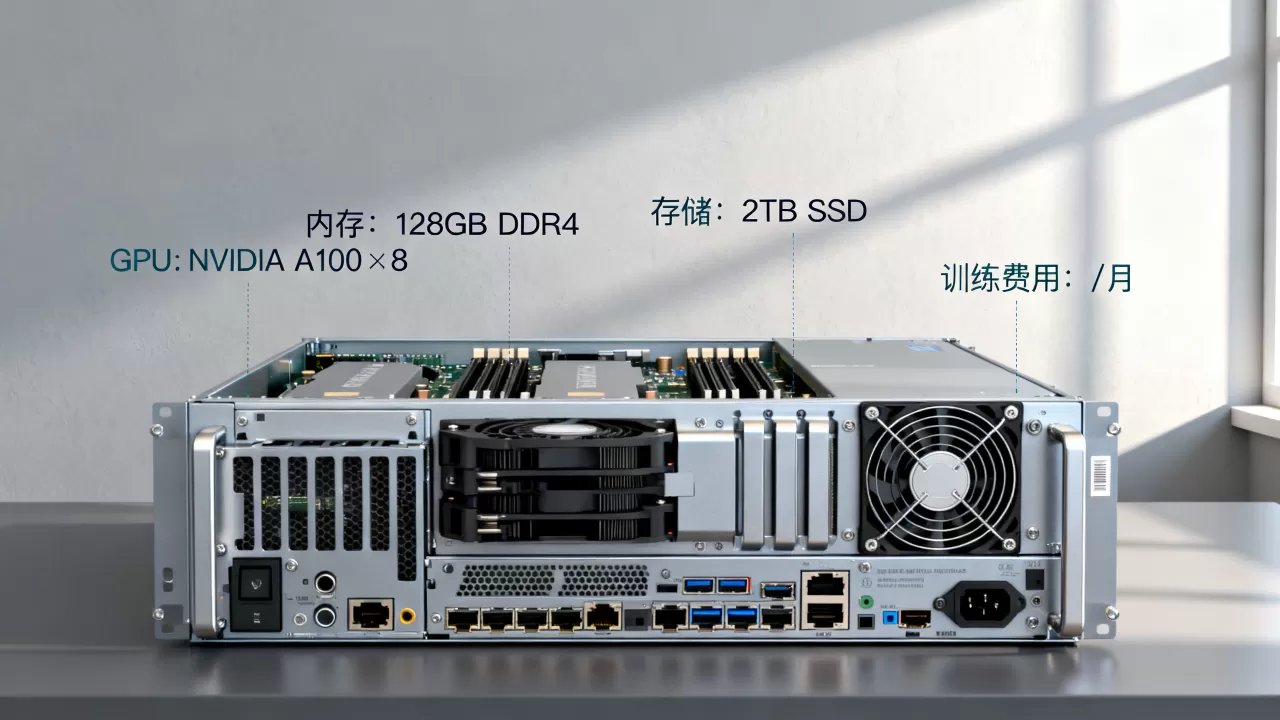
GPU(核心组件)
- 推荐型号:NVIDIA A100、H100、A6000、RTX 4090(消费级高性能)、V100(旧款但稳定)。
- 显存要求:
- 小模型(如 BERT-base、ResNet50):≥8GB 显存。
- 大模型(如 LLaMA-7B、Stable Diffusion XL):≥24GB–80GB 显存。
- 多卡并行:支持 NVLink 或 PCIe 多卡互联,提升通信效率。
CPU
- 建议多核高主频 CPU(如 Intel Xeon、AMD EPYC),用于数据预处理和加载。
内存(RAM)
- 至少是 GPU 显存的 2–4 倍,80GB 显存建议搭配 256GB+ 系统内存。
存储
- 高速 SSD/NVMe:用于数据集和模型检查点存储,IOPS 要高。
- 大容量存储:用于备份和长期归档。
网络
- 若使用分布式训练,建议 10Gbps 或更高带宽网卡。
软件环境搭建
操作系统
- 推荐 Ubuntu 20.04/22.04 LTS 或 CentOS 7/8。
驱动与 CUDA
# 安装 NVIDIA 驱动
sudo apt install nvidia-driver-535
# 安装 CUDA Toolkit(版本需与 PyTorch/TensorFlow 兼容)
sudo apt install cuda-toolkit-11-8
# 验证
nvidia-smi
nvcc --version
深度学习框架
使用 Conda + Pip(推荐)
# 创建虚拟环境
conda create -n dl_env python=3.10
conda activate dl_env
# 安装 PyTorch(示例 CUDA 11.8)
pip install torch torchvision torchaudio --index-url https://download.pytorch.org/whl/cu118
使用 Docker(隔离性好)
# 拉取官方镜像
docker pull pytorch/pytorch:2.1.0-cuda11.8-cudnn8-runtime
# 运行容器
docker run --gpus all -it --name dl_container pytorch/pytorch:2.1.0-cuda11.8-cudnn8-runtime bash
常用库
pip install numpy pandas scikit-learn matplotlib seaborn
pip install transformers datasets accelerate  # 用于大模型训练
pip install tensorboard wandb  # 用于监控
代码优化技巧
数据加载优化
from torch.utils.data import DataLoader
# 使用多进程加载数据
train_loader = DataLoader(
    dataset,
    batch_size=32,
    shuffle=True,
    num_workers=8,  # 根据 CPU 核心数调整
    pin_memory=True  # 加速 CPU 到 GPU 数据传输
)
混合精度训练(AMP)
from torch.cuda.amp import autocast, GradScaler
scaler = GradScaler()
for epoch in range(epochs):
    for inputs, labels in train_loader:
        inputs, labels = inputs.cuda(), labels.cuda()
        with autocast():
            outputs = model(inputs)
            loss = criterion(outputs, labels)
        scaler.scale(loss).backward()
        scaler.step(optimizer)
        scaler.update()
        optimizer.zero_grad()
分布式训练(DDP)
import torch.distributed as dist
from torch.nn.parallel import DistributedDataParallel as DDP
dist.init_process_group(backend='nccl')
model = DDP(model, device_ids=[local_rank])
梯度累积(模拟大 Batch Size)
accumulation_steps = 4
for i, (inputs, labels) in enumerate(train_loader):
    outputs = model(inputs)
    loss = criterion(outputs, labels) / accumulation_steps
    loss.backward()
    if (i + 1) % accumulation_steps == 0:
        optimizer.step()
        optimizer.zero_grad()
监控与日志
TensorBoard
from torch.utils.tensorboard import SummaryWriter
writer = SummaryWriter(log_dir='./runs')
writer.add_scalar('Loss/train', loss.item(), global_step=step)
writer.close()
Weights & Biases(W&B)
import wandb
wandb.init(project="my_project")
wandb.log({"loss": loss.item(), "acc": acc})
系统监控
# 监控 GPU 使用率
nvidia-smi -l 1
# 监控 CPU/内存/磁盘
htop
df -h
常见问题与解决方案
| 问题 | 可能原因 | 解决方案 |
|---|---|---|
| CUDA Out of Memory | Batch size 过大、模型太大 | 减小 batch size、使用梯度累积、启用混合精度、使用 ZeRO 优化 |
| 训练速度慢 | 数据加载瓶颈 | 增加 num_workers、使用 pin_memory、预处理数据 |
| GPU 利用率低 | 计算瓶颈不在 GPU | 检查数据预处理是否耗时、优化模型结构 |
| 分布式训练通信慢 | 网络带宽不足 | 使用 NVLink、优化 NCCL 设置 |
最佳实践总结
- 从小规模开始:先用小数据集和小型模型验证代码正确性。
- 模块化代码:将数据加载、模型定义、训练循环分离。
- 定期保存检查点:防止意外中断导致前功尽弃。
- 使用超参数搜索:如 Optuna、Ray Tune 自动调参。
- 文档化实验:记录每次实验的配置、结果和结论。
如果你有具体的任务(如 NLP、CV、推荐系统等)或模型类型(如 Transformer、CNN、GNN),我可以提供更针对性的优化建议。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/481173.html