Hadoop大数据压缩比的核心结论是:在大多数生产环境中,合理选择Snappy或LZO算法可将数据体积缩减至原大小的30%-40%,而追求极致存储效率时,Zstandard或Gzip虽能压缩至10%-20%,但会显著增加CPU负载,实际选型需根据计算密集度与存储成本进行权衡。
在Hadoop生态系统中,数据压缩不仅仅是为了节省磁盘空间,更是为了降低网络I/O传输开销,从而提升整体集群的处理效率,业内专家指出,数据压缩技术已成为优化Hadoop集群性能的关键手段之一,很多初学者往往陷入一个误区,认为压缩比越高越好,却忽略了CPU解码带来的性能损耗,压缩算法的选择是一个典型的“空间换时间”或“时间换空间”的博弈过程。

Hadoop主流压缩算法深度解析
在Hadoop中,常用的压缩格式主要分为三类:通用压缩格式、可分割压缩格式以及专用压缩格式,理解它们的特性是选择合适方案的前提。
通用压缩格式:Gzip与Bzip2
Gzip是应用最广泛的通用压缩算法,其优势在于极高的压缩比,在离线数据仓库的场景中,对于历史归档数据,Gzip能将数据压缩到原始大小的10%左右,Gzip不支持Split(切片),这意味着在MapReduce任务中,一个大的Gzip文件只能由一个Map任务处理,无法并行化,这会严重拖慢作业执行速度。
Bzip2则提供了更好的可分割性,其压缩比略低于Gzip,但支持Split,适合需要并行处理的大文件,Bzip2的压缩和解压速度都非常慢,CPU开销巨大,因此在实时性要求较高的场景中并不推荐。
高性能压缩格式:Snappy与LZO
Snappy是Google开发的一种快速压缩算法,其设计目标是极致的速度而非极致的压缩比,在Hadoop环境中,Snappy通常能将数据压缩至原大小的30%-40%,但其解压速度极快,几乎不占用额外的CPU资源,对于MapReduce或Spark等计算密集型任务,Snappy是首选,因为它能显著减少网络传输时间,同时保持计算节点的高效运行。
LZO(Lempel-Ziv-Oberhumer)是另一种流行的选择,它支持Split,且压缩和解压速度都很快,虽然LZO的压缩比略低于Snappy,但在某些特定场景下,其可分割性带来的并行处理优势更为明显,需要注意的是,LZO需要安装额外的原生库,部署复杂度略高于Snappy。
压缩算法性能对比表
| 算法名称 | 压缩比 | 压缩速度 | 解压速度 | 是否支持Split | 适用场景 |
|---|---|---|---|---|---|
| Gzip | 高 | 慢 | 慢 | 否 | 归档数据、离线分析 |
| Bzip2 | 极高 | 极慢 | 极慢 | 是 | 需要高压缩比且可分割的场景 |
| Snappy | 中 | 极快 | 极快 | 否 | 计算密集型、实时处理 |
| LZO | 中 | 快 | 快 | 是 | 需要并行处理且低延迟场景 |
| Zstandard | 高 | 快 | 快 | 是 | 现代大数据栈、平衡型需求 |
如何根据业务场景选择最佳压缩策略
选择压缩算法时,不能一概而论,必须结合具体的业务场景、数据特征以及集群资源状况进行综合考量。
离线数据仓库场景
在数据仓库的ETL过程中,数据通常需要经过多次清洗、转换和聚合,如果数据是最终归档存储,且查询频率较低,建议采用Gzip或Zstandard格式,Zstandard(zstd)是近年来兴起的一种新型压缩算法,它在压缩比和解压速度之间取得了良好的平衡,且支持Split,非常适合现代Hadoop集群,据统计,多数大型互联网企业正在逐步将Gzip迁移至Zstandard,以获得更好的性价比。
实时计算与流处理场景
对于Kafka、Flink等实时计算场景,网络I/O是瓶颈所在,应优先选择Snappy或LZO,Snappy的极低延迟特性可以确保数据在节点间快速传输,避免因压缩/解压导致的处理延迟,在Hive中,如果表数据量巨大且查询频繁,使用Snappy编码可以显著提升查询响应速度。
跨集群数据交换场景
当需要在不同Hadoop集群之间传输数据时,可分割性变得尤为重要,如果目标集群的MapReduce或Spark配置了自动切片机制,使用不支持Split的Gzip会导致严重的性能问题,LZO或Zstandard是更优的选择,因为它们既能保证较高的压缩比,又能支持并行处理。
Hadoop压缩配置实操指南
在实际操作中,正确配置压缩参数是发挥算法潜力的关键,以下以Hive和Hadoop核心配置为例,说明如何实施压缩策略。
Hive表压缩配置
在Hive中创建表时,可以通过STORED AS关键字指定压缩格式,创建一个使用Snappy压缩的ORC表:
CREATE TABLE user_behavior_snappy (
    user_id STRING,
    behavior_type STRING,
    timestamp BIGINT
)
STORED AS ORC
TBLPROPERTIES ('orc.compress'='SNAPPY');
对于TextFile格式,可以直接在插入数据时启用压缩:
SET hive.exec.compress.output=true;
SET mapreduce.output.fileoutputformat.compress=true;
SET mapreduce.output.fileoutputformat.compress.codec=org.apache.hadoop.io.compress.SnappyCodec;
Hadoop核心配置优化
在Hadoop集群层面,可以通过修改core-site.xml和mapred-site.xml来全局启用压缩,设置默认的输出压缩编解码器:
<property>
    <name>mapreduce.output.fileoutputformat.compress</name>
    <value>true</value>
</property>
<property>
    <name>mapreduce.output.fileoutputformat.compress.codec</name>
    <value>org.apache.hadoop.io.compress.SnappyCodec</value>
</property>
对于使用LZO的场景,还需要确保集群中安装了LZO原生库,并在mapred-site.xml中注册LZO编解码器:
<property>
    <name>io.compression.codecs</name>
    <value>org.apache.hadoop.io.compress.GzipCodec,org.apache.hadoop.io.compress.DefaultCodec,org.apache.hadoop.io.compress.SnappyCodec,com.hadoop.compression.lzo.LzoCodec,com.hadoop.compression.lzo.LzopCodec</value>
</property>
常见误区与性能调优建议
在实际应用中,许多用户在使用Hadoop压缩时容易陷入一些误区,导致性能反而下降。
盲目追求高压缩比
许多用户认为压缩比越高,存储成本越低,因此一味选择Gzip,如果数据需要频繁读取和计算,高压缩比带来的CPU解码开销可能远超存储节省的成本,行业共识认为,对于热数据,应优先考虑解压速度;对于冷数据,才优先考虑压缩比。
忽视Split特性
在处理大文件时,如果使用了不支持Split的压缩格式,MapReduce任务将无法并行化,导致作业执行时间成倍增加,在处理TB级数据时,务必确认压缩格式是否支持Split,或者在数据加载前进行适当的分片处理。
调优建议:混合使用压缩策略
一种高效的策略是混合使用不同的压缩格式,在数据入库阶段使用Snappy进行快速压缩,以加快数据写入速度;在数据归档阶段,将Snappy数据转换为Gzip或Zstandard,以节省长期存储成本,这种分层存储策略既能满足实时性要求,又能优化存储成本。
Hadoop大数据压缩比怎么计算
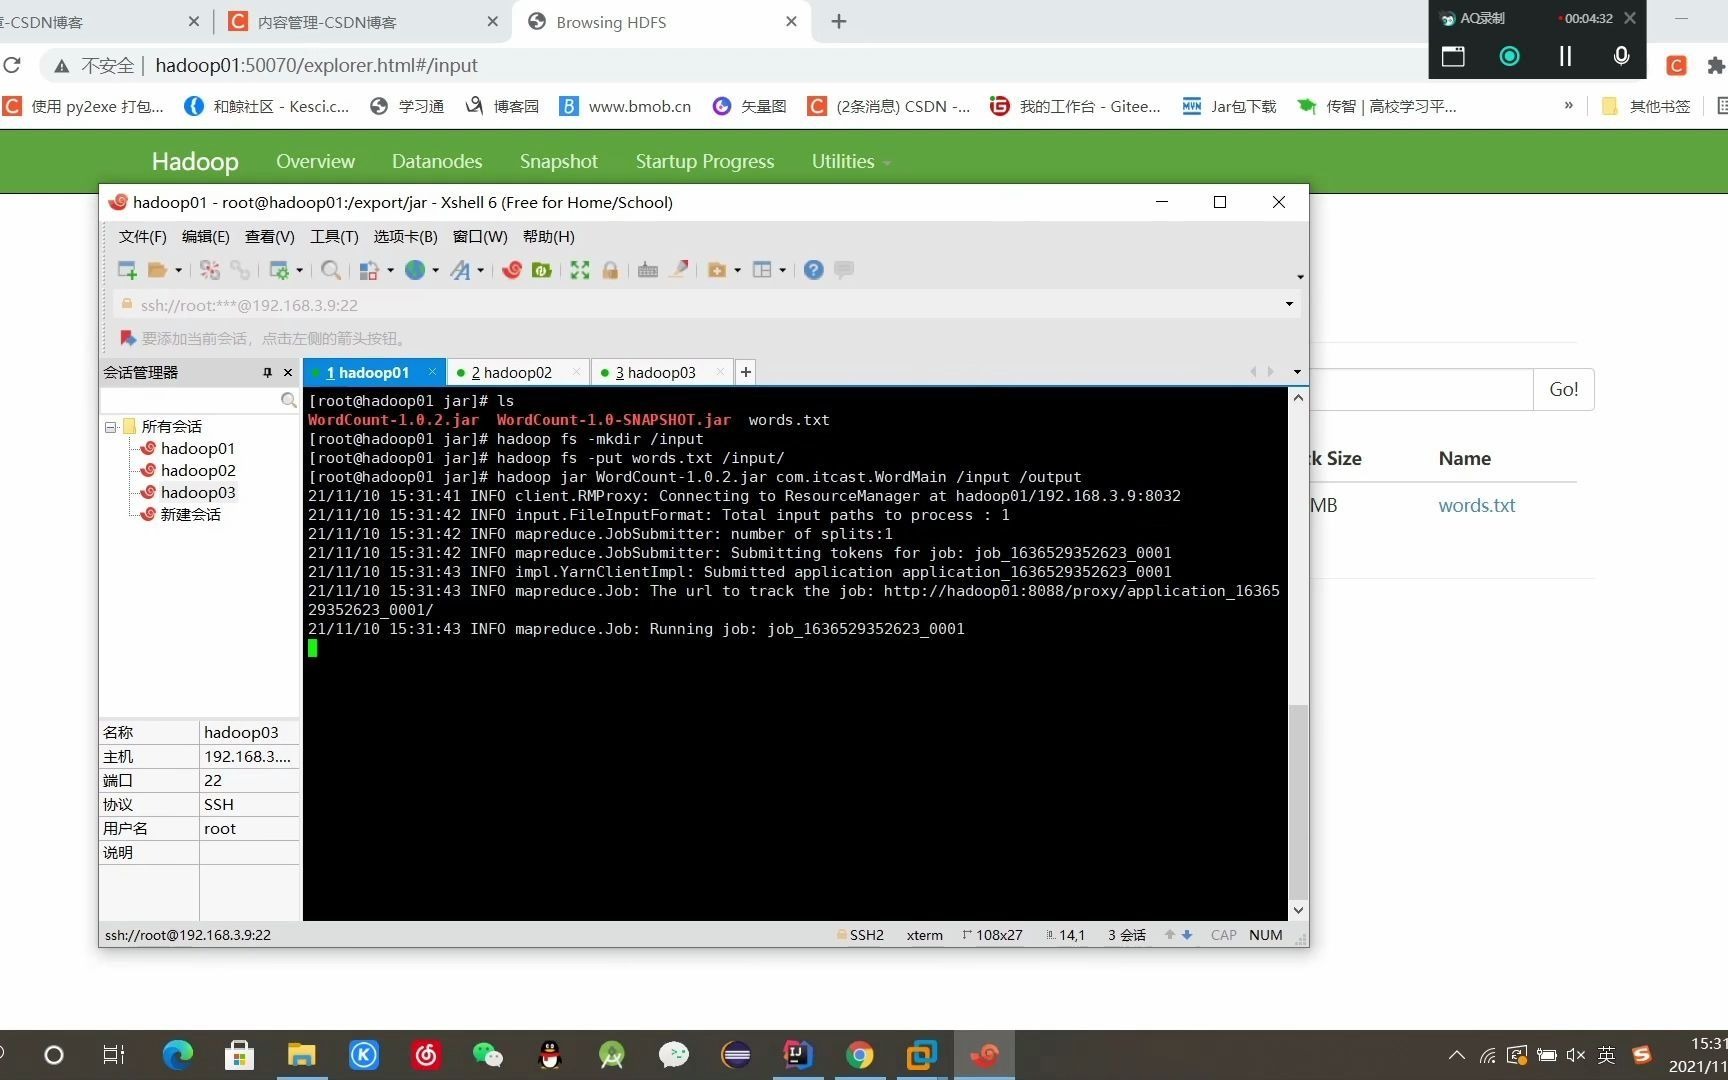
压缩比的计算公式为:压缩比 = 原始数据大小 / 压缩后数据大小,如果原始数据为100GB,压缩后为30GB,则压缩比为3.33,在实际操作中,可以通过Hadoop命令hdfs dfs -du -h /path/to/file查看文件大小,或使用hadoop checknative检查压缩库支持情况。
Hadoop压缩对查询速度影响
压缩对查询速度的影响取决于压缩算法和查询模式,对于Snappy等快速解压算法,由于减少了网络I/O,查询速度通常会有所提升,而对于Gzip等高压缩比算法,由于需要额外的CPU解码时间,查询速度可能会下降,尤其是在数据倾斜或计算资源紧张的情况下。
Hadoop压缩存储成本降低多少
存储成本的降低幅度取决于所选的压缩算法,使用Snappy可以节省约60%-70%的存储空间,而使用Gzip或Zstandard可以节省80%-90%的存储空间,在云存储环境下,存储成本的降低可以直接转化为显著的财务节省,尤其是在数据量达到PB级别时。
Hadoop大数据压缩比的优化并非单一维度的选择,而是需要在存储成本、计算性能、网络I/O和运维复杂度之间找到最佳平衡点,通过合理选择压缩算法、正确配置集群参数以及实施分层存储策略,可以显著提升Hadoop集群的整体效率和经济效益。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/476959.html