在服务器上进行深度学习时,核心在于根据模型规模合理分配GPU显存与计算资源,并优先选择预置深度学习环境的云实例以缩短部署周期。
深度学习不再是少数顶尖实验室的专属,越来越多的企业和个人开发者开始将目光投向本地服务器或云端算力集群,面对复杂的硬件配置和软件生态,许多初学者容易陷入“唯硬件论”或“盲目追求最新框架”的误区,构建一个高效、稳定的深度学习环境,关键在于理解硬件瓶颈、优化软件栈以及建立规范的运维流程,本文将结合2026年的行业现状,从硬件选型、环境搭建、性能优化到成本控制,为你提供一套可落地的实操指南。
硬件选型:GPU是核心,但内存和存储同样关键
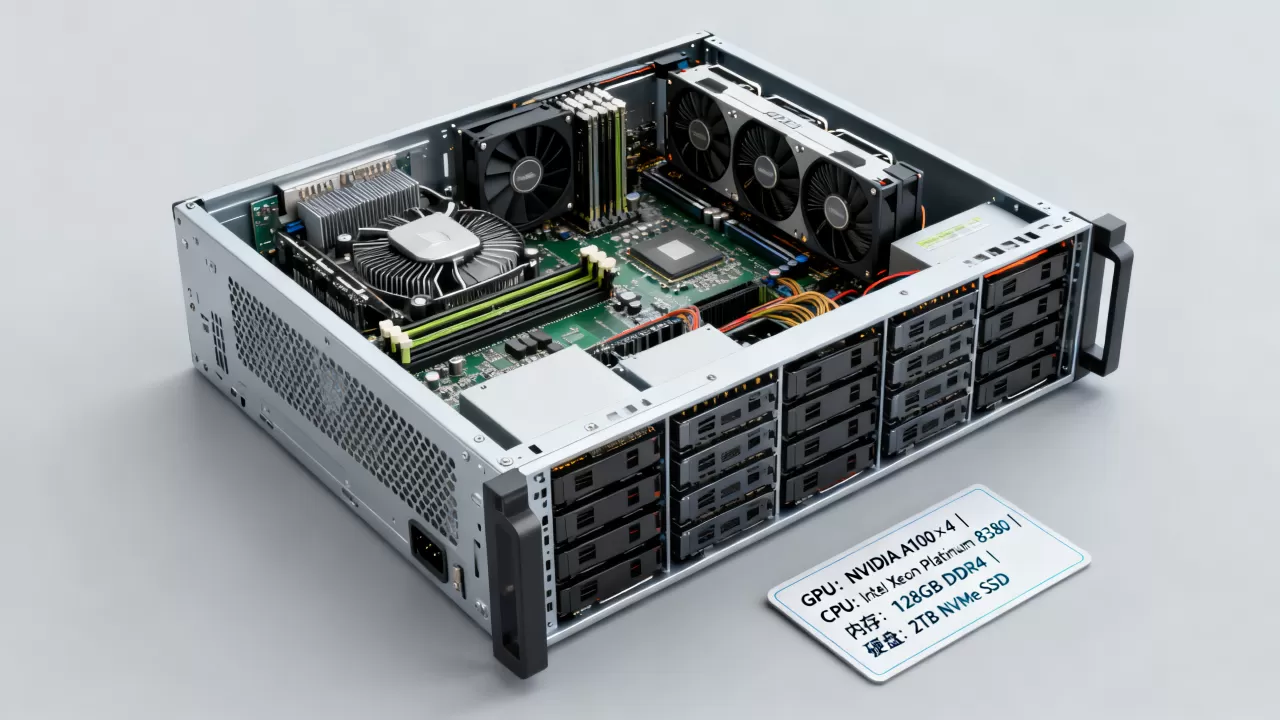
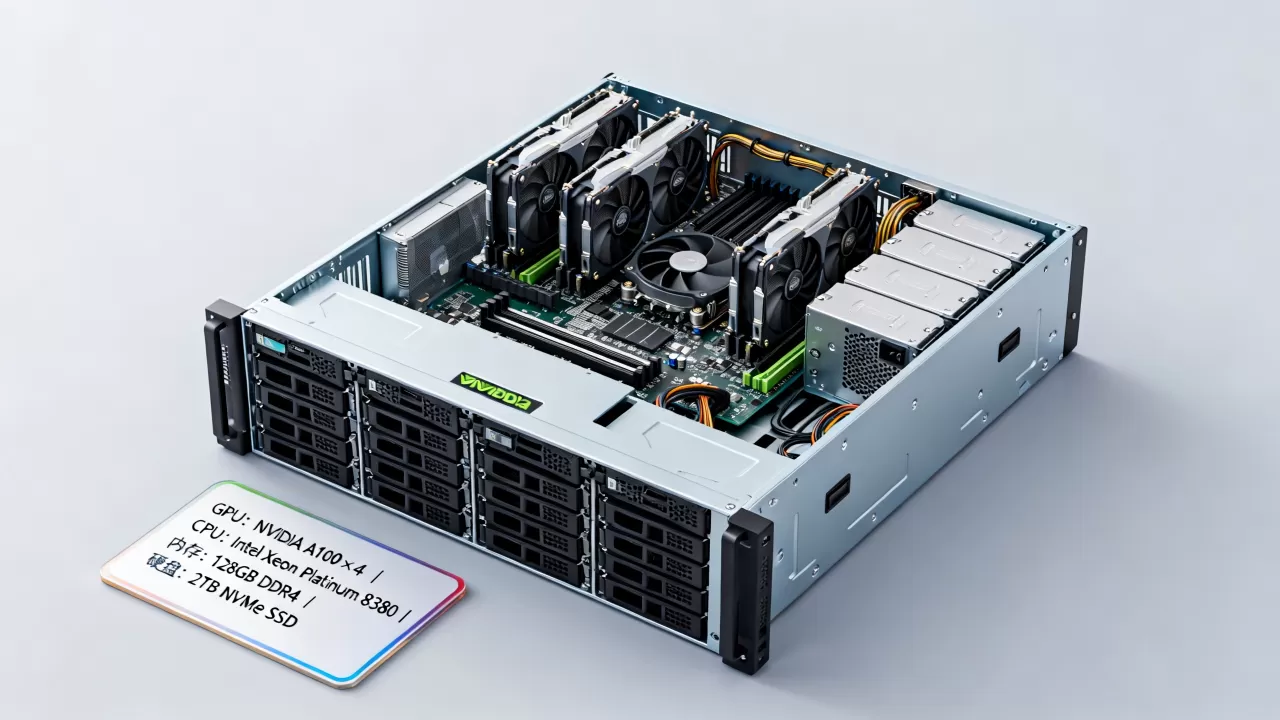
在深度学习任务中,GPU(图形处理器)无疑是计算引擎的心脏,仅仅购买一张高端显卡并不等于拥有了完美的深度学习服务器,业内专家指出,系统各组件之间的平衡决定了整体效率的上限。
如何选择适合的GPU配置
对于不同的应用场景,GPU的选择策略截然不同,如果是进行大语言模型(LLM)的微调或推理,显存容量比计算速度更为重要。
- 入门级训练:对于图像分类、目标检测等轻量级任务,单张RTX 4090或A1000级别显卡足以应对,这类配置适合个人开发者或小团队进行原型验证。
- 中型模型微调:涉及BERT、ResNet等中等规模模型,或者7B-13B参数量的LLM微调,建议配置双卡或多卡服务器,总显存需达到48GB以上。
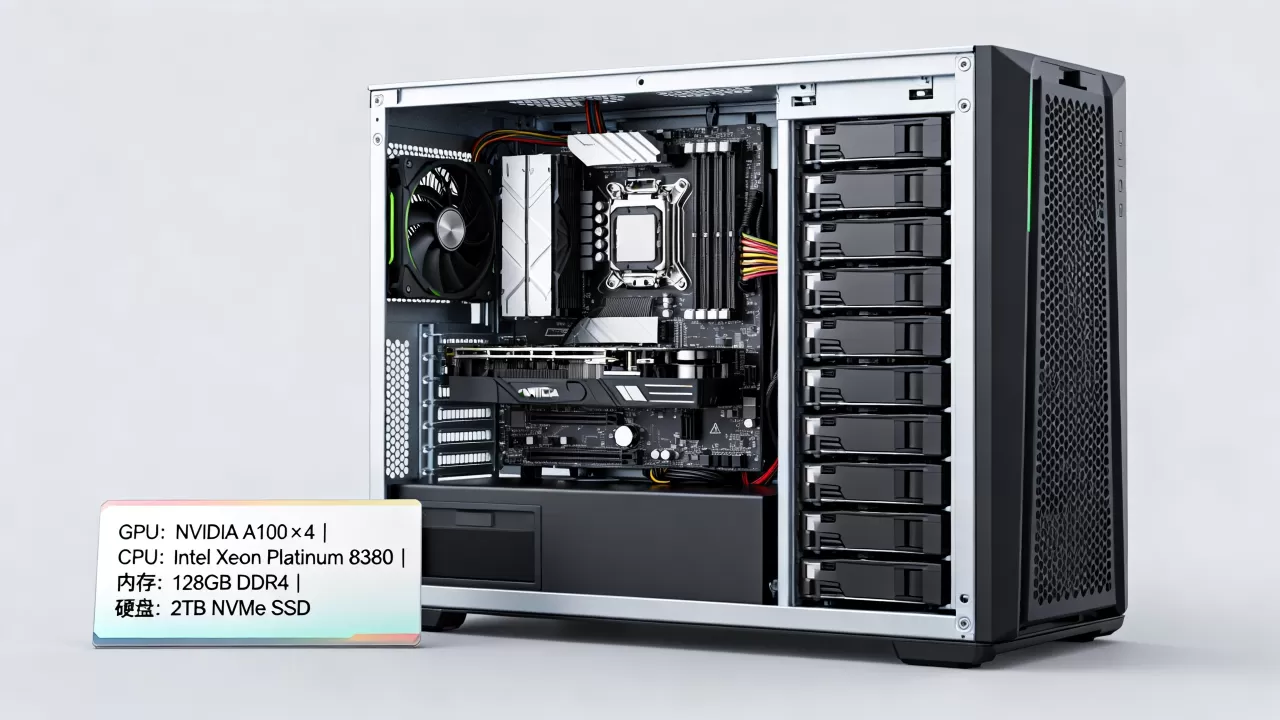
- 大规模预训练与推理:对于千亿参数级别的模型,需要依赖A100/H100等专业数据中心级GPU,且必须支持NVLink高速互联技术,以降低多卡通信延迟。
内存与存储的隐形瓶颈
很多开发者忽视CPU内存和I/O速度,导致GPU频繁等待数据,造成“算力闲置”。
- 系统内存:建议配置为GPU显存总和的2-4倍,若使用8张24GB显存的显卡,系统内存至少应配备128GB DDR5 ECC内存,以防止数据加载时的内存溢出。
- 存储速度:深度学习数据集往往包含大量小文件或超大视频文件,使用NVMe SSD作为数据盘是标配,随机读取速度需达到3000MB/s以上,若数据集超过2TB,建议采用RAID 0阵列或分布式文件系统(如Lustre或Ceph)以提升吞吐量。
软件环境搭建:从裸机到生产级环境
硬件就位后,软件环境的配置直接决定了开发效率和稳定性,2026年的主流趋势是容器化与自动化运维相结合。
操作系统与驱动安装
Linux依然是深度学习服务器的绝对主力,Ubuntu 22.04 LTS或CentOS Stream 9因其广泛的社区支持和长期稳定性成为首选。
- 安装NVIDIA驱动:避免使用包管理器安装,建议直接从NVIDIA官网下载.run文件进行安装,以确保驱动版本与CUDA版本严格匹配。
- 配置CUDA Toolkit:根据PyTorch或TensorFlow官方推荐的CUDA版本进行安装,不同框架对CUDA版本的兼容性要求不同,务必查阅官方文档。
- 安装cuDNN和NCCL:cuDNN用于加速深度学习原语,NCCL用于多GPU通信,这两者必须与CUDA版本对应,否则会导致性能大幅下降甚至崩溃。
使用Docker构建隔离环境
在服务器上进行深度学习时,依赖冲突是常见痛点,使用Docker可以完美解决环境问题。
- 拉取官方镜像:直接使用NVIDIA提供的
nvidia/cuda基础镜像,其中已预装CUDA、cuDNN和常用库。 - 创建自定义镜像:基于基础镜像,编写Dockerfile安装特定版本的Python、PyTorch及业务依赖库。
- 挂载数据卷:将宿主机的数据集目录挂载到容器内,避免数据复制,提升I/O效率。
常用Docker命令示例
启动一个包含GPU支持的容器:
docker run -it --gpus all -v /data:/workspace nvidia/cuda:12.2-runtime-ubuntu22.04 bash
此命令中,--gpus all允许容器访问所有GPU,-v将本地数据目录映射到容器内,确保数据持久化且高效读写。
性能优化与监控:让每一分算力都物尽其用
环境搭建完成后,如何最大化利用硬件资源是进阶关键,许多服务器在运行深度学习任务时,GPU利用率不足50%,这通常意味着存在I/O瓶颈或代码效率问题。
数据加载优化
数据预处理往往是训练速度的瓶颈。
- 使用DataLoader并行加载:在PyTorch中,将
num_workers设置为CPU核心数的2倍左右,可以显著加速数据读取。 - 内存映射与预取:对于大型数据集,使用HDF5或LMDB格式存储,配合预取机制,确保GPU在计算当前批次时,下一批次数据已准备就绪。
显存管理与混合精度训练
随着模型参数量的增加,显存溢出(OOM)成为常态。
- 混合精度训练(AMP):使用FP16或BF16格式进行训练,可在几乎不损失精度的情况下,将显存占用减半,并提升计算速度,PyTorch中的
torch.cuda.amp模块可轻松实现这一功能。 - 梯度累积:当批量大小(Batch Size)受限于显存时,可通过梯度累积模拟更大的Batch Size,从而稳定训练过程。
成本控制与运维策略
服务器部署不仅涉及初期硬件投入,更关乎长期的运维成本,对于中小企业和个人开发者,灵活的资源调度策略至关重要。
自建服务器 vs 云端算力
选择哪种方案取决于使用频率和数据敏感性。
| 对比维度 | 自建服务器 | 云端GPU实例 |
|---|---|---|
| 初期投入 | 高(数万元起) | 低(按需付费) |
| 长期成本 | 低(仅电费与维护) | 高(持续租赁费用) |
| 灵活性 | 低(扩容困难) | 高(随时升降配) |
| 维护负担 | 高(需自行处理故障) |
低(服务商负责底层) |
据工信部数据显示,近年来超过半数的初创AI团队倾向于采用混合云策略,即核心数据本地存储,计算任务弹性调度至云端。
节能与散热管理
深度学习服务器功耗巨大,散热和电力成本不容忽视。
- 智能风扇控制:使用
nvidia-smi监控GPU温度,并通过脚本动态调整风扇转速,平衡噪音与散热。 - 空闲资源回收:配置定时任务,在夜间或非高峰时段自动关闭闲置节点,或将其切换至低功耗模式。
- 电力监控:安装智能PDU(电源分配单元),实时监控每台服务器的功耗,识别异常高耗能进程。
常见问题解答(FAQ)
服务器做深度学习时,显存不足怎么办?
当遇到显存溢出错误时,首先检查是否启用了混合精度训练(AMP),减小Batch Size,并使用梯度累积技术,若仍不足,可尝试卸载不需要的模型部分,或使用模型并行策略将模型拆分到多张显卡上,清理Python垃圾回收机制未释放的变量,有时也能释放部分显存。
如何监控服务器上的深度学习任务性能?
推荐使用nvtop或nvidia-smi进行实时监控。nvtop提供了类似任务管理器的图形化界面,能直观显示GPU利用率、显存占用、温度及功耗,对于长期监控,可部署Prometheus和Grafana,收集GPU指标并生成可视化报表,帮助识别性能瓶颈。
深度学习服务器需要什么样的网络连接?
对于单机多卡训练,GPU间通信(如NVLink)比网络更重要,但对于分布式训练或多节点协作,网络带宽成为关键瓶颈,建议至少配备10Gbps以太网,若条件允许,使用InfiniBand或RoCE网络可显著降低节点间通信延迟,提升分布式训练效率。
服务器做深度学习并非简单的硬件堆砌,而是对计算资源、软件生态和运维策略的综合考量,通过合理选型、规范搭建、精细优化及灵活的成本控制,你可以构建出一个高效、稳定且经济的深度学习平台,从而在AI浪潮中占据有利位置。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/463202.html