Hive表存储数据的核心在于将结构化数据映射为HDFS上的文件,通过元数据管理实现SQL查询,适合大规模离线数据分析,但不适合低延迟在线事务处理。
在大数据生态系统中,Hive扮演着连接传统关系型数据库与分布式存储系统的桥梁角色,它允许用户使用类似SQL的语言(HQL)来操作存储在Hadoop分布式文件系统(HDFS)中的数据,这种设计极大地降低了大数据分析的技术门槛,让熟悉SQL的开发者能够迅速上手处理PB级别的数据,理解其底层存储机制对于优化查询性能、控制成本以及避免常见陷阱至关重要。
Hive表存储数据的基本架构与原理
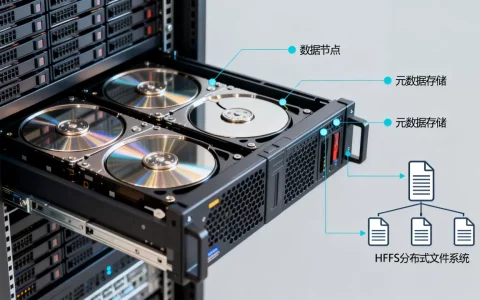
Hive的本质是一个数据仓库工具,它将数据存储在HDFS上,并将表的元数据(如表名、列名、数据类型、分区信息等)存储在关系型数据库(如MySQL)中,这种分离架构使得Hive能够利用Hadoop的扩展性来处理海量数据,同时通过元数据管理提供类SQL的查询接口。
内部表与外部表的区别
在创建Hive表时,选择内部表(Managed Table)还是外部表(External Table)是首要决策点,这直接影响数据的生命周期管理。
- 内部表:Hive完全控制数据,当删除内部表时,Hive会同时删除元数据信息和HDFS上的数据文件,这种模式适用于临时数据或完全由Hive管理的中间结果集。
- 外部表:Hive仅管理元数据,数据文件由外部系统(如Sqoop导入、Flume收集)独立管理,删除外部表时,仅删除元数据,HDFS上的原始数据保留,这种模式适用于共享数据或需要与其他系统交互的场景。
业内专家指出,对于生产环境中的核心数据资产,推荐使用外部表,以避免因误操作导致的数据丢失风险,并确保数据在多系统间的共享安全性。
存储格式的选择
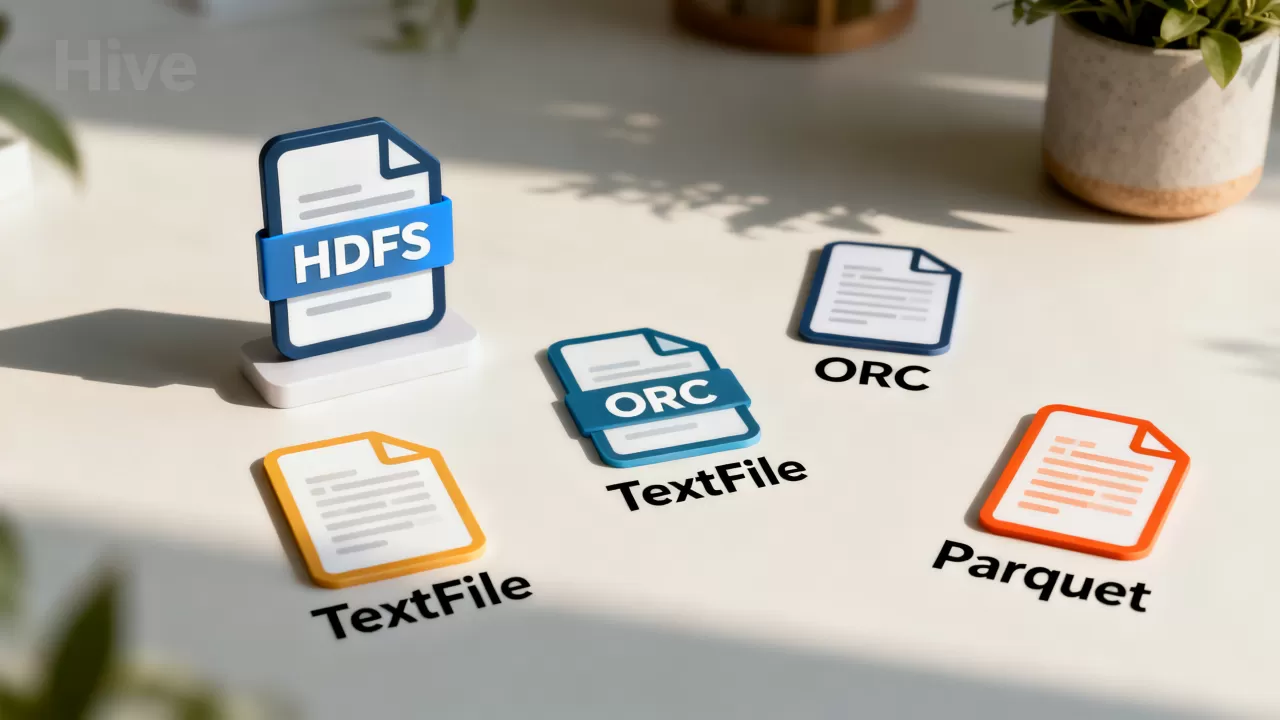
Hive支持多种存储格式,不同的格式在压缩比、查询速度和存储开销上各有优劣,选择合适的存储格式是优化Hive性能的关键环节。
文本格式(TextFile)
TextFile是Hive的默认存储格式,它采用行式存储,易于生成和解析,但压缩率低,查询时需要扫描大量无用数据,适用于数据导入阶段或作为临时存储,不建议用于高频查询的生产环境。
列式存储格式(ORC/Parquet)
ORC(Optimized Row Columnar)和Parquet是两种主流的列式存储格式,它们将同一列的数据存储在一起,具有以下显著优势:
- 高效压缩:由于同一列数据类型相同,压缩算法效率极高,通常可节省50%-70%的存储空间。
- 谓词下推:查询时只需读取需要的列,大幅减少I/O开销。
- 索引支持:ORC支持索引,可加速特定值的查找。
据工信部相关数据,采用列式存储后,复杂分析查询的性能通常可提升数倍至数十倍,在现代Hive数据仓库建设中,ORC或Parquet已成为事实标准。
Hive表存储数据的高级优化策略
随着数据量的增长,简单的表结构已无法满足性能需求,通过分区、分桶和索引等技术,可以显著优化Hive表的存储效率和查询速度。
分区表的应用场景
分区是将表数据按特定字段(如日期、地区)划分为不同的目录结构,查询时,Hive可以通过分区裁剪(Partition Pruning)跳过无关目录,仅扫描目标分区数据。
- 静态分区:手动指定分区值,适用于数据量固定且可预见的场景。
- 动态分区:根据数据内容自动创建分区,适用于数据流入时间不确定、需自动归类的场景。
需要注意的是,分区字段的选择至关重要,应避免使用基数过低(如性别)或过高(如用户ID)的字段作为分区键,否则会导致小文件过多或分区裁剪失效。
分桶表与数据倾斜处理
分桶是将表数据按某个字段的哈希值分散到固定数量的文件中,分桶主要用于提高Join操作的效率,特别是当Join键与分桶键一致时,Hive可以进行Map-side Join,避免Shuffle阶段的数据传输。
在大数据处理中,数据倾斜是一个常见痛点,当某些Key的数据量远大于其他Key时,会导致个别Reduce任务执行时间过长,通过分桶和适当的Join策略(如Map Join),可以有效缓解这一问题。
Hive表存储数据在不同场景下的实践指南
不同的业务场景对Hive表的存储要求各异,理解这些差异有助于制定更合理的数据架构。
离线数仓构建
在离线数仓中,数据通常按天或小时批量加载,应优先使用分区表结合列式存储格式,将数据按dt(日期)字段进行分区,并存储为ORC格式,这种组合既能保证存储效率,又能通过分区裁剪快速响应历史数据分析需求。
实时数据接入与存储
对于实时数据,Hive并非最佳选择,但有时需要将实时数据落地到Hive进行长期存储,可采用Kafka Connect将数据写入HDFS,再通过Hive外部表映射,为避免小文件问题,建议定期合并小文件,或使用Apache Iceberg/Hudi等现代数据湖格式,它们支持增量更新和小文件自动合并。
跨集群数据共享
在多集群环境中,数据共享常通过Hive外部表实现,通过在元数据中配置远程数据库连接,不同集群可以访问同一份HDFS数据,这种方式避免了数据复制,降低了存储成本,但需注意网络延迟对查询性能的影响。
常见问题与解决方案
小文件问题如何解决
小文件会消耗NameNode内存,降低HDFS性能,解决方案包括:
- 合并小文件:在写入数据前,使用
hive.merge.mapfiles和hive.merge.mapredfiles参数合并输出文件。 - 调整并行度:适当增加Map任务数量,减少单个文件的数据量。
- 使用ACID表:Hive 0.14+支持ACID事务,可自动管理小文件合并。
查询速度慢如何优化
查询慢通常由I/O瓶颈或计算资源不足引起,优化措施包括:
- 启用向量化执行:设置
hive.vectorized.execution.enabled=true,利用SIMD指令加速计算。 - 调整内存参数:根据集群资源,合理设置
hive.exec.reducers.bytes.per.reducer等参数。 - 使用统计信息:执行
ANALYZE TABLE收集统计信息,帮助优化器生成更优的执行计划。
数据一致性如何保证
Hive传统上不支持事务,但在高版本中引入了ACID支持,对于需要强一致性的场景,建议使用Hive ACID表或转向Apache HBase等支持实时事务的系统,若必须使用Hive,可通过外部事务管理器或应用层逻辑保证数据一致性。
Hive表存储数据的核心在于平衡存储效率、查询性能与管理复杂度,通过合理选择内部/外部表、列式存储格式、分区与分桶策略,并结合具体业务场景进行优化,可以构建高效、稳定的大数据存储体系,随着数据湖技术的演进,Hive正逐步与Iceberg、Hudi等现代格式融合,为大数据存储提供更灵活、高效的解决方案。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/453245.html