Hive的数据存储本质上是基于HDFS的文件系统,它将数据以文本、序列文件或列式存储格式保存在HDFS上,并通过元数据(Metadata)来管理这些文件的结构和位置。
很多人对Hive有一个误解,认为它是一个像MySQL那样的传统关系型数据库,Hive更像是一个“翻译官”或者“外壳”,当你执行一条SQL语句时,Hive并不会像传统数据库那样直接读写内存或本地磁盘,而是把SQL翻译成MapReduce、Tez或Spark任务,去操作底层HDFS上的文件,理解Hive如何存储,关键在于理解它如何将逻辑上的“表”映射到物理上的“文件”。
Hive底层存储架构解析
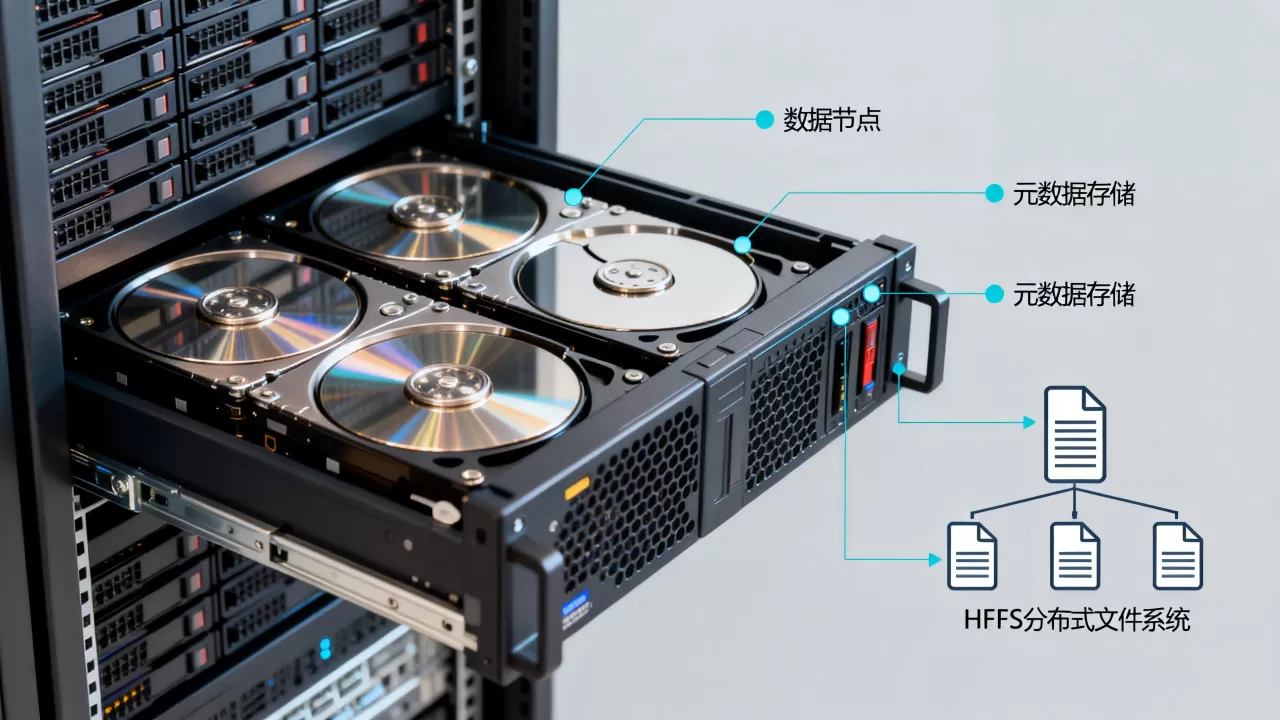
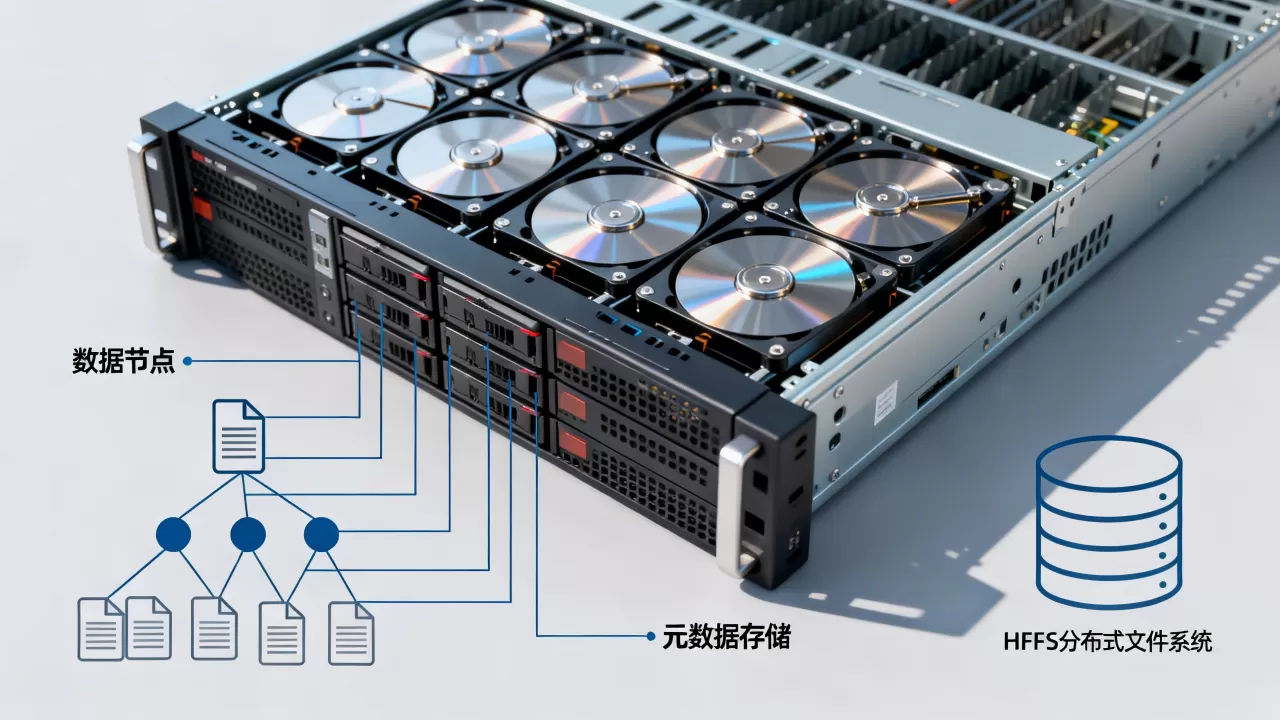
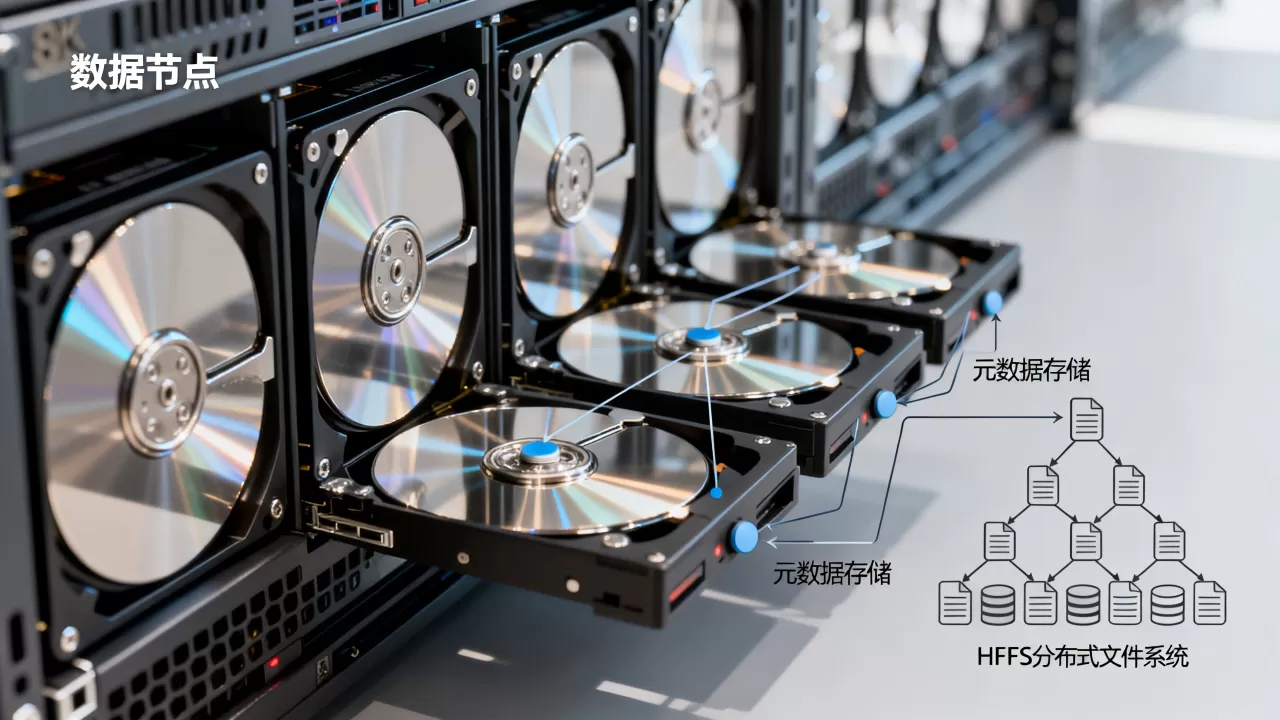
要搞清楚Hive的存储机制,我们需要把视线从SQL层下沉到HDFS层,Hive本身不存储数据,它只存储元数据,真正的数据实体,全部躺在Hadoop Distributed File System(HDFS)上。
元数据:数据的“索引目录”
元数据是Hive的大脑,它记录了表名、列名、分区信息、存储格式等结构信息,默认情况下,Hive使用Derby数据库存储元数据,但这仅适用于单用户测试环境,在生产环境中,业内专家指出,绝大多数企业会选择MySQL或PostgreSQL作为元数据存储后端,因为这样支持多用户并发访问和更高的稳定性。
元数据的作用类似于图书馆的目录卡片,当你查询一张表时,Hive首先去元数据库里查找这张表对应的HDFS路径、文件类型以及列的定义,如果没有元数据,Hive就不知道去哪里找数据,也不知道数据长什么样。
数据文件:真正的“仓库”
数据文件存储在HDFS上,这是Hive存储的核心,Hive支持多种存储格式,不同的格式决定了数据的压缩率、读取速度和计算效率。
文本文件(TextFile)
这是Hive默认的存储格式,它的特点是简单、通用,任何系统生成的文本都可以直接导入,TextFile不进行压缩,且不支持列裁剪,这意味着查询时可能需要读取整个文件,效率较低,适合用于数据归档或对查询性能要求不高的场景。
序列文件(SequenceFile)
SequenceFile是Hadoop自带的二进制键值对存储格式,它支持压缩,存储密度比TextFile高,但同样不支持列裁剪,如果你需要频繁写入大量小文件,SequenceFile是一个不错的选择,因为它能有效合并小文件,减少NameNode的压力。
列式存储(ORC/Parquet)
这是目前大数据领域的主流选择,与行式存储不同,列式存储将同一列的数据存储在一起,这种结构带来了巨大的优势:
- 列裁剪:查询时只需读取需要的列,忽略其他列,大幅减少I/O。
- 数据压缩:同一列的数据类型相同,压缩率极高,通常能节省50%-80%的存储空间。
- 向量化执行:现代引擎(如Spark、Presto)对列式存储有专门的优化,计算速度更快。
ORC(Optimized Row Columnar)是Hive生态中最推荐的格式,而Parquet则在Spark和Presto生态中更受欢迎,选择哪种格式,往往取决于你使用的计算引擎。
内部表与外部表的存储差异
在Hive中,创建表时有两种主要类型:内部表(Managed Table)和外部表(External Table),它们的存储路径看似相同,但在生命周期管理上有着本质的区别。
内部表:Hive的“亲生孩子”
内部表的数据和元数据都由Hive完全管理,当你删除内部表时,Hive会同时删除元数据记录以及HDFS上对应的数据文件,这就像是你把数据存进了Hive的“保险箱”,Hive负责保管,也负责销毁。
这种模式适合那些完全由Hive生成、不需要被其他系统直接访问的数据,中间处理结果表、临时聚合表等。
外部表:Hive的“租客”
外部表只管理元数据,数据文件存放在用户指定的HDFS路径上,当你删除外部表时,Hive只会删除元数据,而保留HDFS上的数据文件,这就像是你租了一个仓库,Hive只负责给你钥匙和记账,仓库里的货你随时可以拿走或销毁。
外部表非常适合以下场景:
- 数据由其他系统(如Flume、Sqoop)直接写入HDFS,Hive只是用来查询。
- 需要共享数据给多个工具(如Spark、Presto)使用,避免数据重复拷贝。
-
防止误操作导致数据丢失,因为删除表不会删除数据。
业内共识认为,在生产环境中,外部表的使用比例远高于内部表,因为大数据平台往往涉及多工具协作,数据共享和安全性是首要考虑因素。
分区与分桶:存储优化的关键手段
随着数据量达到TB甚至PB级别,全表扫描成为性能杀手,为了解决这个问题,Hive引入了分区和分桶两种机制。
分区:静态的“文件夹”
分区是将数据按照某个列的值(如日期、地区)划分到不同的目录中,你可以按天分区,每天的数据存放在一个独立的文件夹下。
当查询条件中包含分区字段时,Hive会利用“分区裁剪”技术,直接定位到对应的文件夹,跳过其他无关数据,这就像你在图书馆找书,如果知道书在哪个书架(分区),就不需要翻遍整个图书馆。
需要注意的是,分区字段的选择至关重要,如果分区过多(如按小时分区且数据量巨大),会导致HDFS上产生大量小文件,增加NameNode的内存压力,行业经验表明,分区粒度的选择需要根据数据增长速度和查询频率来平衡。
分桶:动态的“哈希桶”
分桶是对数据进行哈希取模,将数据分散到固定数量的文件中,分桶的主要目的是提高Join操作的效率。
当两张表按照相同的列进行分桶时,Hive可以采用Map-side Join,即在Map阶段直接读取对应的桶文件进行连接,无需进行Shuffle,从而大幅提升性能,但分桶的缺点是写入成本高,因为需要预先计算哈希值并决定写入哪个桶。
存储格式与压缩技术的最佳实践
在实际操作中,选择合适的存储格式和压缩算法,能显著提升Hive的性能和成本效益。
存储格式对比
| 特性 | TextFile | SequenceFile | ORC | Parquet |
|---|---|---|---|---|
| 存储类型 | 行式 | 行式 | 列式 | 列式 |
| 压缩率 | 低 | 中 | 高 | 高 |
| 列裁剪 | 不支持 | 不支持 | 支持 | 支持 |
| 适用场景 | 数据归档 | 小文件合并 | Hive/Spark | Spark/Presto |
压缩算法选择
压缩算法的选择需要在CPU时间和存储空间之间做权衡。
- Gzip:压缩率高,但不可分割,不支持并行读取,不推荐用于Hive表。
- Lzo:压缩率适中,可分割,支持并行读取,但需要额外安装Lzo库。
- Snappy:压缩和解压速度极快,压缩率一般,是目前最流行的选择,尤其适合对延迟敏感的场景。
- Snappy + ORC/Parquet:这是目前的黄金组合,兼顾了高压缩率和高读取性能。
据统计,采用Snappy压缩的ORC格式,相比未压缩的TextFile,通常能节省60%-80%的存储空间,同时将查询速度提升数倍。
常见问题解答
Hive如何存储数据的具体路径在哪里查看?
你可以通过Hive CLI或Beeline客户端,使用DESCRIBE FORMATTED table_name;命令查看表的详细信息,在输出结果中,找到Location字段,那里显示的就是数据在HDFS上的绝对路径。hdfs://namenode:8020/user/hive/warehouse/db_name/table_name。
为什么我的Hive查询很慢,是存储格式的问题吗?
存储格式确实是影响性能的重要因素,但不是唯一因素,如果查询慢,首先检查是否使用了列式存储(ORC/Parquet)并启用了Snappy压缩,检查查询条件是否命中了分区字段,避免全表扫描,小文件过多也会导致NameNode压力大,影响查询调度,建议定期执行OPTIMIZE或COMPACT操作来合并小文件。
内部表和外部表在存储上有什么区别?
在物理存储上,内部表和外部表没有区别,数据都存放在HDFS的指定目录下,区别在于元数据管理:删除内部表时,Hive会删除HDFS上的数据文件;删除外部表时,HDFS上的数据文件会被保留,外部表更适合数据共享和防误删场景。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/471043.html