Hadoop大数据集群技术的核心在于通过分布式存储与计算框架,解决海量数据的低成本存储与高效处理问题,其本质是利用廉价硬件构建高可用、高扩展性的数据基础设施。
Hadoop集群架构的核心逻辑与组件解析
Hadoop并非单一软件,而是一个由多个模块组成的生态系统,理解其架构是构建集群的第一步,业内专家指出,Hadoop的核心价值在于它将数据从“移动计算”转变为“计算移动”,即让程序靠近数据,而非让数据靠近程序。

HDFS分布式文件系统:数据的物理底座
HDFS(Hadoop Distributed File System)负责数据的存储,它采用主从架构,由NameNode和DataNode组成,NameNode是集群的大脑,管理文件系统的命名空间和客户端对文件的访问;DataNode是集群的肌肉,负责实际存储数据块并执行读写操作。
关键机制详解
- 块大小机制:HDFS默认块大小为128MB或256MB,大文件被切分为固定大小的块,分散存储在多个节点上,这种设计减少了寻道时间,提高了吞吐率。
- 副本策略:为保证数据高可用,HDFS默认将每个数据块复制3份,副本分布遵循“机架感知”策略:一份存放在本地节点,一份存放在同机架的其他节点,最后一份存放在不同机架的节点,这种策略在平衡数据可靠性与网络带宽消耗之间取得了最佳平衡。
- 容错性:当某个DataNode失效时,NameNode会自动检测并重新复制失效块,确保数据不丢失,用户无需干预,系统自动完成修复。
YARN资源调度:集群的中央处理器
YARN(Yet Another Resource Negotiator)是Hadoop 2.0引入的资源管理系统,它解耦了资源管理与作业调度,使得Hadoop不仅能运行MapReduce,还能支持Spark、Flink等多种计算框架。
核心组件分工
- ResourceManager:全局资源管理者,负责分配资源给各个应用程序。
- NodeManager:单节点代理,负责管理该节点上的容器(Container)资源,监控资源使用情况。
- ApplicationMaster:每个应用程序的专属管理者,负责与ResourceManager协商资源,并与NodeManager通信以执行任务。
这种架构解决了Hadoop 1.0中JobTracker单点故障和资源利用率低的问题,使得集群资源能够被多种计算框架共享,极大提升了硬件投资回报率。
企业级Hadoop集群部署与运维实战
在实际生产环境中,搭建一个稳定运行的Hadoop集群远比理论复杂,许多企业在选择hadoop大数据集群搭建方案时,往往低估了运维的难度,以下是基于行业共识的实操步骤与关键配置要点。
环境准备与硬件选型
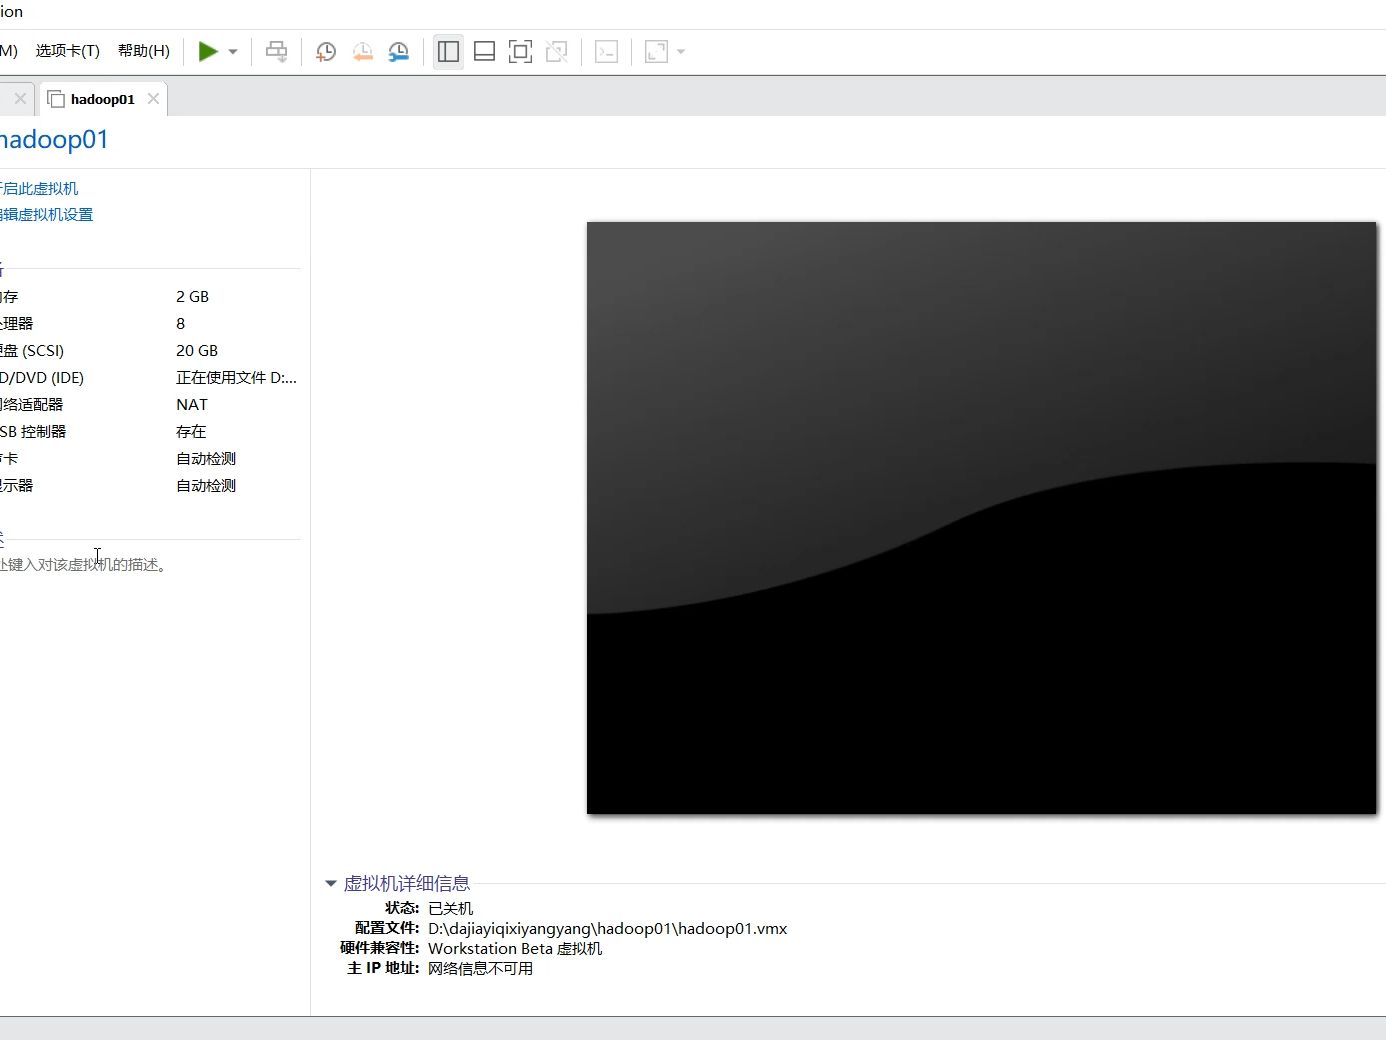
硬件配置直接决定集群性能,对于hadoop集群硬件配置推荐,建议遵循以下原则:
- 节点角色:NameNode和ResourceManager对内存和CPU要求极高,建议配备大容量内存(如64GB以上)和高主频CPU,DataNode和NodeManager侧重I/O性能,需配备高速硬盘(SSD用于元数据或热数据,HDD用于冷数据)。
- 网络带宽:集群内部通信频繁,建议采用万兆网卡(10GbE)连接交换机,避免网络成为瓶颈。
- 操作系统:主流选择CentOS 7/8或Ubuntu LTS版本,需关闭防火墙或配置相应端口,禁用SELinux。
关键配置文件优化
配置文件位于$HADOOP_HOME/etc/hadoop目录下,修改这些文件是调优的关键。
core-site.xml
此文件配置Hadoop的核心属性,设置默认文件系统为HDFS,配置NameNode的地址:
<property>
    <name>fs.defaultFS</name>
    <value>hdfs://namenode-host:8020</value>
</property>
<property>
    <name>hadoop.tmp.dir</name>
    <value>/var/hadoop/tmp</value>
</property>
hdfs-site.xml
配置HDFS副本数、块大小及数据目录:
<property>
    <name>dfs.replication</name>
    <value>3</value>
</property>
<property>
    <name>dfs.namenode.name.dir</name>
    <value>file:///data/dfs/nn</value>
</property>
<property>
    <name>dfs.datanode.data.dir</name>
    <value>file:///data/dfs/dn</value>
</property>
yarn-site.xml
配置YARN的资源调度器,通常使用Capacity Scheduler或Fair Scheduler:
<property>
    <name>yarn.resourcemanager.hostname</name>
    <value>resourcemanager-host</value>
</property>
<property>
    <name>yarn.nodemanager.aux-services</name>
    <value>mapreduce_shuffle</value>
</property>
集群启动与验证
格式化NameNode(仅在首次启动时执行):
hdfs namenode -format
启动HDFS和YARN:
start-dfs.sh
start-yarn.sh
验证集群状态,访问Web UI(默认端口50070或9870查看HDFS,8088查看YARN),检查节点是否全部在线,副本是否完整。
Hadoop生态系统的演进与替代方案对比
随着技术发展,Hadoop并非唯一选择,企业在进行hadoop与spark对比分析时,需明确各自适用场景。
Hadoop vs. Spark:计算引擎的差异
MapReduce是Hadoop的原生计算框架,而Spark是其生态中的高性能引擎。
| 特性 | MapReduce | Spark |
|---|---|---|
| 计算模式 | 基于磁盘的迭代计算 | 基于内存的迭代计算 |
| 速度 | 较慢,适合离线批处理 | 快10-100倍,适合实时/近实时处理 |
| 容错机制 | 通过重新计算丢失的数据块 | 通过RDD的线性依赖关系恢复 |
| 适用场景 | 海量数据离线ETL | 机器学习、图计算、实时流处理 |
尽管Spark速度更快,但HDFS作为存储层依然不可或缺,Spark通常部署在YARN之上,利用HDFS存储数据,利用YARN管理资源,三者形成互补而非替代关系。
云原生Hadoop与混合云趋势
近年来,hadoop大数据集群价格因云服务普及而大幅降低,企业不再需要自建物理集群,而是选择AWS EMR、Azure HDInsight或阿里云EMR等托管服务,云原生Hadoop将存储与计算分离,存储使用对象存储(如S3),计算使用弹性容器,实现了极致的成本优化和弹性伸缩。
对于数据敏感型行业,如金融和医疗,私有化部署Hadoop集群仍是主流选择,以确保数据主权和安全合规,据工信部数据,超过半数的传统行业数字化转型项目仍采用混合云架构,平衡成本与安全。
常见问题与解决方案
hadoop大数据集群常见故障排查指南
- NameNode无法启动:检查hdfs-site.xml中dfs.namenode.name.dir目录权限,确保Hadoop用户有读写权限,查看logs目录下的namenode.log,定位具体错误。
- DataNode掉线:检查防火墙是否开放50010端口,确认网络连通性,查看datanode.log,确认是否与NameNode通信超时。
- 任务运行缓慢:检查是否存在数据倾斜,通过Web UI查看Task进度,若某个Task进度远慢于其他,可能是Key分布不均导致,可通过调整MapReduce参数或预处理数据解决。
hadoop大数据集群维护最佳实践
- 定期备份元数据:NameNode的元数据是集群的核心,需定期将fsimage和edits文件备份到异地存储。
- 监控告警:部署Zabbix或Prometheus监控集群关键指标,如磁盘使用率、CPU负载、GC时间等,设置阈值告警。
- 小文件处理:HDFS不适合存储大量小文件,会消耗NameNode内存,建议通过CombineFileInputFormat或定期合并小文件来优化。
hadoop大数据集群安全配置要点
- Kerberos认证:启用Kerberos防止未授权访问,确保集群内通信安全。
- SSL加密:配置HTTPS和SSL,保护数据传输过程中的隐私。
- 权限控制:利用HDFS权限和Ranger/Sentry进行细粒度访问控制,确保数据最小权限原则。
Hadoop大数据集群技术虽已成熟,但其复杂性要求运维人员具备深厚的理论基础和实操经验,通过合理架构设计、精细化配置及持续监控,企业可充分发挥其价值,为数据驱动决策提供坚实支撑。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/450076.html