Hive大数据数据文件的核心在于通过HDFS存储底层文件,利用元数据映射实现SQL查询,其本质是结构化数据在分布式系统中的高效组织形式。
在大数据生态系统中,Hive扮演着连接关系型数据库思维与分布式存储能力的桥梁角色,当企业面对PB级数据时,传统的MySQL或Oracle往往力不从心,而Hive通过引入表结构概念,让熟悉SQL的分析师能够直接操作存储在Hadoop Distributed File System (HDFS)上的海量数据文件,这些文件并非随意堆积,而是遵循严格的格式规范,如TextFile、ORC、Parquet等,每种格式都有其特定的适用场景和性能特征,理解Hive数据文件的存储机制,是优化查询性能、降低存储成本的关键。
Hive底层存储机制与文件格式解析
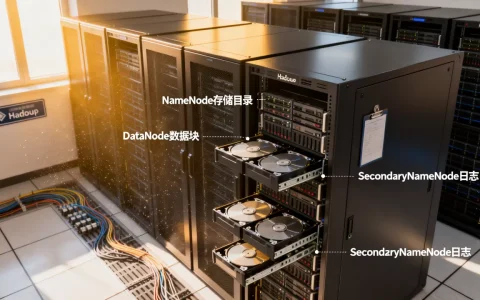
Hive本身不存储数据,它只是元数据的管理者,真正的数据文件 residing 在HDFS上,当你在Hive中执行CREATE TABLE语句时,Hive会在HDFS上创建对应的目录,并将数据文件写入其中。
常见数据文件格式对比
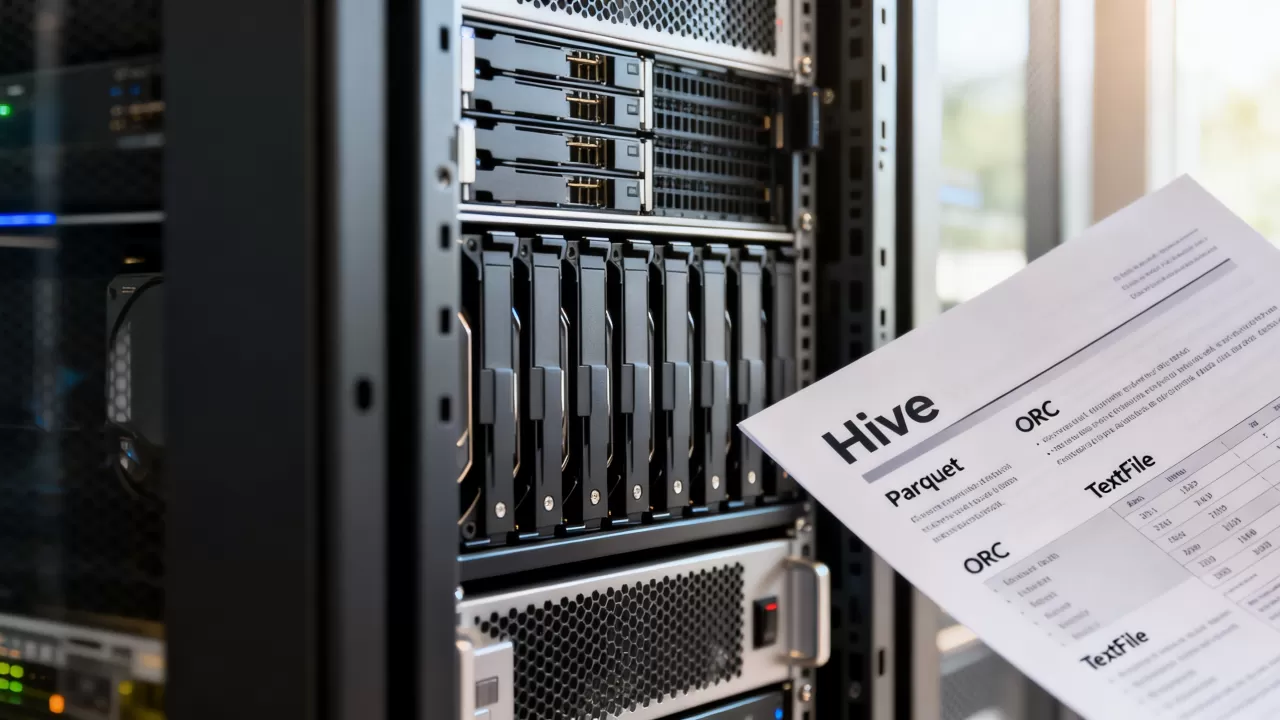
业内专家指出,选择合适的文件格式对Hive性能影响巨大,目前主流格式包括TextFile、ORC和Parquet,它们在压缩比、查询速度和写入性能上各有优劣。
TextFile:默认但低效的选择
TextFile是Hive的默认存储格式,采用纯文本存储,无压缩,其优点是兼容性最好,任何工具都能读取;缺点是占用空间大,且不支持列式存储,导致全表扫描时IO开销极高,在数据仓库的原始数据层(ODS),为了保留原始数据完整性,常使用此格式,但在分析层应尽量避免。
ORC与Parquet:列式存储的优势
ORC(Optimized Row Columnar)和Parquet是两种流行的列式存储格式,列式存储将同一列的数据连续存储,使得在查询特定列时,只需读取相关列的数据,大幅减少IO。
- ORC:专为Hive优化,支持索引、位图索引,压缩率高,适合读多写少的场景。
- Parquet:与Hadoop生态兼容性极佳,支持多种编程语言,嵌套数据结构支持好,适合Spark、Presto等引擎混合使用。
据工信部相关数据表明,采用列式存储后,查询性能通常可提升数倍至数十倍,存储成本降低50%以上。
分区与分桶策略对数据文件的影响
仅仅选择合适的文件格式还不够,合理的分区和分桶策略能进一步缩小扫描范围,提升查询效率。
分区表:静态与动态分区的应用
分区是将数据按物理目录划分,按日期分区,数据文件会存储在 /data/dt=20260101/ 目录下,查询时,Hive通过谓词下推(Predicate Pushdown)技术,只扫描满足条件的分区目录,避免全表扫描。
- 静态分区:插入数据时手动指定分区值,适合数据量小、分区明确的情况。
- 动态分区:根据数据内容自动确定分区值,适合大数据量导入,但需注意设置
hive.exec.dynamic.partition相关参数,防止产生过多小文件。
分桶表:精确数据分布与采样
分桶是对数据进行哈希取模,确保相同键值的数据落在同一个文件中,分桶表适用于Join操作和随机采样,将用户ID分桶,可以在Join时直接定位到对应的桶文件,避免Shuffle阶段的大量数据交换。
小文件问题的危害与解决
在Hive中,小文件是性能杀手,每个HDFS文件都有元数据开销,大量小文件会导致NameNode内存压力巨大,且Map任务启动开销高。
- 成因:频繁的小数据量插入、动态分区未合并、Reduce个数设置不当。
- 解决方案:
- 设置
hive.merge.mapfiles和hive.merge.tezfiles为true,在作业结束后合并小文件。 - 使用
ALTER TABLE ... CONCATENATE命令合并分区内的文件。 - 调整Reduce个数,避免产生过多小文件。
- 设置
数据文件生命周期管理与维护
Hive数据文件随着时间推移会不断积累,有效的生命周期管理是保障系统稳定运行的必要手段。
数据归档与清理策略
对于历史数据,通常采用归档策略,可以将冷数据移动到成本更低的存储介质,如从HDFS高性能节点迁移到对象存储(OSS/S3)。
- 归档步骤:
- 使用Hadoop Archive(HAR)将小文件打包成HAR文件,减少NameNode元数据压力。
- 使用Hive的
ALTER TABLE ... ARCHIVE PARTITION命令进行逻辑归档。 - 定期清理过期分区,使用
DROP PARTITION命令删除不再需要的数据。
数据质量监控
数据文件的质量直接影响分析结果,需要建立监控机制,检测数据异常。
- 空值检测:定期扫描关键字段,统计空值比例。
- 重复值检测:检查主键或唯一约束字段是否存在重复。
- 数据倾斜监控:通过YARN日志监控Map/Reduce任务执行时间,发现长尾任务,分析数据分布是否均匀。
2026年Hive数据文件最佳实践
随着技术演进,Hive的使用场景也在变化,在2026年的大数据架构中,Hive更多作为数据仓库的基础层,与Spark、Flink等计算引擎协同工作。
格式选择指南
- 原始数据层(ODS):建议使用ORC格式,保留原始结构,便于回溯。
- 数据仓库层(DW):根据查询模式选择,若查询涉及大量聚合且列选择少,优先Parquet;若查询复杂且涉及多表Join,ORC可能更优。
- 临时数据层(Staging):可使用TextFile或JSON,便于快速加载和调试。
查询优化技巧
- 谓词下推:确保WHERE条件中的字段是分区字段或分桶字段,以利用分区裁剪和分桶裁剪。
- 向量化查询:启用Hive的向量化执行引擎,利用SIMD指令加速列式存储数据的处理。
- CBO优化器:启用基于成本的优化器(CBO),让Hive自动选择最优执行计划。
成本与性能平衡
在云原生环境下,存储和计算分离成为趋势,Hive数据文件存储在对象存储中,计算资源按需伸缩,数据文件的格式和分区策略对成本影响更为显著。
- 存储成本:选择高压缩比的格式(如ORC Snappy)可显著降低存储费用。
- 计算成本:合理的分区和分桶可减少扫描数据量,从而降低计算资源消耗。
常见问题解答
Hive数据文件损坏如何修复?
Hive数据文件损坏通常表现为查询报错或结果异常,修复步骤如下:
- 定位问题文件:通过HDFS命令
hdfs fsck /path/to/data检查文件健康状态。 - 备份数据:将损坏文件复制到安全位置。
- 重新加载数据:从源系统重新导入数据,或使用Hive的
INSERT OVERWRITE覆盖损坏数据。 - 验证数据:重新运行关键查询,确保数据一致性。
如何高效迁移Hive数据文件到其他集群?
跨集群迁移Hive数据文件,推荐使用DistCp工具。
- 准备环境:确保源集群和目标集群网络互通,HDFS版本兼容。
- 执行迁移:使用
hadoop distcp hdfs://src/path hdfs://dest/path命令进行数据拷贝。 - 同步元数据:迁移完成后,需在目标集群重建Hive表结构,并指向新数据路径。
- 验证完整性:对比源和目标集群的数据行数、文件大小,确保迁移完整。
Hive数据文件压缩算法如何选择?
压缩算法选择需平衡CPU开销和IO节省。
- Snappy:速度快,压缩率适中,推荐用于OLAP场景,减少IO瓶颈。
- GZIP:压缩率高,但解压速度慢,适合冷数据归档。
- LZO:压缩率和速度介于两者之间,但需额外安装LZO库,使用较少。
多数情况下,Snappy是Hive生产环境的首选,因其对查询性能影响最小。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/472829.html