分布式缓存服务器的核心设计原理在于通过数据分片、节点冗余和一致性哈希算法,将海量数据分散存储在多个独立节点上,从而实现高并发下的低延迟访问与系统的高可用性。
想象一下,如果所有用户的请求都涌向同一台服务器,那就像早高峰的地铁只开一扇门,瞬间就会瘫痪,分布式缓存正是为了解决这种“单点拥堵”而生的,它不再依赖单一的存储中心,而是构建了一个由多个节点组成的网络,每个节点各司其职,共同分担压力,这种架构不仅提升了读取速度,更确保了当某个节点故障时,整个系统依然能正常运转。
分布式缓存的核心架构与数据分片策略
在分布式系统中,如何决定数据存在哪里,是设计的首要难题,业内专家指出,数据分片(Sharding)是解决这一问题的关键手段。
一致性哈希算法的应用场景
传统的取模分片法存在致命缺陷:当增加或减少节点时,大量数据需要重新迁移,导致系统抖动,一致性哈希算法通过构建一个虚拟的哈希环,将数据和节点都映射到这个环上。
- 顺时针查找:数据根据Key的哈希值落在环上的某个点,顺时针找到的第一个节点就是其存储位置。
- 虚拟节点技术:为了解决节点分布不均的问题,每个物理节点在哈希环上对应多个虚拟节点,这使得数据分布更加均匀,避免了某些节点负载过高的情况。
这种机制使得在扩容或缩容时,只有少量数据需要迁移,极大地降低了系统维护成本,据统计,采用一致性哈希的集群在节点变动时,数据迁移量通常控制在极小比例,保障了业务的连续性。
主从复制与读写分离
为了进一步提升性能,分布式缓存通常采用主从复制架构。
- 主节点(Master):负责处理写请求,并将数据同步给从节点。
- 从节点(Slave):负责处理读请求,分担主节点的读取压力。
这种读写分离的设计,使得系统能够承受比单节点高得多的读并发量,在电商大促等场景下,读请求往往远多于写请求,主从架构能显著提升用户体验。
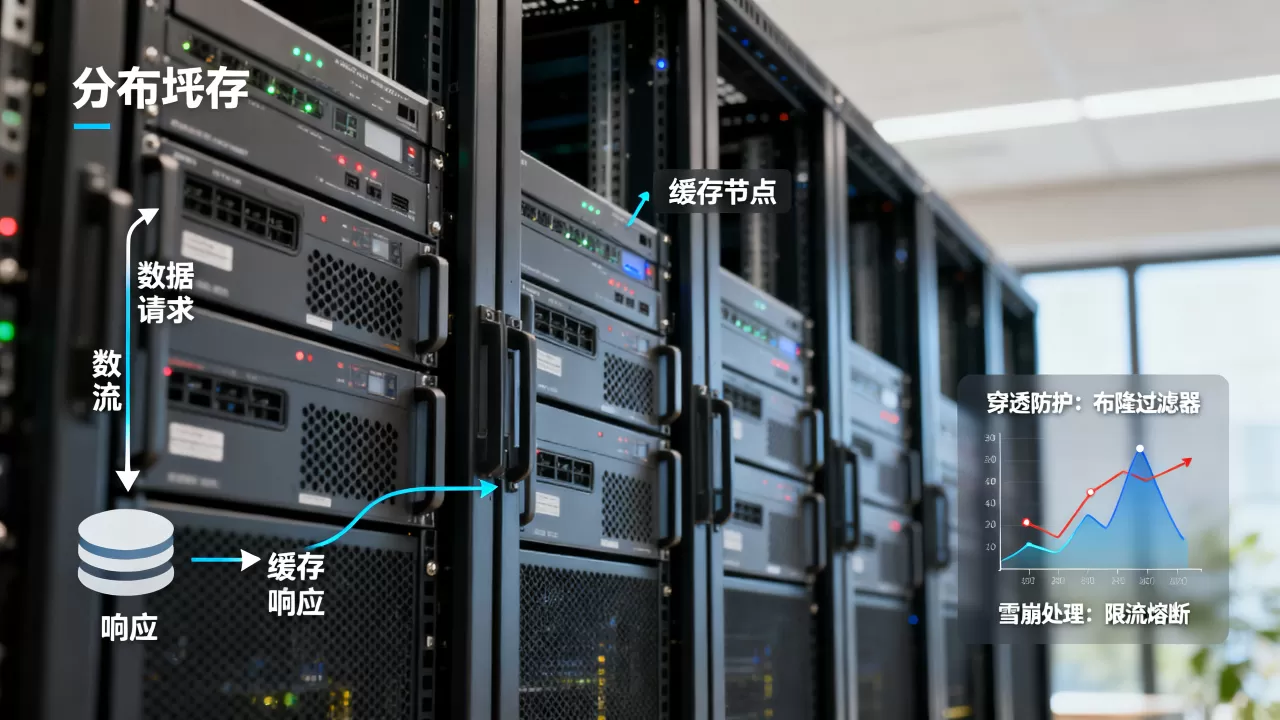
高可用性与数据一致性平衡机制
分布式系统最大的挑战在于如何在节点故障时保持服务可用,同时保证数据的一致性,这是一个典型的CAP定理权衡问题。
故障检测与自动故障转移
节点之间通过心跳机制互相监测状态,一旦某个节点在规定时间内未响应心跳,集群管理器会将其标记为失效。
- 快速切换:故障转移(Failover)过程通常在秒级完成,客户端请求会被自动路由到健康的从节点或新选举的主节点。
- 哨兵模式:以Redis Sentinel为例,它通过监控主从节点状态,在主节点宕机时自动提升一个从节点为主节点,无需人工干预。
这种自动化机制确保了系统在面临硬件故障、网络抖动等异常情况时,依然能提供稳定的服务,多数情况下,用户甚至感知不到后端发生的故障切换。
数据同步策略的选择
数据从主节点同步到从节点,主要有两种策略:同步复制和异步复制。
- 同步复制:主节点在返回写入成功前,必须等待所有从节点确认接收数据,这种方式数据一致性最强,但写入延迟较高。
- 异步复制:主节点写入成功后立即返回,稍后异步通知从节点,这种方式延迟低,性能高,但存在短暂的数据不一致风险。
在实际生产中,通常根据业务需求选择策略,对于金融交易等对一致性要求极高的场景,倾向于使用同步复制或半同步复制;而对于社交动态、评论列表等允许短暂不一致的场景,异步复制则是更优选择。
集群扩展性与运维管理实践
随着业务增长,缓存集群需要不断扩容,如何平滑地扩展集群,同时保证数据不丢失、服务不中断,是运维团队面临的日常挑战。
在线扩容与数据重平衡
分布式缓存集群支持在线扩容,当新增节点时,集群会自动触发数据重平衡(Rebalancing)过程。
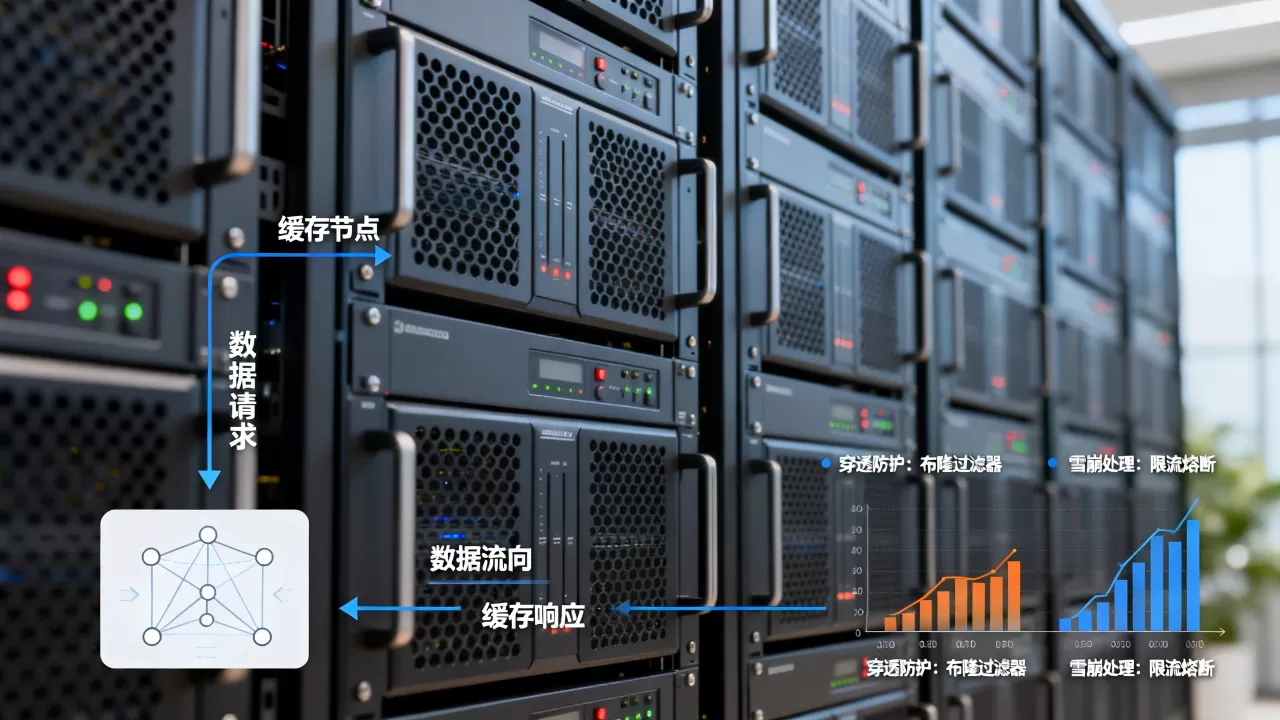
- 加入新节点:将新节点加入集群配置。
- 数据迁移:集群管理器根据哈希环,计算需要迁移的数据块,并在后台逐步迁移。
- 业务无感知:在迁移过程中,客户端请求会被动态路由到正确的节点,业务不受影响。
需要注意的是,数据重平衡会消耗一定的CPU和网络带宽,建议在业务低峰期进行大规模扩容操作,以避免影响线上性能。
配置管理最佳路径
有效的配置管理是集群稳定的基石。
- 内存淘汰策略:设置合理的内存淘汰策略,如LRU(最近最少使用)或TTL(过期时间),防止内存溢出。
- 连接池配置:合理设置客户端连接池大小,避免连接数过多导致服务器资源耗尽。
- 监控告警:部署实时监控工具,跟踪QPS、延迟、命中率等关键指标,设置阈值告警,及时发现潜在问题。
常见技术选型对比与成本考量
在选择分布式缓存方案时,不同技术栈各有优劣,了解它们的特性,有助于做出更合适的决策。
| 特性 | Redis Cluster | Memcached | Hazelcast |
|---|---|---|---|
| 数据结构 | 支持丰富数据结构(String, Hash, List等) | 仅支持简单的Key-Value | 支持丰富数据结构 |
| 持久化 | 支持RDB和AOF持久化 | 不支持持久化 | 支持持久化 |
| 一致性 | 最终一致性,可配置强一致性 | 无状态,每次读取最新 | 强一致性或最终一致性可选 |
| 适用场景 | 通用缓存、会话存储、消息队列 | 简单对象缓存、高并发读 | Java生态内分布式缓存 |
对于需要复杂数据结构支持的场景,Redis Cluster是主流选择,而对于追求极致性能、仅需简单KV存储的场景,Memcached依然具有竞争力,Hazelcast则更适合Java技术栈的企业,便于与现有系统集成。
关于分布式缓存服务器的价格,不同云服务商的定价策略差异较大,通常按节点规格、存储容量和网络流量计费,中小规模应用可选择按需付费,大规模生产环境则适合包年包月以降低成本,据工信部数据,近年来云原生缓存服务的普及率显著提升,企业通过云厂商托管缓存服务,大幅降低了运维复杂度。
分布式缓存服务器设计原理Q&A
分布式缓存如何解决数据倾斜问题?
数据倾斜是指部分节点负载远高于其他节点,解决这一问题的核心在于优化哈希算法和引入虚拟节点,一致性哈希算法配合足够的虚拟节点数量,可以确保数据均匀分布在哈希环上,定期监控各节点负载,动态调整虚拟节点比例,也能有效缓解倾斜现象。
缓存穿透和缓存击穿如何应对?
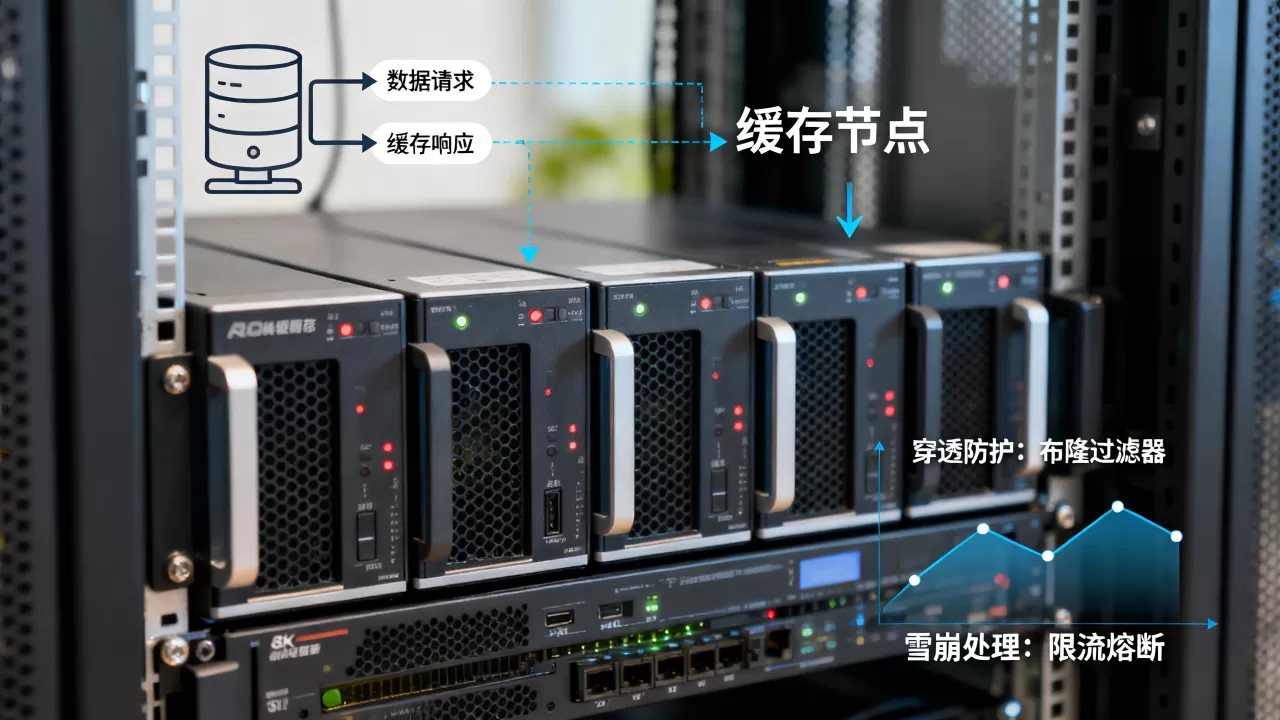
缓存穿透是指查询不存在的数据,导致请求直达数据库,应对策略包括布隆过滤器和设置空值缓存,缓存击穿是指热点Key过期瞬间,大量请求涌入数据库,应对策略包括设置热点Key永不过期、使用互斥锁或采用逻辑过期方案,这些措施能有效保护后端数据库,防止其因过载而崩溃。
分布式缓存与数据库的双写一致性如何保证?
双写一致性是分布式系统的经典难题,常见的解决方案包括先更新数据库再删除缓存,或者通过订阅数据库Binlog异步更新缓存,虽然无法做到绝对实时一致,但通过设置合理的重试机制和延迟双删策略,可以将不一致窗口控制在毫秒级,满足绝大多数业务需求。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/449426.html