分组查询注意力(GQA)是一种在保持多查询注意力(MHA)精度的同时,显著降低计算内存开销的Transformer架构优化技术,它通过让多个查询头共享同一组键值头,实现了推理速度与显存占用的最佳平衡。
在大型语言模型(LLM)快速迭代的今天,模型参数量动辄达到数百亿甚至万亿级别,这给硬件资源带来了巨大压力,传统的多查询注意力机制虽然效果好,但每个查询头都需要独立的键值对,导致在生成文本时,KV Cache(键值缓存)占用大量显存,严重限制了并发处理能力,为了解决这一痛点,业界引入了分组查询注意力机制,它巧妙地利用了注意力头之间的冗余性,通过“共享”策略提升了效率。
GQA的核心原理与架构解析
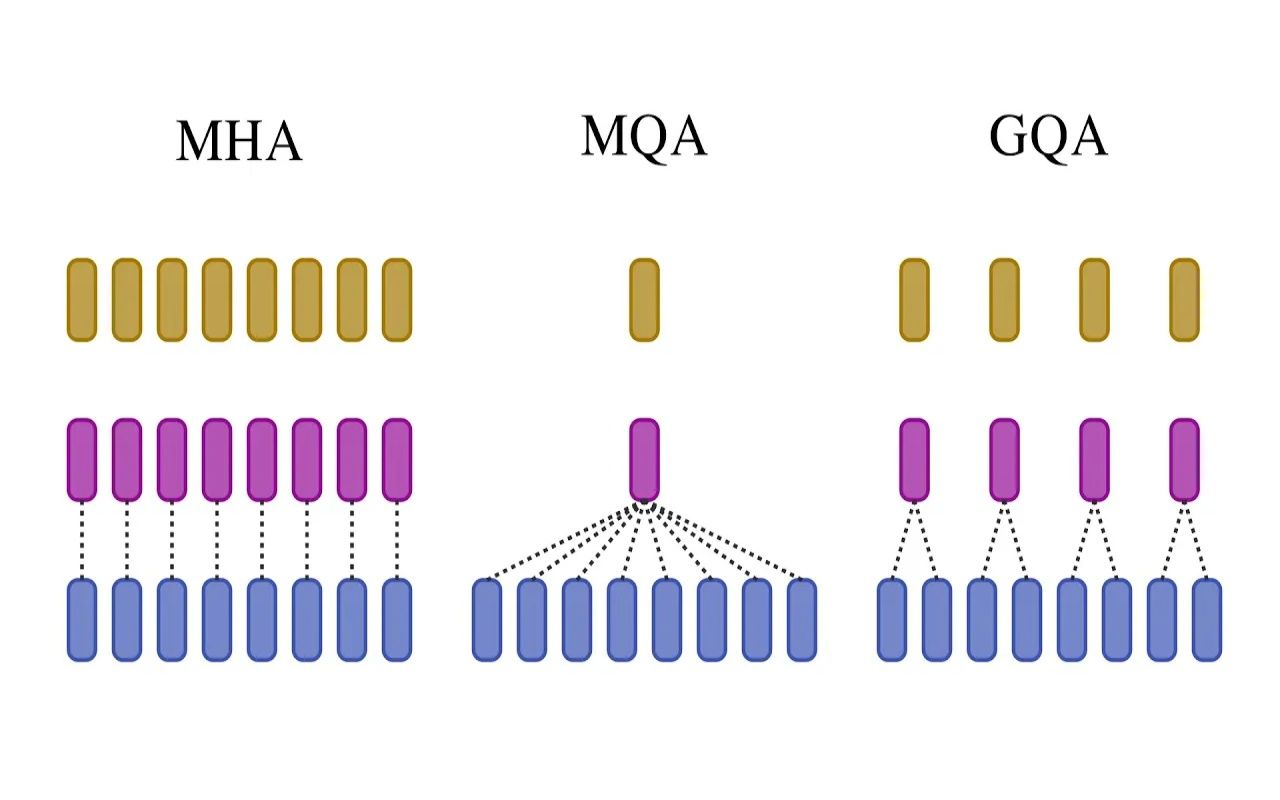
要理解GQA,首先需要对比它与传统机制的区别,业内专家指出,注意力机制的本质是让模型关注输入序列中的不同部分,在多查询注意力(MHA)中,每个查询头(Query Head)都拥有自己独立的键头(Key Head)和值头(Value Head),这种设计虽然能捕捉最细微的特征,但计算和存储成本极高。
从MHA到MQA再到GQA的演进
为了更直观地理解GQA的定位,我们可以将其置于一个演进谱系中观察:
- 多查询注意力(MHA):这是基准线,每个查询头对应一个键头和值头,假设模型有32个查询头,那么就需要32个键头和32个值头,显存占用最大,但精度最高。
- 多查询注意力(MQA):这是极端优化版,所有32个查询头共享唯一的一个键头和一个值头,这种方式极大地节省了显存,因为KV Cache的大小减少了32倍,这种极端的共享往往会导致模型表达能力下降,出现“精度损失”,特别是在复杂推理任务中表现不佳。
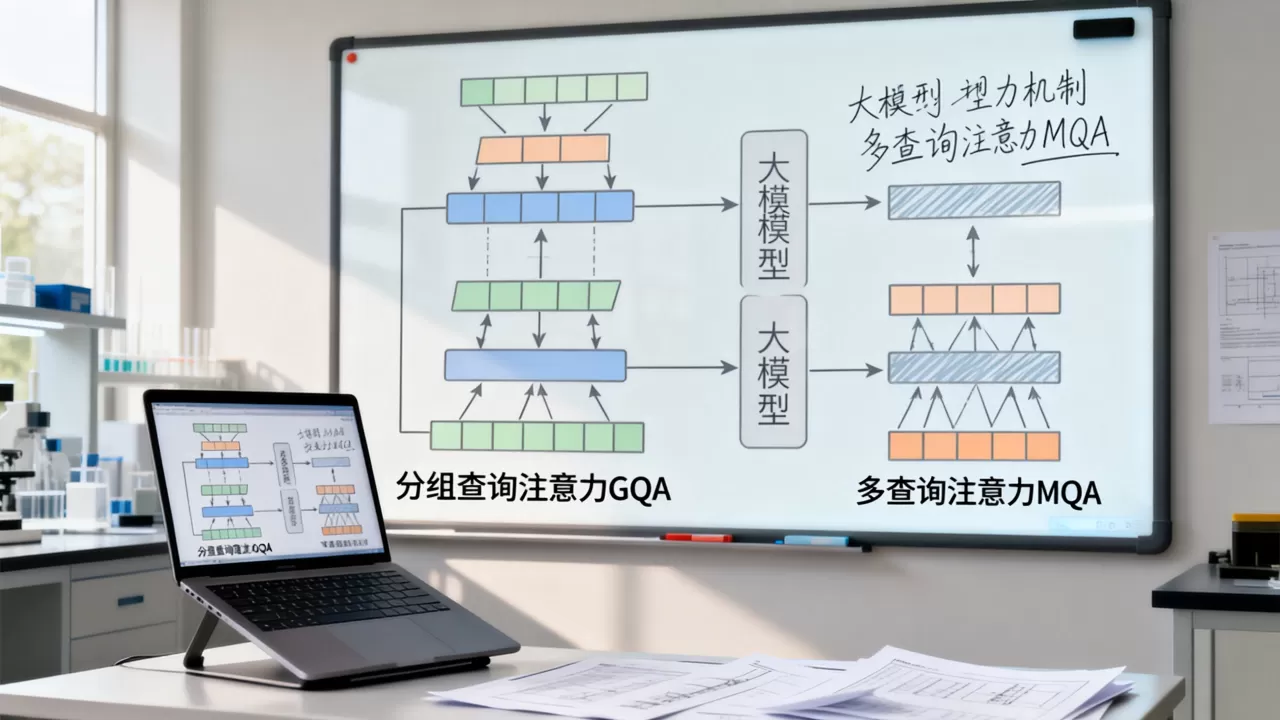
- 分组查询注意力(GQA):这是折中方案,它将32个查询头分成若干组,每组共享一个键头和值头,如果分成8组,那么就有8个键头和8个值头,每个键值头服务于4个查询头。
共享机制的具体运作方式
在GQA架构中,查询头被划分为G组,对于每一组内的查询头,它们使用相同的键矩阵和值矩阵进行计算,这意味着在推理阶段,模型只需要存储G份键值对,而不是H份(H为总查询头数)。
这种设计带来的直接好处是显存占用的线性降低,据统计,GQA可以将KV Cache的内存占用降低到MHA的1/G,如果G=8,内存占用仅为MHA的1/8,由于查询头之间仍然保持了一定的独立性,模型能够保留大部分MHA的表达能力,避免了MQA那种因过度共享导致的性能崩塌。
GQA在实际应用中的优势分析
为什么越来越多的开源大模型开始采用GQA?这主要得益于它在性能、速度和成本之间的出色平衡。
推理速度的显著提升
在自回归生成任务中,模型需要逐个生成token,每一步都需要计算当前token与之前所有历史token的注意力权重,由于GQA减少了需要读取和计算的KV Cache数据量,内存带宽成为了瓶颈的缓解点。
- 降低内存带宽压力:KV Cache通常占用大量显存,读取这些数据的速度往往慢于计算速度,GQA通过减少数据量,让模型更快地获取所需信息。
- 提高吞吐量:在相同的硬件配置下,支持GQA的模型能够以更高的每秒令牌数(TPS)运行,这意味着用户可以在更短的时间内获得回答,或者在同一台服务器上部署更多的并发实例。
显存占用的大幅缩减
对于部署在消费级显卡或边缘设备上的模型来说,显存是稀缺资源,MQA虽然省内存,但效果差;MHA效果好,但跑不动,GQA则让中等规模的显卡也能运行较大的模型。
在运行70亿参数(7B)的模型时,使用GQA可以将显存占用降低约50%-80%(取决于分组数量),这使得在单张RTX 3090或4090上运行更复杂的指令微调模型成为可能。
精度与效率的完美平衡
行业共识认为,GQA在大多数自然语言处理任务中,其性能损失微乎其微,通常在1%以内,甚至在某些特定任务上优于MQA,对于代码生成、数学推理等需要高精度捕捉上下文的任务,GQA的表现远优于MQA,接近MHA的水平。
如何选择合适的GQA分组策略
在实际部署中,并不是分组越多越好,也不是越少越好,选择合适的分组数G是一个需要权衡的过程。
评估指标与权衡
- 分组数G越小:越接近MQA,显存节省越多,推理速度越快,但模型精度损失风险越大。
- 分组数G越大:越接近MHA,模型精度越高,表达能力越强,但显存节省效果减弱。
实操建议
- 基准测试:在目标数据集上进行小规模测试,选取不同的G值(如G=1, 4, 8, 16),观察 perplexity(困惑度)和生成质量的变化。
- 硬件约束:根据可用显存大小确定最大允许的KV Cache体积,如果显存紧张,优先选择较小的G值;如果追求极致精度且显存充足,可选择较大的G值。
- 任务类型:对于创意写作、闲聊等对精度要求不高的场景,可以使用较小的G值以换取速度;对于代码生成、法律分析等严谨场景,建议使用较大的G值或接近MHA的配置。
GQA与其他优化技术的对比
除了GQA,市场上还有其他提升LLM效率的技术,如量化(Quantization)和稀疏注意力(Sparse Attention)。
GQA与量化的关系
GQA和量化是正交的技术,可以叠加使用,量化通过降低权重和激活值的精度(如从FP16降到INT8或INT4)来减少模型大小和计算量;GQA通过减少KV Cache来减少推理时的内存带宽压力。
- 叠加效果:同时使用GQA和INT4量化,可以在极低显存下实现极高的推理速度,在边缘设备上部署大模型时,这种组合几乎是标配。
- 适用场景:量化主要影响模型存储和计算精度,GQA主要影响推理过程中的内存访问,两者互补,共同解决“大模型跑不动”的问题。
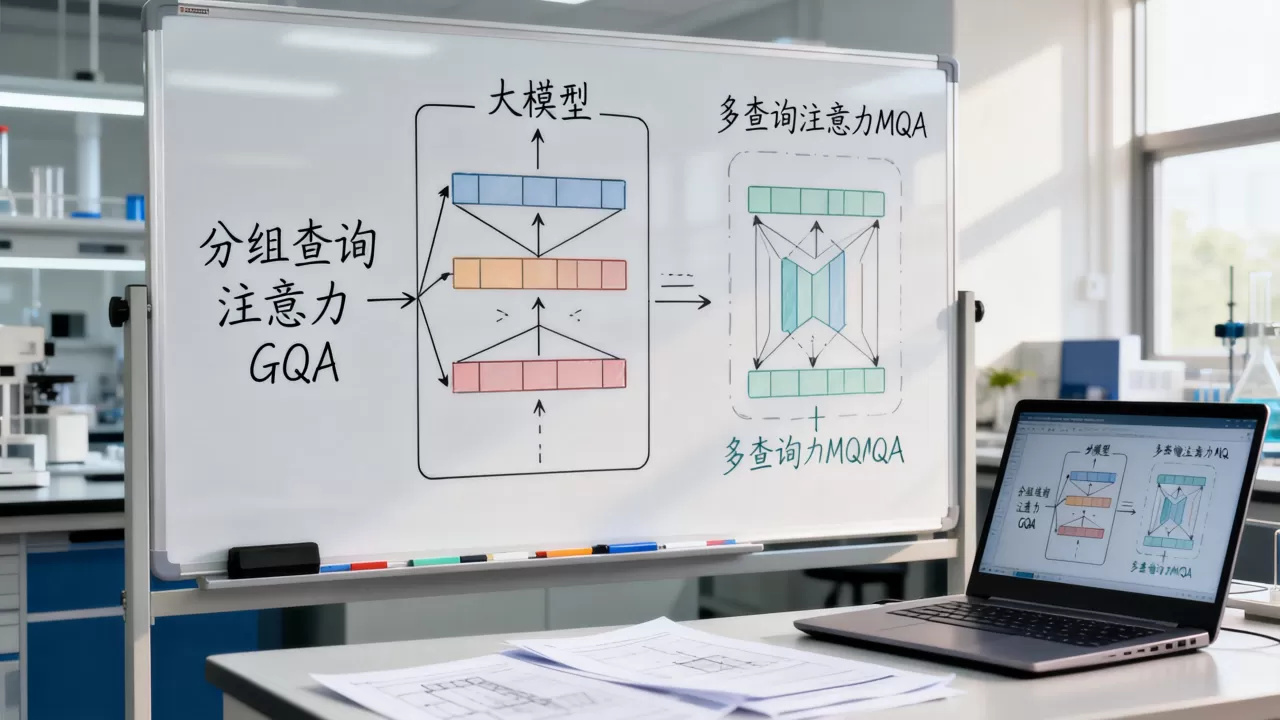
GQA与MQA的适用场景差异
虽然MQA也能节省显存,但其精度损失在长文本生成中尤为明显,GQA则在长文本场景下表现出更强的稳定性,除非显存极度受限且对精度要求极低,否则GQA是更通用的选择。
常见问题解答(GQA是什么)
GQA和MQA有什么区别?
GQA允许多个查询头共享一组键值头,而MQA是所有查询头共享唯一的一组键值头,GQA在显存节省和模型精度之间取得了更好的平衡,精度损失远小于MQA,是目前主流大模型的首选优化方案。
GQA会影响模型训练速度吗?
GQA主要优化的是推理阶段的内存访问和KV Cache存储,在训练阶段,由于需要计算梯度,键值头的共享结构对训练速度的提升不如推理阶段显著,但依然能减少内存占用,允许更大的批次大小(Batch Size),从而间接提升训练效率。
GQA适合所有类型的大模型吗?
GQA主要适用于基于Transformer架构的大型语言模型,对于编码器-解码器架构(如T5)或纯编码器模型(如BERT),其注意力机制与自回归生成模型不同,GQA的应用场景有限,对于参数量极小(如1B以下)的模型,其内存压力不大,采用GQA的收益不明显,反而可能增加实现复杂度。
分组查询注意力(GQA)并非简单的技术堆砌,而是针对大模型推理瓶颈的精准打击,它通过科学的分组共享机制,在几乎不牺牲精度的前提下,大幅降低了显存占用并提升了推理速度,随着模型规模的持续扩大,GQA已成为构建高效、低成本大模型应用的基础设施之一,对于开发者而言,理解和合理配置GQA参数,是优化模型部署性能的关键一步。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/412212.html