IT运维管理专家不是某个职称证书,而是能把被动救火变成主动预防、能用数据说话替代经验拍板、能在故障发生前就把它摁灭的运维能力体系。当企业在数字化转型里走深,运维的复杂度早就超过了一个人、一套脚本能覆盖的边界,本文直接拆解运维管理专家的核心能力模型、工具选型逻辑、落地实操路径和成本预期,帮你把这件事看清楚。
IT运维管理专家到底解决什么问题
很多团队对运维的理解还停留在“服务器不宕机就行”,但今天业务系统跑在混合云上,中间件、容器、数据库、网络链路层层叠叠,任何一层的抖动都可能让用户体验断崖式下跌。
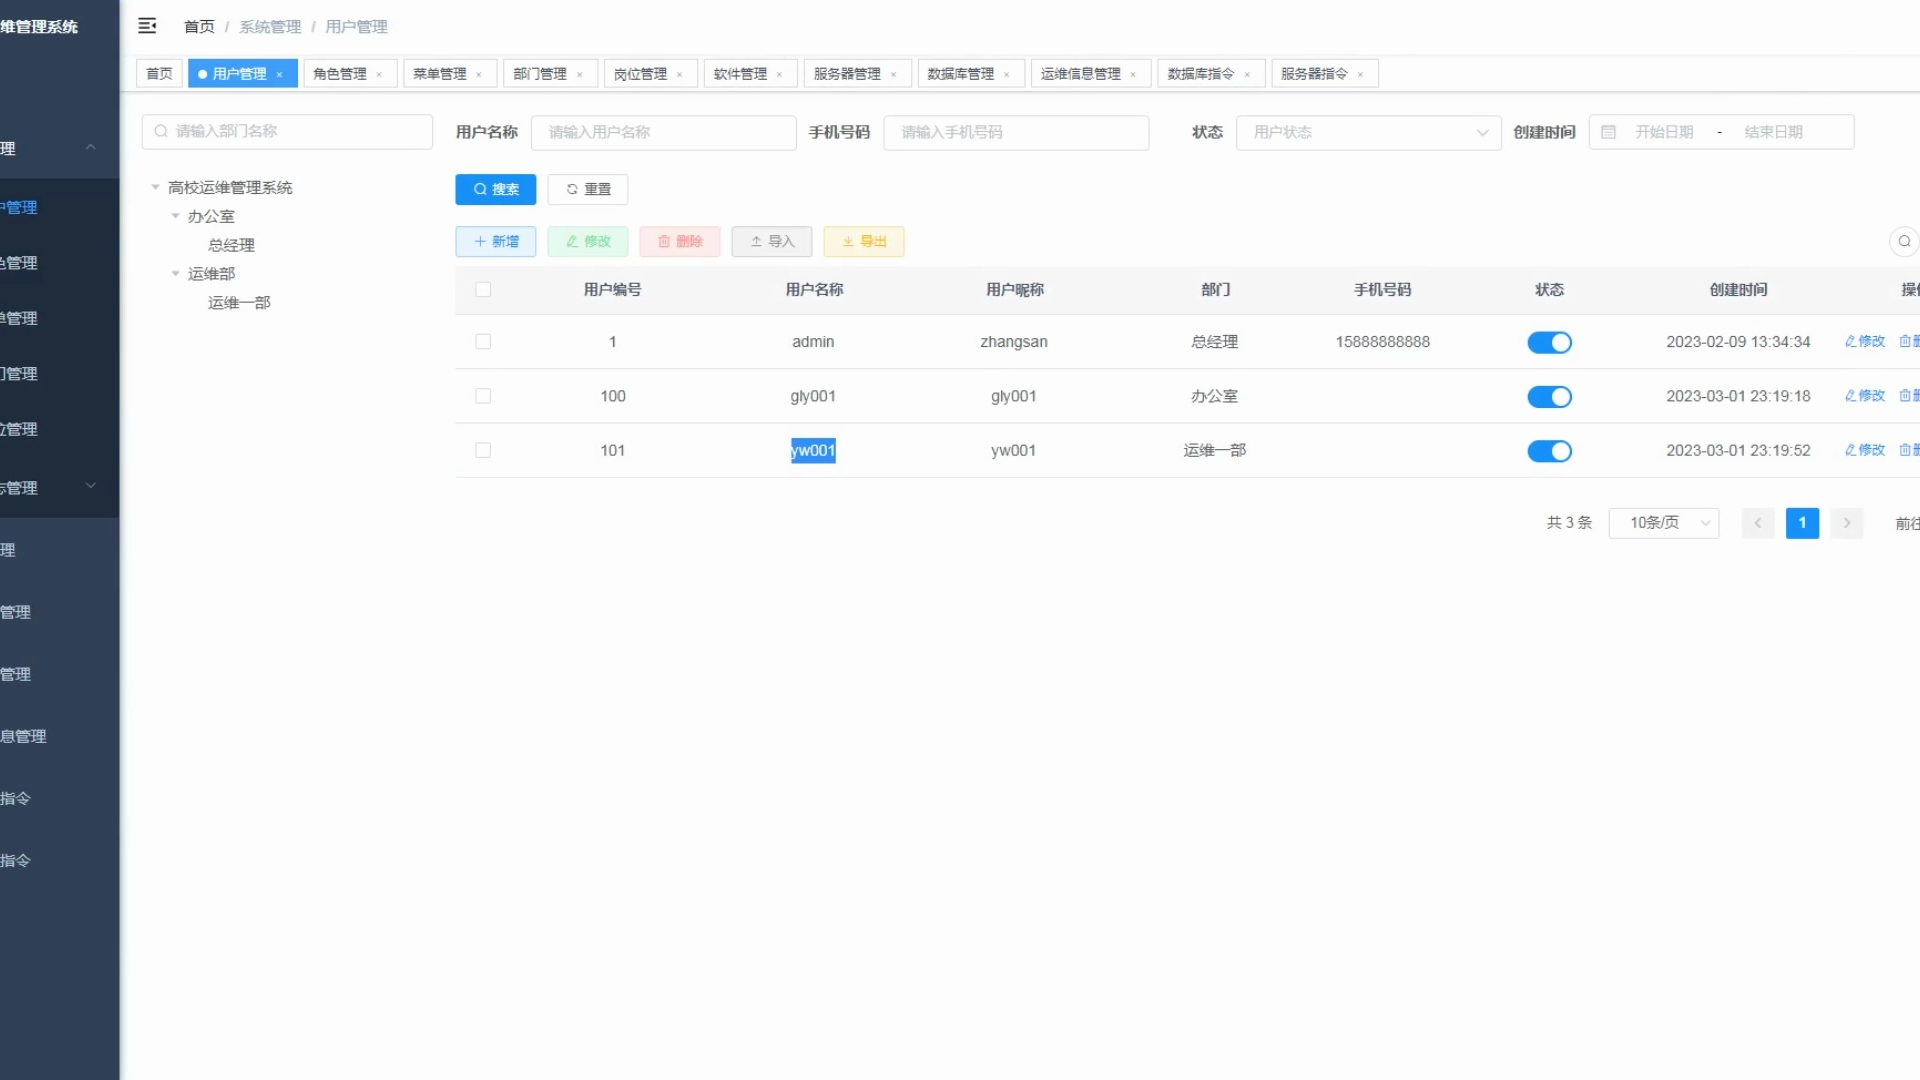
运维管理专家的核心价值,是把运维从成本中心推向价值中心,具体体现在三个层面:
- 故障响应层面:从“用户投诉才知道出问题”变成“监控告警先于用户发现”。
- 资源效率层面:从“为了保险拼命加资源”变成“按业务实际负载弹性伸缩”。
- 流程规范层面:从“口头交接、个人经验垄断”变成“标准化作业、知识库沉淀”。
业内专家指出,一个成熟运维管理体系的标志是:故障平均恢复时间(MTTR)下降50%以上,同时运维人员的工作重心从重复操作转向效能优化,这不是某一个工具能做到的,而是人、流程、工具三者咬合的结果。
运维管理平台怎么选:别先看功能,先看适配度
这是百度上被问得最多的问题之一,市面上号称“一体化运维管理平台”的产品少说几十款,但选错比不选更痛苦。
先梳理你自己的现状
- 设备规模:50台以内和5000台以上,对平台的压力完全不同。
- 技术栈分布:是纯物理机,还是虚拟化+容器混合架构。
- 团队人力:有没有专职的运维开发,决定了你是选开箱即用型还是可编程型。
- 预算区间:这直接框定了可选范围。
再看平台的关键能力
| 能力维度 | 核心要求 | 验证方式 |
|---|---|---|
| 监控采集 | 支持Agentless和Agent两种模式,覆盖SNMP、IPMI、SSH等协议 | 拉测试环境实测 |
| 告警收敛 | 能否基于时间窗口做告警合并和抑制 | 模拟批量故障看告警数量 |
| 自动化编排 | 脚本执行是否支持批量、分批、灰度 | 实际操作一次发布流程 |
| 可视化 | 拓扑图是自动发现还是手动绘制 | 看演示时当场刷新 |
| 开放性 | API文档是否完整,是否支持Webhook | 让厂商提供接口清单 |
行业共识认为:能匹配你现有流程的平台,比功能堆砌更多的平台,长期价值高出数倍
,你需要的不是最强的工具,而是最合脚的那双鞋。
常见的选型陷阱
- 被炫酷的大屏展示吸引,忽略了底层数据采集的准确性。
- 厂商演示用的环境网络极简,你的生产环境却是跨地域专线组网。
- 只关注监控,忽略了CMDB配置管理这个地基。
IT运维管理方案怎么落地:从巡检开始就不一样
很多团队买了平台,用了一周就搁置了,原因很简单:平台是一回事,用起来是另一回事,落地要从最小闭环开始。
第一步:标准化日常巡检
把巡检从“登服务器看一眼负载”升级为结构化动作:
- 每周一上午10点自动执行全量资产健康检查。
- 检查项覆盖CPU、内存、磁盘I/O、网络丢包率、关键进程状态。
- 结果自动生成报告并推送到钉钉/企微群。
- 异常项自动触发工单,责任到人。
实际命令层面,Linux主机巡检至少要看:
top  # 看负载和CPU占用
free -h  # 看内存余量
df -hT  # 看磁盘空间
iostat -x 1 3  # 看磁盘I/O瓶颈
sar -n DEV 1 3  # 看网卡流量
把这些命令封装成脚本,挂到运维平台的定时任务里,比人工登录一台台敲强一个量级。
第二步:建立告警分级响应机制
不是所有告警都要立刻处理,否则运维人员会被噪音淹没,按业务影响程度分四级:
- P0级:核心业务不可用,触发电话通知+短信+IM推送,10分钟内响应。
- P1级:主要功能受损但有降级方案,15分钟内响应。
- P2级:部分非核心模块异常,30分钟内处理。
- P3级:告警信息记录,白天统一处置。
这样做的好处是,运维人员的注意力分配从“平均用力”变成“重点突破”。
第三步:用数据复盘替代凭感觉改进
每月输出运维月报,里面必须包含:
- 告警总数、TOP10告警来源、重复告警占比。
- 故障次数、MTTR、MTBF(平均无故障时间)。
- 容量趋势预测,比如磁盘使用率未来30天的增长曲线。
当这些数据连续看三个月,你会清楚地知道该优化哪里。
IT运维管理工具哪个好用:分场景说体验
不谈场景推荐工具都是耍流氓,这里按团队规模和需求分类说体验。
轻量级团队
- 监控用Zabbix或Prometheus+Grafana,前者适合传统架构,后者在云原生场景更灵活。
- 日志用ELK或者轻量的Loki,看团队对ES的维护能力。
- 自动化用Ansible,无Agent设计,上手成本低。
这个组合的特点是开源、免费、社区活跃,但需要团队有一定的技术储备自行维护。
中大型企业
商业平台的体验更完整,比如华为ManageOne、新华三U-Center,以及专注监控领域的智象运维,它们提供了更完善的IT运维管理方案,包括:
- 内置的ITIL流程引擎(事件、问题、变更、发布)。
- 云资源统一纳管和配额管理。
- 可视化的服务目录和多租户隔离。
价格上,商业平台通常按“管理节点数+模块”收费,规模不同差异很大,据行业反馈,百台服务器规模的全模块部署,年预算通常在二十万到五十万之间,具体得跟厂商按需谈。
IT运维管理哪家好”的真相
坦白说,没有哪个工具是全能的,好的运维管理专家,手里是组合拳,监控用A、日志用B、自动化用C,然后用一个聚合层把它们串起来。
自动化运维脚本:把重复劳动还给机器
这是利润最高、见效最快的模块,不用买额外软件,就能让团队解脱一部分重复操作。
一个实用的告警自愈脚本模板
#!/bin/bash
# 检查Nginx进程,挂掉则自动重启并告警
SERVICE=nginx
if pgrep -x "$SERVICE" >/dev/null; then
    echo "$(date) $SERVICE is running."
else
    systemctl restart $SERVICE && echo "$(date) $SERVICE restarted." >> /var/log/nginx_auto.log
    curl -X POST "https://qyapi.weixin.qq.com/cgi-bin/webhook/send?key=YOUR_KEY"
         -H "Content-Type: application/json"
         -d "{"msgtype":"text","text":{"content":"警告: $SERVICE 已自动重启"}}"
fi
这类脚本的价值在于,把常规故障处理时间从5分钟人工判断压缩到30秒自动恢复。
批量执行命令更高效
给100台服务器做安全加固,逐台操作显然不现实,用Ansible一条命令搞定:
# playbook.yml
- hosts: all
  tasks:
    - name: disable root ssh login
      lineinfile:
        path: /etc/ssh/sshd_config
        regexp: '^PermitRootLogin'
        line: 'PermitRootLogin no'
      notify: restart sshd
配合跳板机和堡垒机的审计功能,既能提升效率,又能保留操作留痕,满足合规要求。
“运维管理多少钱”一类的成本问题
很多企业第一个问的就是价格,但这件事需要换个角度算账,看得是投入产出比(ROI)和架构扁平化程度。
自研 vs 采购
- 自研监控平台,消耗的人力成本按两年折算,通常是几十万起步,还不算后续迭代维护。
- 采购商业平台,首年投入涵盖软件授权、实施服务、硬件资源,费用范围跨度很大。
- 开源方案看起来零成本,但隐含的人力维护成本很大
,且告警准确性依赖于长期调优。
对于多数企业,商业平台+少量自研脚本是性价比最高的一条路,平台保证稳定底座,脚本补充个性化需求。
成本优化的一个关键点
告警准确率直接决定人力投入,一个管理数千节点的平台,如果的告警准确率低、重复告警多,运维人员会被拖垮,反过来,告警收敛做得好,一个人管理一个大集群不是没可能。
IT运维管理专家怎么养成:给运维工程师的成长建议
工具能买,人才难求,从普通运维到运维管理专家,往往要看思维上的转变和沉淀的厚度。
技术纵深
- 协议底层:TCP/IP和HTTP不能只停留在会用的层面,要理解握手、重传、队头阻塞等机制。
- Linux内核:进程调度、内存回收、文件系统原理,这些是排查疑难杂症的底气。
- 数据库:MySQL主从复制原理、慢查询分析、锁机制,不能被DBA的一句“这不归你管”挡住。
平台能力
- 至少精通一套自动化配置管理工具(Ansible/SaltStack)。
- 至少用过一套商用或开源的监控告警平台。
- 理解CI/CD流水线,知道代码从提交到上线的完整路径。
软技能
- 沟通翻译能力:能把技术故障的影响用业务语言告诉老板。
- 文档习惯:每一次故障处理过程都是资产,写进知识库,下次同类问题直接按照预案来。
- 成本敏感度:涉及云资源选型时,能给出不同方案的计费对比。
写在最后
IT运维管理专家不是买一个昂贵平台就自动实现的,它需要你沉下心把巡检、告警、响应、复盘这套循环跑起来。好的运维,核心在于“可靠”二字让业务跑得稳,让团队睡得着。 从今天开始,把第一个自动化巡检脚本写出来,你就在路上了。
关于运维管理的常见疑问
问:运维管理平台怎么选,必须买贵的吗?
选型看规模和场景,预算少可以先用开源组合锻炼团队,等节点规模上来了再引入商业平台,贵的平台不一定好用,但如果流程规范、响应及时的要求很高,商业平台的设计更符合预期。
问:IT运维管理方案里,监控和自动化哪个优先落地?
监控优先做,自动化其次,没有可靠的监控数据,自动化就是盲人骑瞎马,先让监控把家底盘清楚,再逐步把高频重复的操作自动化。
问:运维管理工具导入时,团队抵触怎么办?
多数情况下抵触源于对未知的恐惧,解决办法是一步步来,先选一个痛点小、见效快的场景,比如日志集中查看,让团队尝到甜头,后面再推广其他模块就顺理成章了。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/578943.html