

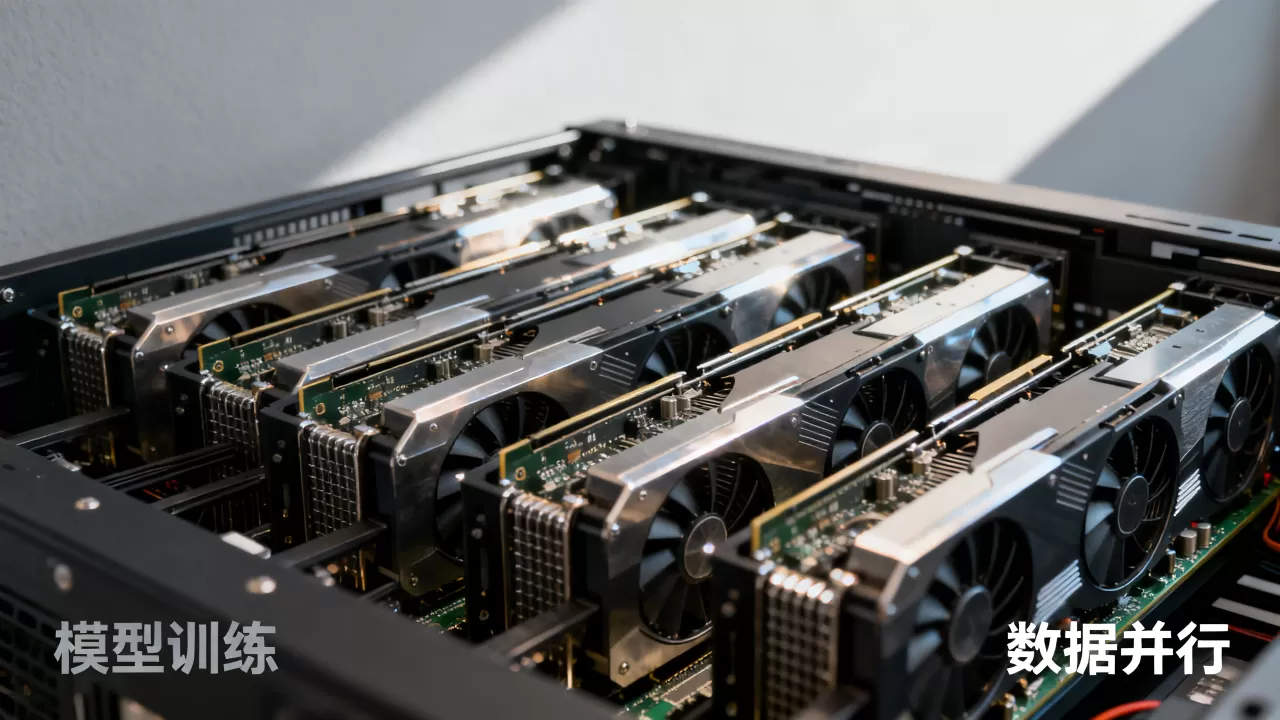
数据并行(Data Parallel)是将模型副本分发到多个设备上,通过同步梯度来加速训练的核心技术,其本质是“用空间换时间”,让多台显卡共同分担计算负载。
在大模型训练领域,显存瓶颈和计算耗时是两大拦路虎,当模型参数量达到千亿级别时,单张显卡不仅装不下模型,算得也慢,数据并行技术应运而生,它不改变模型结构,而是通过复制模型权重并分散数据批次,实现了训练效率的质变。
数据并行原理深度拆解:从单机到集群的跨越
理解数据并行,首先要明白它解决的是什么问题,在单机训练中,我们一次喂给显卡一批数据(Batch),显卡算完梯度后更新权重,但在分布式环境下,如果只有一张卡,显存很快就会被模型权重、优化器状态和激活值占满。
核心机制:模型复制与数据分片
数据并行的逻辑非常直观,业内专家指出,其核心在于“复制”与“分发”。
模型权重复制
每个参与训练的GPU都会持有完整的模型副本,这意味着,如果有4张显卡,内存中就会存在4份相同的模型参数,这不是浪费,而是为了并行处理不同数据。
数据批次划分
训练数据被切分成若干个小批次(Micro-batches),假设全局Batch Size是128,使用4张卡,每张卡实际处理32条数据,每张卡独立前向传播计算损失,再独立反向传播计算梯度。
梯度同步与参数更新
这是最关键的一步,每张卡算完梯度后,不能直接更新自己的权重,而是通过All-Reduce操作,将所有卡的梯度求平均,平均后的梯度再广播回所有卡,各卡用这个平均梯度更新自己的模型副本,这样,所有卡上的模型始终保持一致。
数据并行与其他并行策略的对比分析
在大模型训练架构中,数据并行并非孤立存在,它通常与模型并行、流水线并行配合使用,明确它们的区别,有助于构建高效的训练集群。
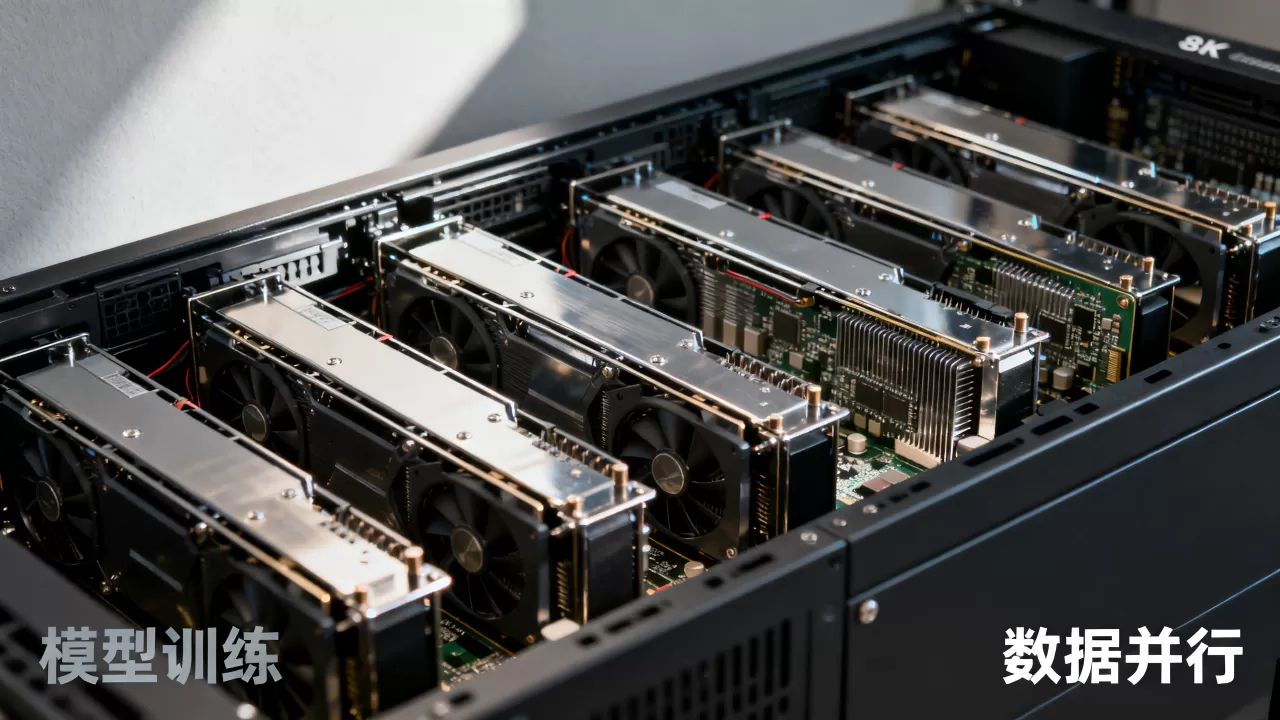
数据并行 vs 模型并行:分工不同
模型并行(Model Parallel)是为了解决“模型太大,单卡装不下”的问题,它将模型的不同层或不同部分拆分到不同显卡上,而数据并行解决的是“训练太慢”的问题。
- 显存占用:数据并行中,每张卡都存完整模型,显存压力随模型增大线性增加;模型并行中,显存压力被分摊,单卡压力减小。
- 通信开销:数据并行主要通信梯度,频率高但数据量相对小;模型并行主要通信激活值,频率低但数据量巨大。
- 适用场景:中小规模模型首选数据并行;超大规模模型(如万亿参数)必须结合模型并行。
数据并行 vs 流水线并行:时间维度的优化
流水线并行(Pipeline Parallelism)是将模型像工厂流水线一样,不同层由不同卡负责,数据并行则是横向扩展,多组流水线并行组同时工作。
- 计算效率:数据并行利用率高,因为每张卡都在全量计算;流水线并行存在气泡(Bubble),即某些卡空闲等待。
- 扩展性:数据并行扩展性较好,受限于通信带宽;流水线并行受限于层数划分和气泡大小。
主流数据并行实现方案:从DDP到ZeRO
随着模型规模爆炸,传统的数据并行面临显存瓶颈,催生了多种优化方案。
分布式数据并行(DDP)
DDP是PyTorch等框架的基础实现,它通过NCCL库实现高效的梯度同步。
- 优点:实现简单,兼容性好,适合中小模型。
- 缺点:每张卡都存储优化器状态(Optimizer States),对于Adam优化器,优化器状态占用显存是模型权重的2-3倍,导致显存利用率低。
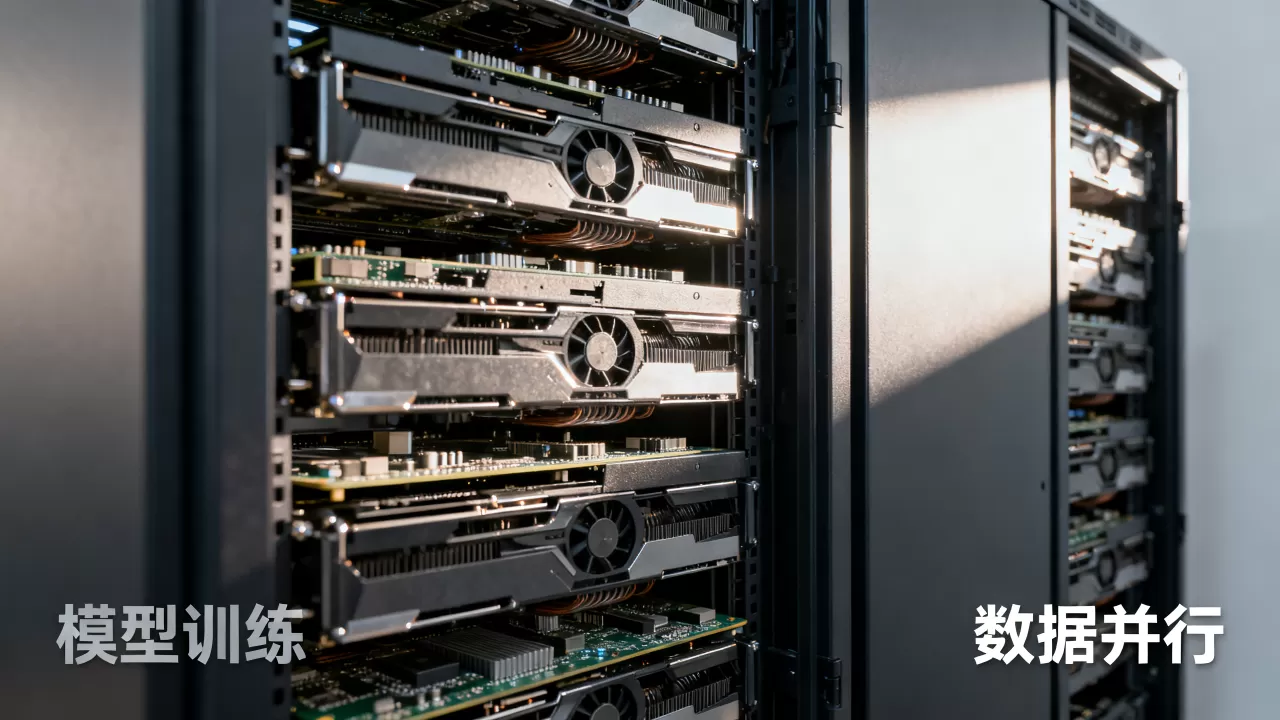
ZeRO(Zero Redundancy Optimizer)
由微软提出,旨在解决DDP显存冗余问题,ZeRO将优化器状态、梯度和参数分片存储,不同卡存储不同部分的数据。
ZeRO-1:优化器状态分片
将优化器状态分散存储,4张卡,每张卡只存1/4的优化器状态,显存节省约3倍。
ZeRO-2:梯度分片
在ZeRO-1基础上,将梯度也分片存储,进一步降低显存占用。
ZeRO-3:全部分片
将模型参数、梯度、优化器状态全部分片,这是目前大模型训练的主流方案,如Megatron-LM和DeepSpeed均支持。
数据并行实战中的关键挑战与优化
在实际部署数据并行训练时,通信瓶颈和显存管理是两大痛点。
通信带宽成为新瓶颈
随着模型参数增加,梯度同步的数据量急剧上升,在万卡集群中,通信时间可能超过计算时间。
- 优化策略:
- 梯度累积:减少同步频率,每N个Batch同步一次梯度。
- 混合精度训练:使用FP16或BF16格式传输梯度,减少数据量。
- 拓扑感知通信:根据服务器内部NVLink和PCIe拓扑,优化通信路径,减少跨交换机通信。
显存碎片化问题
大模型训练中,激活值(Activations)占用大量显存,且大小动态变化,易导致碎片化。
- 优化策略:
- 梯度检查点(Gradient Checkpointing):不保存中间激活值,反向传播时重新计算,以计算换显存。
- 动态内存分配:使用如PyTorch的
torch.cuda.amp自动混合精度,动态分配显存。
数据并行在2026年的演进趋势
站在2026年的视角回顾,数据并行技术已不再是简单的“复制+同步”,而是与硬件架构深度融合。
软硬件协同设计
新一代AI芯片(如NVIDIA H200/B200系列及国产替代方案)内置了高速互联总线,专门优化All-Reduce通信,软件框架如DeepSpeed、Megatron-LM与硬件深度耦合,实现了通信与计算的完全重叠。
异构数据并行
数据并行将不再局限于同构GPU集群,CPU、NPU、FPGA等异构设备将参与训练,数据并行策略需适应不同设备的计算速度和内存带宽差异。
自动化并行策略搜索
手动配置数据并行、模型并行、流水线并行的比例极其复杂,AI自动搜索算法(AutoML)将根据模型大小、集群规模、网络拓扑,自动推荐最优的并行策略组合。
FAQ:数据并行常见问题解答
数据并行训练时,为什么显存占用比单机高?
因为每张卡都存储了完整的模型权重、优化器状态和激活值,在DDP模式下,显存占用是单卡的N倍(N为卡数),若使用ZeRO技术,显存占用可显著降低,接近单机水平。
数据并行适合小模型训练吗?
适合,但需权衡通信开销,对于参数量较小的模型,通信延迟可能成为瓶颈,导致多卡训练速度不如单机,通常建议参数量超过数十亿,或训练数据量极大时,再引入数据并行。
如何判断数据并行是否达到最佳性能?
观察GPU利用率(Utilization)和通信时间占比,若GPU利用率低于80%,可能存在通信瓶颈或数据加载瓶颈,使用Nsight Systems等工具分析,若通信时间占比超过30%,需优化通信策略或增加GPU数量。
数据并行是大模型训练的基石,它通过简单的复制逻辑,解决了算力扩展的核心难题,从DDP到ZeRO,技术的演进始终围绕“显存”与“通信”两大痛点展开,对于开发者而言,理解其原理并合理选择并行策略,是构建高效AI训练集群的关键。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/411837.html


评论列表(1条)
卧槽这不就是我们毕设组上周崩掉的训练流程嘛……三张3090卡同步梯度时卡成PPT,老板还问“怎么不并行加速?”——数据并