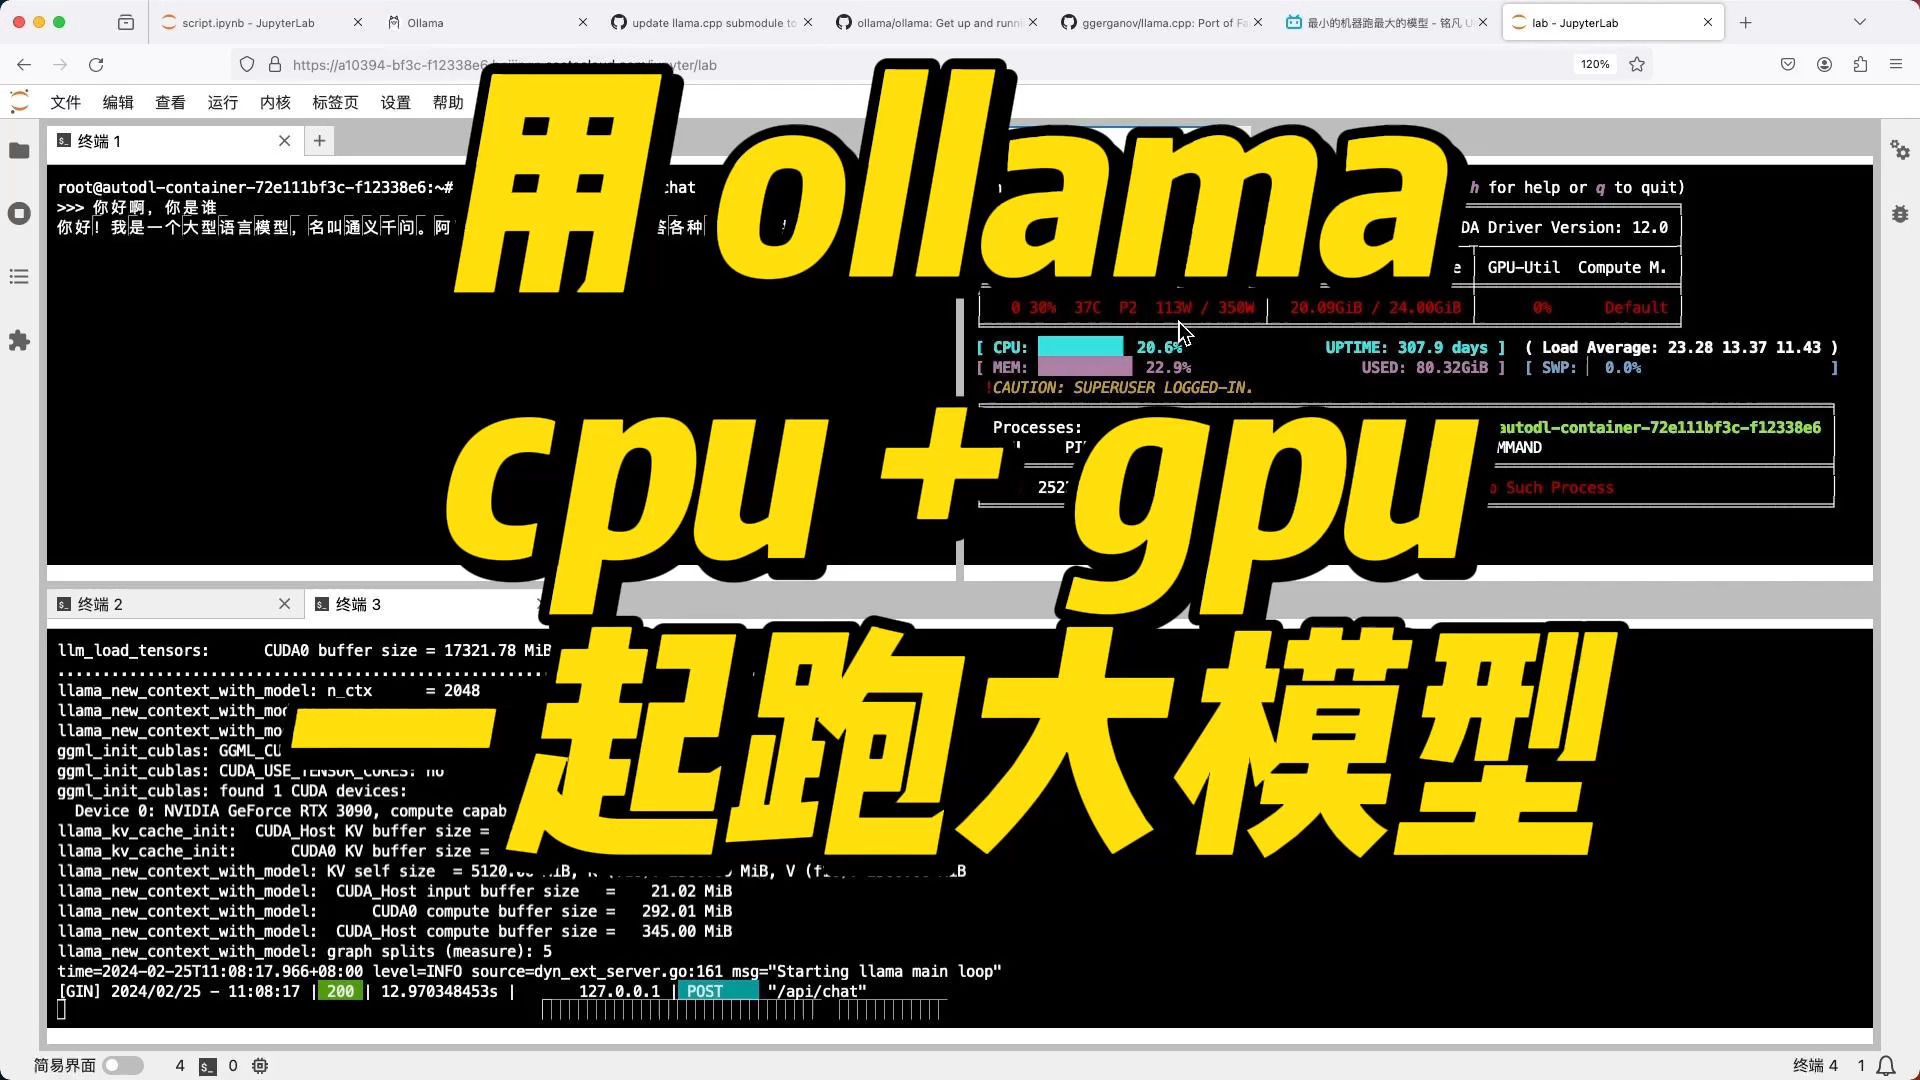
大模型推理完全可以用CPU跑,但在2026年的技术语境下,这更多是一种“能用”而非“好用”的妥协方案,适合低并发、小参数模型或边缘计算场景,若追求高吞吐和实时响应,GPU仍是不可替代的首选。
过去几年,随着大语言模型(LLM)从云端走向终端,算力瓶颈成为制约落地的最大障碍,很多人第一反应是“没显卡就别想了”,但事实并非如此绝对,CPU作为通用处理器,其架构特性决定了它在处理逻辑控制、内存管理以及非矩阵密集型任务上的独特优势,虽然它在纯矩阵乘法上的效率远不及GPU,但通过量化技术、稀疏化加速以及专用指令集优化,CPU跑大模型已经不再是天方夜谭,而是一种具备实际工程价值的备选路径。
CPU与大模型推理的性能边界在哪里
要理解CPU能否胜任,首先要看清它的性能天花板,业内专家指出,大模型推理的核心开销在于矩阵乘法运算,这正是GPU的强项,CPU拥有更大的缓存层级和更灵活的分支预测能力,这在某些特定场景下能弥补算力不足。
吞吐量与延迟的博弈
在评估推理性能时,我们通常关注两个核心指标:首字延迟(TTFT)和生成速度(TPS)。
- 首字延迟:CPU由于单核频率高,在处理提示词编码阶段往往表现不错,甚至优于部分中端GPU,这意味着用户发出指令后,看到第一个字的等待时间较短。
- 生成速度:一旦进入逐字生成阶段,GPU凭借数千个CUDA核心并行计算,优势呈指数级放大,CPU在此时的表现往往显得力不从心,每秒生成的字符数可能仅为GPU的十分之一甚至更低。
这种差异决定了应用场景的分野,如果你是在做一个离线批处理任务,比如每天夜间分析一万份合同,对实时性要求不高,CPU完全能够胜任,但如果是构建一个实时对话助手,要求毫秒级响应,CPU就会成为明显的瓶颈。
内存带宽的限制
大模型推理不仅是计算问题,更是内存问题,G
PU拥有极高的显存带宽(HBM),而CPU依赖系统内存(DDR),据统计,多数情况下,内存带宽不足会导致CPU在加载大型模型参数时出现“喂不饱”计算单元的情况,运行一个70B参数的模型,即便CPU算力足够,内存读写的延迟也会严重拖慢整体流程,这也是为什么在同等内存容量下,GPU方案通常更受青睐的原因。
什么情况下你应该选择CPU推理
既然GPU性能更强,为什么还要讨论CPU?因为成本和部署灵活性是现实工程中必须考虑的因素,对于许多中小企业和个人开发者来说,购买昂贵的GPU集群并不现实。
边缘计算与IoT设备
在智能家居、工业网关或无人机等边缘设备上,GPU往往因为功耗过高、体积过大而被排除在外,这些设备通常搭载高性能ARM或x86 CPU,近年来,随着模型蒸馏和量化技术的成熟,将经过大幅压缩的LLM部署在边缘CPU上成为可能。
具体而言,使用INT4或INT8量化技术,可以将模型体积压缩至原来的四分之一甚至更小,同时保持较高的精度,在这种场景下,CPU推理不仅可行,而且能效比极高,在树莓派4或某些工业级工控机上运行7B参数的小模型,实现本地化的语音指令识别,无需联网即可保护隐私。
私有化部署的成本控制
对于金融、医疗等对数据隐私要求极高的行业,私有化部署是刚需,建立完整的GPU服务器集群成本高昂,许多企业发现,利用现有的服务器CPU资源,通过容器化技术部署轻量级模型,足以满足内部知识库检索、文档摘要生成等低频需求。
据工信部相关数据显示,相当一部分企业正在探索“CPU为主,GPU为辅”的混合架构,在业务低谷期,利用闲置CPU资源处理推理任务;在高峰期,再调度GPU资源,这种弹性架构既降低了硬件投入,又提高了资源利用率。
如何在实际项目中优化CPU推理性能
如果你决定使用CPU跑大模型,不能指望开箱即用,必须通过一系列技术手段来压榨硬件潜力,以下是经过验证的实操路径。
模型量化与格式转换
不要直接使用原始的FP16或BF16模型,量化是提升CPU推理速度的关键。
- 选择量化格式:推荐使用GGUF格式,这是专为CPU推理优化的模型格式,支持多种量化级别(如Q4_K_M, Q5_K_M等)。
- 使用转换工具:利用llama.cpp等开源工具,将Hugging Face上的原始模型转换为GGUF格式,这一步可以显著减少内存占用并提升缓存命中率。
推理引擎的选择
不同的推理引擎对CPU的优化程度差异巨大。
- llama.cpp:目前最流行的CPU推理框架,支持AVX2、AVX-512等指令集加速,对Intel和AMD CPU都有良好支持。
- Ollama:基于llama.cpp封装,提供了更友好的用户界面和API,适合快速原型开发。
- ONNX Runtime:如果你使用的是Transformer架构的其他变体,ONNX Runtime提供了跨平台的优化支持,能够自动选择最优的计算内核。
系统级调优
除了软件层面,系统配置也至关重要。
内存管理
确保系统内存带宽没有被其他进程占用,在Linux系统中,可以使用numactl命令将模型绑定到特定的CPU核心和内存节点,减少跨NUMA节点的内存访问延迟。
线程并行
合理设置推理线程数,线程数不应超过CPU的物理核心数,以避免上下文切换带来的开销,对于支持超线程的CPU,建议优先使用物理核心。
常见误区与避坑指南
在使用CPU进行大模型推理时,开发者容易陷入一些认知误区,导致体验极差。
CPU可以替代GPU进行所有训练和微调
这是最大的误解,虽然推理可以用CPU,但训练和微调几乎必须依赖GPU,训练过程涉及大量的反向传播和梯度计算,对并行计算能力要求极高,CPU进行训练不仅速度极慢,而且极易导致内存溢出,正确的做法是在云端GPU上完成微调,然后将模型量化后部署到本地CPU上。
模型越小越好
虽然小模型在CPU上运行更快,但过小会导致智能水平断崖式下跌,业内共识认为,对于通用对话任务,
7B参数是一个平衡点,低于这个规模,模型的理解能力和逻辑推理能力会显著不足;高于这个规模,CPU的推理速度可能无法满足实时交互需求。
忽略模型结构的影响
不同的模型架构对CPU的友好程度不同。Mistral和Llama 3等主流模型都有良好的CPU优化支持,而一些较新的、结构复杂的模型可能需要更多的自定义优化才能高效运行,在选择模型时,务必查看其是否提供GGUF格式或专门的CPU推理指南。
Q&A:大模型推理能用CPU跑吗常见疑问解答
大模型推理能用CPU跑吗?具体能跑多大的模型
CPU完全可以运行大模型推理,但受限于内存容量和带宽,通常建议运行参数规模在7B至14B之间的量化模型,如果使用高内存带宽的服务器级CPU和大量RAM,可以尝试运行30B至70B的模型,但生成速度会显著下降,可能仅为每秒几个字符,对于超过70B的模型,除非拥有极高性能的CPU集群,否则不建议在单台CPU机器上运行。
CPU推理和GPU推理的价格对比如何
从硬件采购成本来看,CPU推理的成本远低于GPU,一台配备64GB或128GB内存的高端CPU服务器,价格可能仅为入门级GPU服务器的三分之一甚至更低,从运营成本来看,CPU功耗通常低于GPU,长期运行电费更省,如果按每美元生成的Token数计算,GPU的效率优势依然巨大,对于低频、非实时的应用场景,CPU推理的性价比更高;对于高频、实时场景,GPU的综合成本效益更优。
如何在Linux系统下快速搭建CPU推理环境
搭建环境相对简单,推荐使用conda或docker隔离环境,首先安装llama.cpp,确保系统支持AVX2指令集,然后下载量化后的GGUF模型文件,使用命令行工具如ollama或llama-cli加载模型并启动服务,整个过程无需复杂的驱动配置,适合快速部署和测试。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/410237.html