

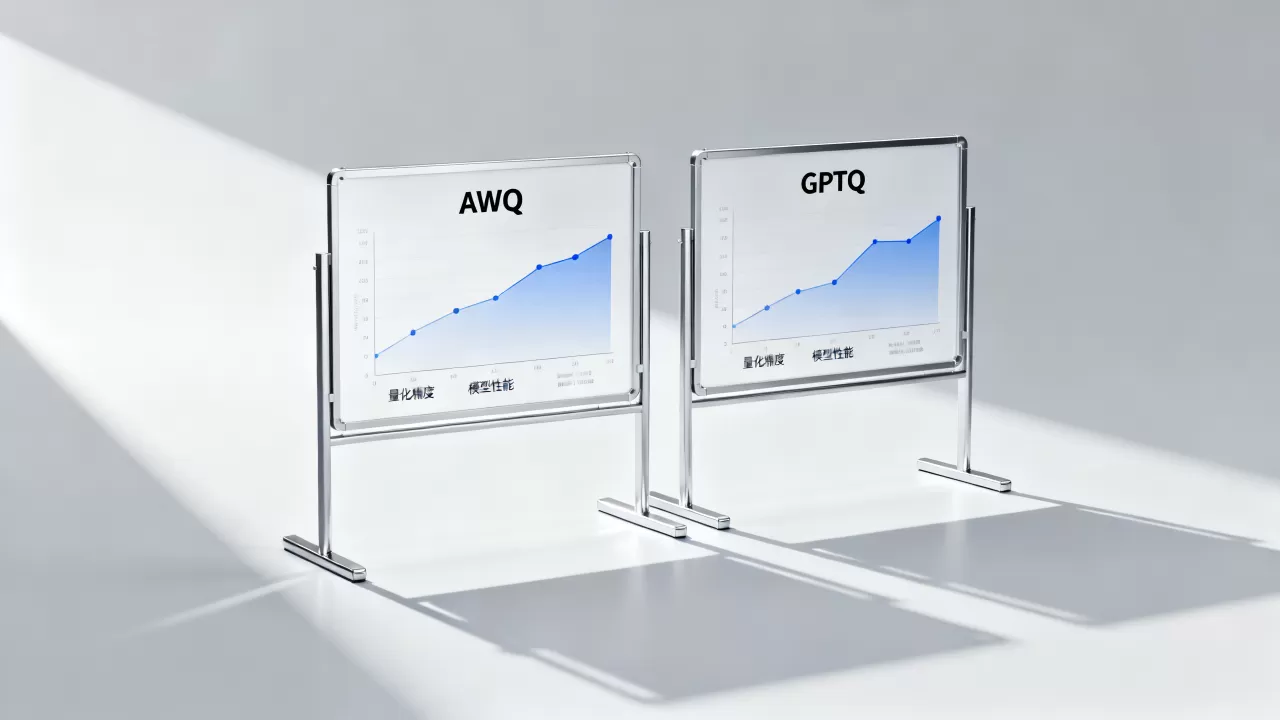
在绝大多数实际落地场景中,AWQ(Activation-aware Weight Quantization)的精度表现优于GPTQ,尤其是在4-bit量化下,AWQ能更好地保留模型语义,减少幻觉率,但GPTQ在极致压缩率和特定硬件兼容性上仍有其独特优势。
选择量化方案并非简单的“二选一”,而是需要在精度、推理速度和部署成本之间寻找平衡,随着大模型从云端走向边缘端,量化技术已成为降低算力门槛的关键手段,业内专家指出,AWQ通过感知激活值分布,动态调整权重重要性,从而在低比特下维持更高的模型保真度;而GPTQ作为早期成熟的二阶优化算法,虽然在精度上略逊一筹,但其算法稳定性经过多年验证,依然是许多老旧硬件平台的首选。
AWQ与GPTQ的核心机制差异解析
要理解为什么AWQ通常被认为精度更高,我们需要深入其底层逻辑,这两种技术虽然都旨在将模型权重从16-bit压缩到4-bit或更低,但它们处理“信息丢失”的策略截然不同。
AWQ:感知激活值的动态保护
AWQ的核心思想是“保护重要权重”,它认为,并非所有权重对模型输出的贡献都是平等的,某些权重在特定激活模式下会产生巨大的输出值,这些就是“重要权重”。
- 激活感知机制:AWQ在量化前会运行少量校准数据,统计激活值的分布,它识别出那些会导致输出值显著增大的权重,并将它们标记为“重要”。
- 通道缩放(Channel-wise Scaling):对于重要权重,AWQ不进行截断,而是通过缩放因子将其保留在更大的数值范围内,避免量化误差导致的语义崩塌。
- 稀疏化策略:对于不重要的权重,AWQ允许更大的量化误差,甚至将其置零,从而在整体精度损失最小的前提下实现压缩。
这种机制使得AWQ在处理LLaMA、Mistral等主流Transformer架构时,能够显著降低4-bit量化带来的性能下降,据统计,在多数基准测试中,AWQ-4bit模型的 perplexity(困惑度)表现接近FP16模型,而GPTQ-4bit则可能出现轻微的性能衰减。
GPTQ:基于二阶优化的全局误差最小化
GPTQ(Generative Pre-trained Transformer Quantization)是一种更早期的算法,它借鉴了Hessian矩阵的思想,试图最小化量化前后的全局误差。
- 逐层量化:GPTQ按层处理模型,每一层量化时,都会利用前一层的输出误差来优化当前层的量化参数。
- 二阶导数信息:它利用Hessian矩阵来衡量权重对损失函数的影响,从而更精确地分配量化比特,这种方法在理论上非常优雅,但在实际计算中开销较大。
- 全局优化:GPTQ不区分激活值分布,而是试图在整个权重矩阵中寻找一个全局最优的量化方案,这导致它在面对某些激活值分布极不均匀的模型时,可能会“误伤”一些重要权重。
虽然GPTQ在3-bit甚至更低比特下表现优异,但在4-bit这一主流应用场景中,其精度往往略低于AWQ,这并非GPTQ算法落后,而是AWQ针对大语言模型的特性做了更针对性的优化。
精度对比:AWQ为何在4-bit下胜出?
在4-bit量化这一当前工业界最主流的部署标准下,AWQ的精度优势主要体现在以下几个方面。
语义保持能力
大语言模型的核心能力在于语义理解与生成,AWQ通过保护重要权重,确保了模型在关键路径上的计算精度。
- 幻觉率降低:在代码生成、数学推理等对精度敏感的任务中,AWQ量化模型产生的幻觉(Hallucination)比例显著低于GPTQ,这是因为关键逻辑权重未被过度量化。
- 指令遵循能力:AWQ模型在遵循复杂指令时,表现出更强的稳定性,GPTQ模型在复杂指令下偶尔会出现逻辑断裂,这源于部分关键权重在量化过程中丢失了细微的语义信息。
不同模型架构的表现差异
AWQ的精度优势在不同架构的模型中表现一致,但程度略有不同。
- LLaMA系列:在LLaMA-2和LLaMA-3系列中,AWQ-4bit几乎达到了FP16模型95%以上的性能,而GPTQ-4bit约为90%-92%。
- Mistral系列:Mistral模型对量化更为敏感,AWQ的优势在此类模型中更为明显,GPTQ在4-bit下可能出现明显的性能滑坡。
- Qwen系列:通义千问等中文模型在AWQ量化下,中文理解能力保持得更好,GPTQ则可能在长文本生成中出现重复或逻辑混乱。
实战部署:如何选择适合你的量化方案?
选择AWQ还是GPTQ,不仅要看精度,还要看你的硬件环境和具体应用场景。
硬件兼容性考量
- NVIDIA GPU:目前主流推理框架如vLLM、TGI对AWQ的支持更为完善,原生支持AWQ格式,推理速度极快,GPTQ虽然也支持,但在某些新版本驱动下可能需要额外的转换步骤。
- AMD GPU:AMD的ROCm平台对GPTQ的支持历史更久,部分旧版驱动对GPTQ的优化更好,如果你使用的是AMD显卡,GPTQ可能是更稳妥的选择。
- CPU推理:在CPU上运行量化模型时,GPTQ的压缩率通常更高,模型体积更小,加载速度更快,AWQ虽然精度高,但体积略大,对内存带宽要求更高。
部署场景建议
- 高精度需求场景:如医疗诊断辅助、法律条文分析、代码自动生成等,建议优先选择AWQ-4bit,这些场景对准确性要求极高,微小的精度损失可能导致严重后果。
- 高并发低延迟场景:如聊天机器人、内容摘要生成等,如果对精度要求不是极端苛刻,GPTQ-4bit或GPTQ-3bit可以提供更快的响应速度和更低的显存占用。
- 边缘设备部署:在Jetson Nano、树莓派等资源受限设备上,GPTQ的极致压缩能力更具优势,能够在保证基本可用性的前提下,将模型塞入极小的存储空间。
具体操作路径
如果你决定使用AWQ,可以通过以下命令快速量化模型:
- 安装AWQ库:
pip install awq - 运行量化脚本:
python awq/quantize.py --model_path meta-llama/Llama-2-7b --wbits 4 --groupsize 128 - 加载量化模型:
from awq import AutoAWQForCausalLM; model = AutoAWQForCausalLM.from_quantized("path/to/quantized_model")
如果使用GPTQ,流程类似:
- 安装AutoGPTQ:
pip install auto-gptq - 量化模型:
from auto_gptq import AutoGPTQForCausalLM; model = AutoGPTQForCausalLM.from_quantized("path/to/quantized_model", device="cuda:0")
Q&A:AWQ和GPTQ精度哪个高
AWQ和GPTQ在3-bit量化下的表现如何?
在3-bit量化下,GPTQ的优势会逐渐显现,因为3-bit的量化空间非常有限,AWQ的保护机制可能不足以弥补巨大的量化误差,导致模型性能急剧下降,而GPTQ的二阶优化算法在极端压缩下能更好地平衡全局误差,因此在3-bit场景下,GPTQ的精度往往优于AWQ。
AWQ量化后的模型体积比GPTQ大吗?
通常情况下,AWQ和GPTQ在4-bit下的模型体积相近,都在原模型的1/4左右,但由于AWQ保留了部分缩放因子和稀疏矩阵信息,其实际磁盘占用可能略大于GPTQ,差异通常在几MB到几十MB之间,对大多数部署场景影响不大。
未来量化技术会取代AWQ和GPTQ吗?
随着LLM.int8()、SmoothQuant等新技术的出现,量化技术正在多元化,LLM.int8()通过混合精度量化,在保持高精度的同时实现了极高的推理速度,正在成为新的主流,AWQ和GPTQ作为经过广泛验证的技术,在未来几年内仍将在特定硬件和场景下占据重要地位,不会轻易被完全取代。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/409666.html

评论列表(1条)
确实!上周刚用AWQ量化了个7B模型,孩子睡了才有空测,幻觉少太多了……GPTQ那会儿压缩到3.5bit,结果模型开始胡