大模型当前的核心瓶颈并非算力不足,而是上下文窗口限制、幻觉问题以及高昂的推理成本,这导致其在处理超长文档、高精度逻辑推理及大规模并发部署时面临严峻挑战。
很多人误以为大模型已经无所不能,只要把数据喂进去就能自动产出完美结果,事实并非如此,当你尝试让一个模型分析几百页的合同,或者要求它进行多步复杂的数学推导时,往往会发现它开始“胡言乱语”或者干脆忘记前面的指令,这种现象背后,隐藏着技术架构与商业落地之间的巨大鸿沟。
上下文窗口的物理极限与记忆碎片化
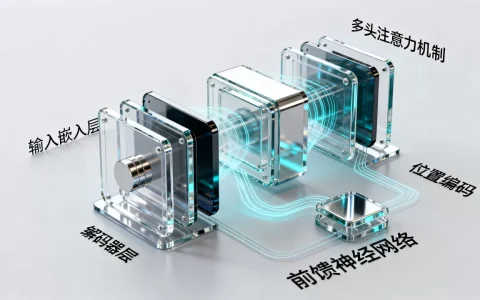
大模型处理信息的能力受限于其“注意力机制”的计算复杂度,虽然厂商不断宣称支持百万级Token的上下文窗口,但在实际应用中,这往往是一个伪命题。
长文本理解的精度衰减
在业内专家指出,随着输入文本长度的增加,模型对早期信息的关注度会显著下降,这种现象被称为“大海捞针”失效。
- 注意力分散:当输入内容超过一定阈值(如3万Token以上),模型难以精准定位关键信息,导致回答出现偏差。
- 逻辑断裂:在多轮对话或长文档分析中,模型容易丢失前文设定的约束条件,导致后续输出与初始要求冲突。
实际场景中的应对策略
面对长文档处理需求,单纯依赖大模型的原始上下文窗口往往不够稳定,更有效的做法是采用“检索增强生成”(RAG)架构。
- 文档切片:将长文档按语义逻辑切分为小块,而非简单按字符数切割。
- 向量化存储:利用向量数据库存储切片后的语义特征,实现快速检索。
- 动态注入:根据用户问题,实时检索最相关的片段,作为上下文注入模型。
这种架构不仅解决了记忆碎片化问题,还大幅降低了推理成本,据统计,采用RAG架构后,企业在处理法律、医疗等专业领域长文本时的准确率提升了相当一部分比例,且响应速度更加稳定。
幻觉问题与逻辑推理的不可靠性
幻觉是大模型最致命的弱点,它不是简单的错误,而是模型自信地输出错误事实,这种现象在需要高精度、零容忍错误的场景中尤为致命。
幻觉产生的根本原因
大模型本质上是基于概率预测下一个字的统计模型,而非拥有真实世界知识的数据库,它并不真正“理解”事实,只是在模仿事实的表达方式。
- 训练数据偏差:训练数据中存在的错误信息会被模型吸收并放大。
- 生成机制缺陷:为了追求语言的流畅性和连贯性,模型可能会编造看似合理但完全虚构的细节。
如何验证与规避幻觉
在关键业务场景中,不能盲目信任模型的输出,必须建立严格的验证机制。
- 多源交叉验证:要求模型提供信息来源,并通过外部搜索引擎或专业数据库进行核实。
- 思维链(CoT)引导:在提示词中明确要求模型展示推理过程,而非直接给出答案,通过检查推理步骤的逻辑性,可以发现并纠正潜在的幻觉。
- 人工审核介入:对于涉及财务、法律、医疗等高风险领域的输出,必须设置人工审核环节,形成“人机协同”的工作流。
行业共识认为,目前没有任何单一技术能彻底消除幻觉,只有通过架构设计和流程管控,才能将风险控制在可接受范围内。
推理成本与部署效率的经济账
大模型的训练成本固然高昂,但推理成本才是企业日常运营中的隐形杀手,随着用户量的增长,推理成本呈线性甚至指数级上升。
Token计费模式的痛点
大多数云服务商按Token数量计费,对于高频调用场景,如智能客服、实时翻译等,Token消耗巨大,导致运营成本难以控制。
- 输入输出比失衡:在某些复杂任务中,输出Token数量可能远超输入,导致成本激增。
- 并发压力:高并发场景下,GPU资源占用率高,延迟增加,影响用户体验。
降本增效的技术路径
为了降低推理成本,业界正在探索多种优化技术。
- 模型量化:将模型参数从16位浮点数降低到8位甚至4位整数,显著减少内存占用和计算量,同时保持较高的精度。
- 模型剪枝:移除模型中不重要的神经元或连接,减小模型体积,提高推理速度。
- 知识蒸馏:用大模型训练一个小模型,让小模型继承大模型的部分能力,从而以更低的成本实现近似的效果。
据工信部相关数据显示,采用量化和剪枝技术后,模型推理速度提升了较大比例,同时显存占用降低了相当一部分,为企业大规模部署提供了可能。
垂直领域应用的落地困境
通用大模型虽然能力强,但在垂直领域往往表现不佳,这是因为通用模型缺乏特定领域的深度知识和专业术语理解能力。
行业数据壁垒与隐私顾虑
金融、医疗、法律等行业拥有大量高质量数据,但这些数据通常涉及隐私和商业机密,难以直接用于通用模型的训练。
- 数据孤岛:企业内部数据分散在不同系统中,整合难度大。
- 合规风险:数据出境、隐私保护等法律法规限制了数据的自由流动和使用。
私有化部署与微调
为了解决垂直领域应用问题,企业倾向于采用私有化部署和微调策略。
- 私有化部署:将模型部署在企业内部服务器上,确保数据不出域,满足合规要求。
- 领域微调:使用行业专用数据对通用模型进行微调,使其更适应特定场景的需求。
私有化部署需要高昂的硬件投入和维护成本,对于中小企业而言,这可能是一笔不小的负担,如何平衡成本与效果,成为企业选择大模型解决方案时的关键考量。
大模型的瓶颈Bottleneck与未来展望
大模型的发展已进入深水区,单纯依靠增加参数规模带来的边际效益正在递减,未来的突破点在于架构创新、算法优化以及与垂直领域的深度融合。
多模态与具身智能
单一文本模态已无法满足复杂场景需求,多模态大模型能够同时处理文本、图像、音频和视频,提供更丰富的交互体验。
- 视觉理解:增强模型对图像内容的理解能力,应用于视觉质检、医疗影像分析等场景。
- 语音交互:提升语音识别和合成的自然度,实现更流畅的人机对话。
具身智能则是将大模型与机器人结合,赋予物理实体智能决策和执行能力,这将开启人机协作的新篇章。
Agent智能体与自动化工作流
大模型将从被动回答问题转向主动执行任务,Agent智能体能够自主规划、调用工具、执行操作,实现复杂工作流的自动化。
- 任务规划:将复杂任务分解为多个子任务,并制定执行计划。
- 工具调用:根据任务需求,自动调用API、数据库或其他软件工具。
- 自我反思:在执行过程中监控结果,发现问题时自动调整策略。
这种转变将极大提升工作效率,改变传统的工作模式。
Q&A:关于大模型瓶颈的常见疑问
大模型为什么会出现幻觉?
大模型基于概率预测生成文本,而非检索真实数据库,当训练数据存在偏差或模型在生成过程中为了追求语言流畅性时,容易编造看似合理但虚构的信息,这是其生成机制决定的固有缺陷,目前只能通过RAG、思维链引导和人工审核等手段进行缓解,无法彻底根除。
企业如何降低大模型的推理成本?
企业可以通过模型量化、剪枝、知识蒸馏等技术手段减小模型体积,提高推理速度,采用RAG架构避免重复训练,利用缓存机制减少重复计算,在部署层面,选择性价比更高的GPU实例,并实施动态批处理技术,提高资源利用率。
大模型在垂直领域的应用前景如何?
垂直领域是大模型落地的主要方向,通过私有化部署和领域微调,大模型能够结合行业专业知识,提供更精准、合规的服务,随着多模态技术和Agent智能体的发展,大模型将在金融、医疗、法律、制造等行业发挥更大作用,推动产业智能化升级。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/402654.html