能,但仅限轻量级模型或经过量化处理的7B及以下参数模型,且需依赖Apple Silicon的内存统一架构优势,无法胜任重度训练或千亿级大模型的推理任务。
在2026年的当下,MacBook M1系列虽然已不再是苹果最新的主力机型,但其搭载的M1芯片凭借独特的内存统一架构,依然在本地运行大语言模型(LLM)的圈子里占据着特殊的一席之地,很多用户纠结于老设备能否跟上AI浪潮,答案并非简单的“能”或“不能”,而是取决于你对“大模型”的定义以及具体的使用场景,如果你指望用M1芯片去训练ChatGPT级别的模型,那显然不现实;但如果你只是想本地部署一个能写代码、做摘要甚至进行简单对话的助手,M1 MacBook完全能够胜任,且体验往往优于同价位的Windows笔记本。
M1芯片运行大模型的技术可行性分析
要理解M1为何能跑大模型,首先要打破传统PC的认知壁垒,传统PC中,CPU和GPU拥有独立的内存,数据需要在两者之间反复拷贝,这不仅速度慢,还受限于显存大小,而Apple Silicon采用的内存统一架构(UMA),让CPU、GPU和神经网络引擎共享同一块高速内存,这意味着,M1芯片的16GB或32GB内存,既可以做系统运行,也可以全部作为显存供AI模型调用。
业内专家指出,这种架构设计使得Mac在处理大模型推理时,能够突破传统显卡显存的物理限制,对于大多数开源大模型而言,参数量直接决定了所需的内存大小,一个70亿参数(7B)的模型,在FP16精度下大约需要14GB内存,而在INT4量化后仅需约4-5GB,M1芯片的内存带宽虽然不如最新的M3 Ultra,但对于7B-13B量级的模型,其带宽足以支撑流畅的Token生成速度。
硬件瓶颈与性能表现
尽管架构优势明显,但M1芯片的物理性能瓶颈依然存在,作为2020年底发布的芯片,其CPU核心数和GPU核心数在2026年看来已显老旧,在处理复杂逻辑推理或长上下文窗口时,M1的算力会显得捉襟见肘。
- 推理速度:对于7B模型,M1芯片的生成速度通常在每秒10-20个Token之间,这一速度足以满足日常阅读和对话需求,但无法达到实时语音转文字或视频生成的流畅度。
- 内存限制:这是M1最大的短板,16GB内存的MacBook在运行7B量化模型后,剩余内存仅够系统轻度运行,一旦开启浏览器多标签页或开发工具,系统可能会频繁使用交换内存,导致性能骤降。
- 温度控制:M1芯片能效比极佳,但在长时间高负载推理下,轻薄本(如MacBook Air)会因无风扇设计而降频,导致推理速度波动。
2026年MacBook M1部署大模型实操指南
对于希望利用现有设备体验AI的用户,直接安装复杂的开发环境并非最佳选择,社区已经涌现出许多开箱即用的解决方案,极大地降低了门槛。
推荐工具:Ollama与LM Studio
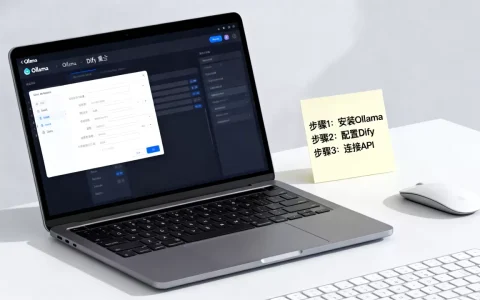
在Mac平台上,Ollama是目前最流行的本地大模型运行框架,它基于Go语言开发,对Apple Silicon优化极好,用户只需一行命令即可下载并运行模型。
具体操作步骤如下:
- 下载安装:访问Ollama官网下载macOS安装包并安装。
- 命令行运行:打开终端,输入
ollama run llama3(以Meta的Llama 3模型为例),系统会自动下载模型文件并在本地运行。 - 图形界面替代方案:如果不习惯命令行,可以使用LM Studio,这是一个可视化的应用程序,支持搜索和下载Hugging Face上的各类模型,界面友好,适合非技术人员。
模型选择策略
在2026年的生态中,模型的选择比硬件更重要,由于M1算力有限,盲目追求大参数模型只会导致卡顿,建议遵循以下原则:
- 首选量化模型:选择GGUF格式的INT4或INT8量化模型,这些模型在精度损失极小的情况下,大幅减少了内存占用。
- 关注小参数模型
:7B(70亿参数)是M1的舒适区,13B是极限区,超过13B的模型在M1上运行体验较差,不建议尝试。
- 专用小模型:除了通用对话模型,还可以尝试专门用于代码生成或文本摘要的小模型,如CodeLlama-7B,它们在特定任务上的表现往往优于通用大模型。
MacBook M1与大模型应用场景对比
为了更直观地展示M1的能力边界,我们将常见的使用场景进行分类,看看哪些场景适合M1,哪些则应避坑。
| 应用场景 | 可行性 | 体验评价 | 备注 |
|---|---|---|---|
| 日常问答与摘要 | 高 | 流畅 | 响应速度快,适合处理文档摘要、邮件润色。 |
| 代码辅助生成 | 中 | 良好 | CodeLlama等模型表现不错,但复杂重构建议云端完成。 |
| 长文档分析 | 低 | 卡顿 | 上下文窗口受内存限制,超过20页PDF易出现内存溢出。 |
| 图像生成 | 极低 | 不可用 | Stable Diffusion等图像模型对GPU算力要求极高,M1难以胜任。 |
| 模型微调训练 | 不可行 | 错误 | 本地训练需要大量算力,M1仅能进行极小规模的LoRA微调,且耗时极长。 |
地域与价格因素考量
在讨论硬件性能时,不得不提的是地域差异带来的价格波动,在国内二手市场,成色较好的16GB内存版M1 MacBook Pro价格已回落至较低区间,对于预算有限的学生或开发者来说,是入门本地AI开发的低成本方案,需要注意的是,二手设备的电池健康和散热硅脂状态可能影响长期高负载运行的稳定性。
相比之下,在美国市场,由于汇率和税收政策的影响,全新或官翻的M1系列价格波动较大,对于追求稳定性的企业用户,建议优先考虑官方保修覆盖范围内的设备,或通过企业采购渠道获取,以确保硬件的一致性和售后支持。
常见疑问解答
MacBook M1能跑大模型吗及性能上限是多少
MacBook M1确实可以运行大模型,但其性能上限受限于内存容量和算力,对于16GB内存版本,建议运行7B参数以下的INT4量化模型;32GB内存版本可勉强运行13B模型,超过此规模,推理速度将显著下降,且可能因内存不足导致程序崩溃。
M1芯片运行大模型与Windows笔记本有何区别
主要区别在于内存架构和软件生态,Windows笔记本通常依赖独立显卡(NVIDIA GPU)的显存,若显存不足,模型根本无法加载,而M1依靠统一内存,加载门槛更低,但推理速度较慢,Windows平台拥有更丰富的CUDA生态,适合开发者进行模型训练和深度定制;Mac平台则更适合终端用户进行模型推理和应用,生态更封闭但体验更统一。
2026年MacBook M1是否还值得购买用于AI开发
如果预算极其有限,且仅用于学习LLM基础原理和轻量级推理,M1仍具性价比,但若涉及复杂的模型调试、微调或需要处理长上下文,M1已无法满足需求,对于严肃的AI开发者,建议升级到M2 Pro/M3 Pro及以上芯片,或转向云端算力资源,M1在2026年的定位,已从“生产力工具”转变为“轻量级AI体验终端”。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/401622.html