服务器集群的核心在于通过负载均衡软件将多台物理或虚拟服务器连接成一个逻辑整体,对外提供统一服务,对内实现故障自动转移与流量分发。
搭建服务器集群并非简单的硬件堆砌,而是一套涉及网络架构、软件配置、数据同步及故障监控的系统工程,对于中小型企业而言,理解集群的底层逻辑比盲目追求高性能硬件更为关键,业内专家指出,合理的集群架构能显著提升系统的可用性和扩展性,这是单体服务器无法比拟的优势。
集群架构选型:从入门到企业级
在动手配置之前,首先需要明确业务场景,不同的应用场景对集群的要求截然不同。
负载均衡集群与高可用集群的区别
很多初学者容易混淆这两种概念,负载均衡集群主要解决“流量分发”问题,比如当用户访问量激增时,如何把请求均匀地分发给后端的几台服务器,避免单点过载,而高可用集群(HA)主要解决“容灾备份”问题,即当某台服务器宕机时,如何快速将业务切换到备用节点,确保服务不中断。
在实际操作中,我们通常将两者结合使用,使用 Nginx 或 HAProxy 作为前端负载均衡器,后端挂载多台应用服务器,同时配合 Keepalived 实现主备切换,这种组合方案在电商大促、金融交易等对稳定性要求极高的场景中极为常见。
常见集群模式对比
为了更直观地理解,我们可以对比几种主流的技术方案:
| 集群类型 | 核心组件 | 适用场景 | 复杂度 |
|---|---|---|---|
| LVS 集群 | ipvsadm | 高并发网络层流量分发 | 中 |
| Nginx 反向代理 | Nginx | Web 服务、静态资源加速 |
低 |
| Kubernetes 容器集群 | K8s | 微服务架构、云原生应用 | 高 |
| 数据库主从集群 | MySQL/Redis | 数据读写分离、备份 | 中 |
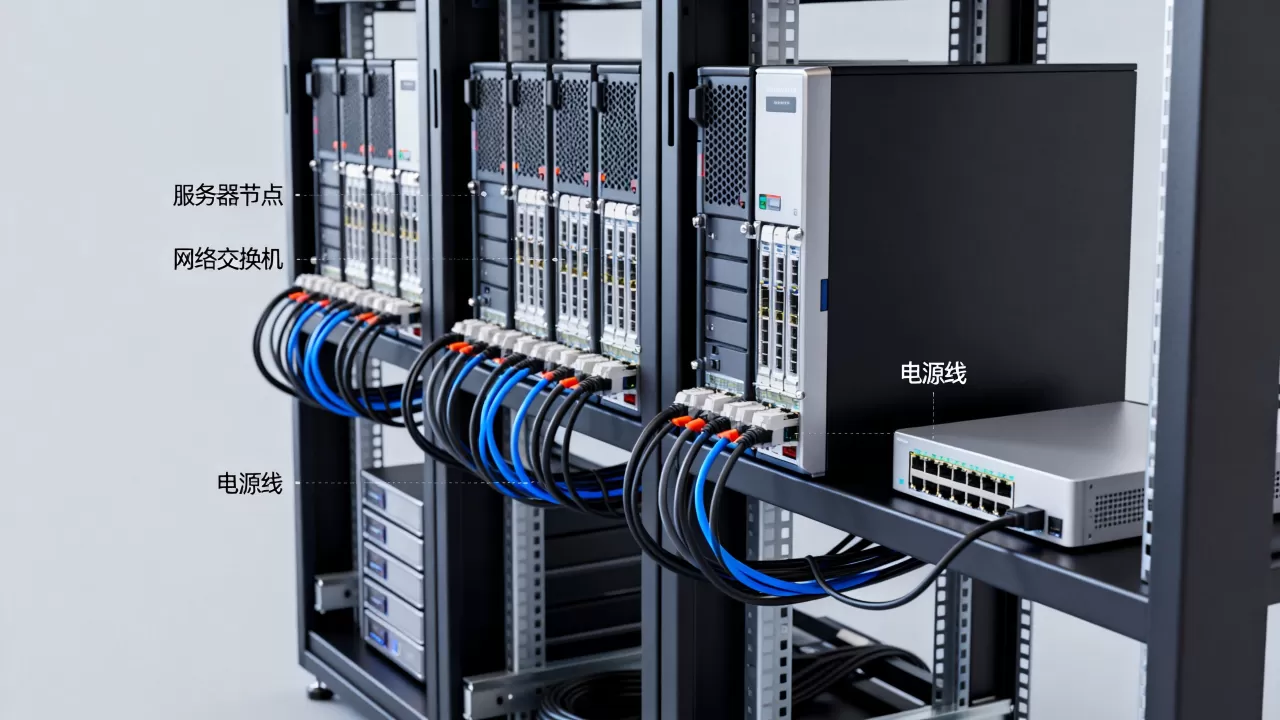
对于大多数初创团队,从 Nginx 反向代理集群起步是性价比最高的选择,它配置简单,社区资源丰富,且能很好地处理 HTTP/HTTPS 请求。
实战步骤:如何搭建基础 Web 集群
假设我们拥有三台服务器:一台作为负载均衡器(IP: 192.168.1.10),两台作为应用服务器(IP: 192.168.1.11 和 192.168.1.12),以下是具体的操作路径。
第一步:配置后端应用服务器
确保两台后端服务器安装了 Web 服务软件(如 Nginx 或 Apache),并部署了相同的应用代码,为了验证集群效果,可以在两台服务器上放置不同的欢迎页面,例如在 1.11 上显示“Server A”,在 1.12 上显示“Server B”。
第二步:配置负载均衡器
在负载均衡器上安装 Nginx,并修改配置文件 /etc/nginx/nginx.conf,我们需要定义一个上游服务器组(upstream),并将后端服务器的 IP 地址填入其中。
upstream backend_servers {
    server 192.168.1.11:80;
    server 192.168.1.12:80;
}
server {
    listen 80;
    server_name example.com;
    location / {
        proxy_pass http://backend_servers;
        proxy_set_header Host $host;
        proxy_set_header X-Real-IP $remote_addr;
    }
}
上述配置采用了默认的轮询策略,即每次请求依次分配给不同的后端服务器,如果需要更复杂的调度算法,如基于 IP 哈希(ip_hash)以实现会话保持,只需在 upstream 块中添加 ip_hash; 指令。
第三步:测试与验证
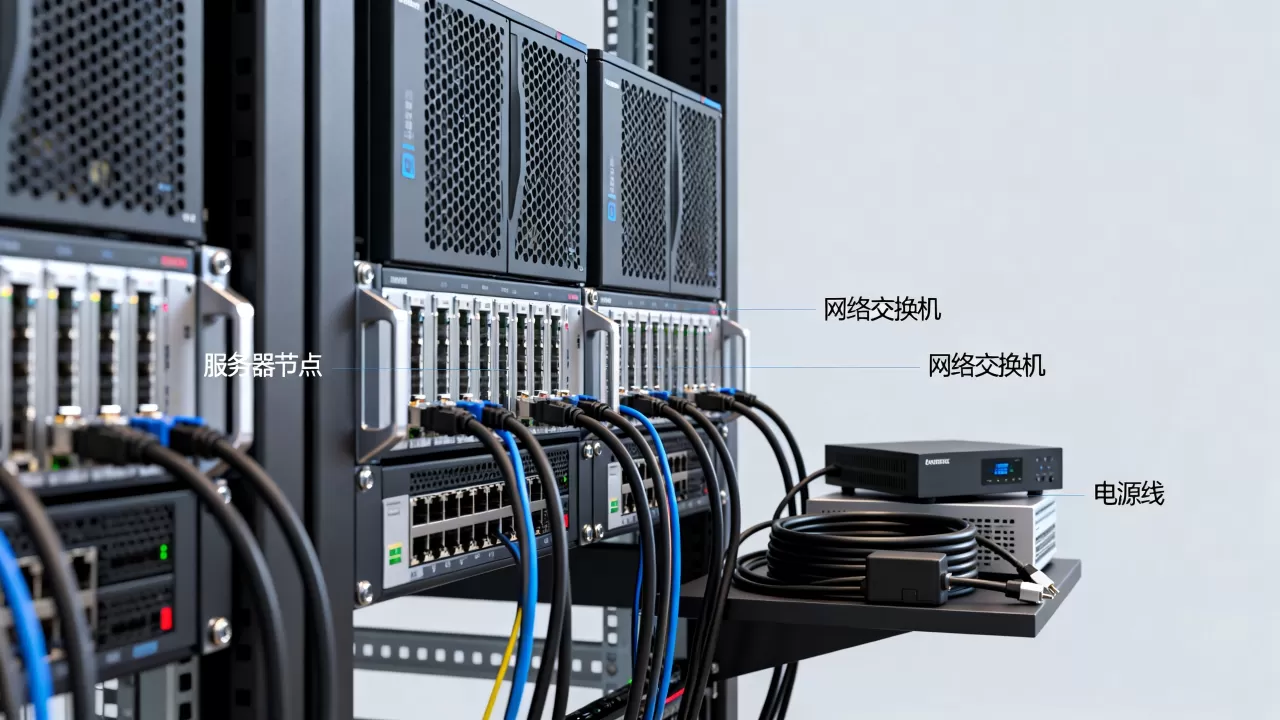
保存配置后,重启 Nginx 服务,通过浏览器多次访问负载均衡器的 IP 地址,观察返回的页面内容是否在“Server A”和“Server B”之间切换,如果切换正常,说明基础的负载均衡集群已搭建成功。
进阶优化:解决会话保持与数据一致性问题
基础集群解决了流量分发问题,但在实际业务中,用户登录状态、购物车数据等往往需要保持会话一致性,如果用户第一次请求落在 Server A,第二次落在 Server B,且没有会话共享机制,用户可能会被迫重新登录。
会话保持方案对比
解决会话问题主要有两种思路:粘性会话和无状态化。
- 粘性会话(Sticky Session):通过 Nginx 的
ip_hash或cookie指令,强制将同一客户端的请求始终转发到同一台后端服务器,这种方式配置简单,但缺点是如果某台服务器宕机,该服务器上的会话数据将丢失,导致用户体验中断。 - 无状态化(Session 共享):将会话数据从服务器内存中剥离,存储到独立的缓存系统中,如 Redis 或 Memcached,所有后端服务器都从 Redis 读取和写入会话数据,这种方式实现了真正的无状态,任意服务器宕机都不会影响用户登录状态,是业内共识认为更优的架构方案。
数据一致性挑战
除了会话数据,业务数据的一致性也是集群架构中的难点,在分布式数据库集群中,如何保证多节点间的数据最终一致性?多数情况下,开发者会采用异步复制机制,牺牲一定的实时性来换取高可用性,对于强一致性要求的场景,则需引入分布式事务框架,但这会显著增加系统复杂度。
监控与维护:集群的生命线
搭建集群只是开始,持续的监控和维护才是保障业务稳定的关键,没有监控的集群如同盲人摸象,无法及时发现潜在风险。
关键监控指标
需要重点监控以下指标:
- CPU 和内存使用率:判断后端服务器是否过载。
- 网络带宽:监控入口流量是否达到瓶颈。
- 请求延迟(Latency):反映后端服务的响应速度。
- 错误率(5xx 状态码):直接反映后端服务的健康状况。
自动化运维工具
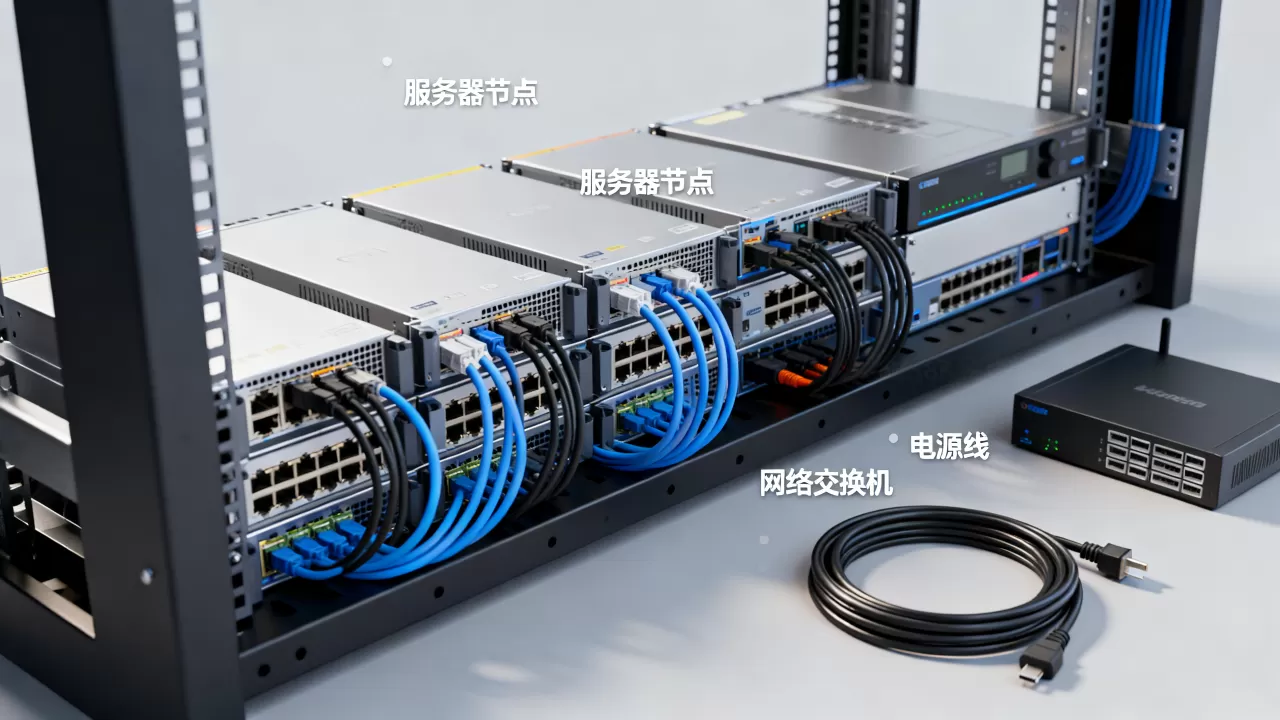
随着集群规模扩大,手动维护变得不切实际,近年来,Prometheus 和 Grafana 成为主流的监控组合,Prometheus 负责采集数据,Grafana 负责可视化展示,通过配置 Alertmanager,可以在指标异常时自动发送钉钉、邮件或短信告警,实现从“被动救火”到“主动预防”的转变。
常见问题解答
服务器集群搭建成本高吗?
集群的成本取决于架构选型和规模,对于小型项目,使用开源软件(如 Nginx、Keepalived)配合云服务器,初期成本可控,仅需支付计算和带宽费用,随着节点增加,网络配置复杂度、运维人力成本以及中间件授权费用(如商业版 Redis)会显著上升,据统计,集群的运维复杂度通常随节点数量呈指数级增长,因此建议在业务增长到一定阶段后再考虑引入复杂的分布式架构。
单点故障如何避免?
避免单点故障的核心原则是“冗余”,负载均衡器本身也可能是单点,因此需要部署双机热备(如 Keepalived + VRRP 协议),确保主负载均衡器宕机时,备用节点能在秒级接管 VIP(虚拟 IP),后端应用服务器应至少保持两个节点,数据库应采用主从复制或多副本机制,任何关键组件都不应只存在一个实例。
如何选择负载均衡算法?
算法选择需匹配业务特性,轮询(Round Robin)适用于无状态服务,简单公平;加权轮询(Weighted Round Robin)适用于后端服务器性能不一的场景,性能强的机器分配更多流量;最少连接数(Least Connections)适用于长连接业务,如数据库代理;IP 哈希(IP Hash)适用于需要会话保持的场景,没有绝对最好的算法,只有最适合当前业务场景的方案。
服务器集群的本质是通过软件定义硬件能力,以低成本换取高可用性和弹性扩展,掌握基础架构原理,结合具体业务场景灵活选型,并在实践中持续优化监控与运维流程,才是构建稳定集群系统的正道。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/462295.html