

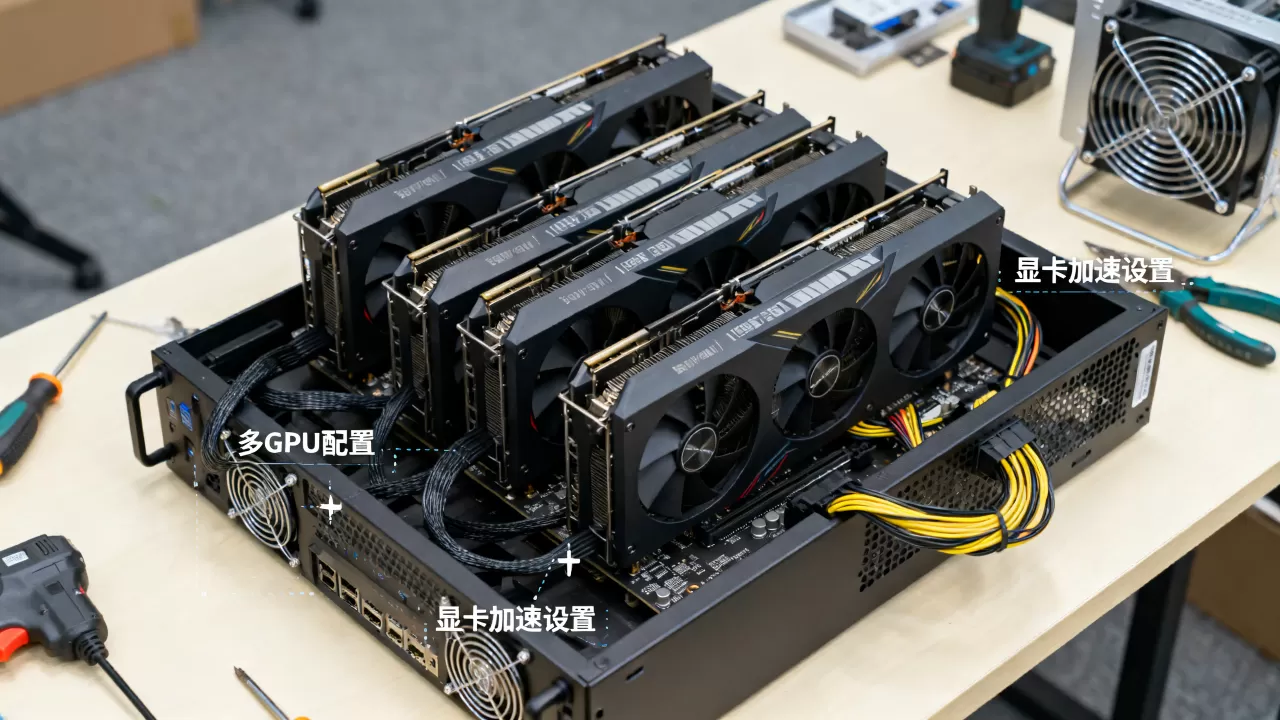
Ollama配置多GPU的核心在于正确设置环境变量并修改配置文件,让进程能识别并调度所有可用显卡,从而实现显存协同与推理加速。
在单机多卡环境下,很多开发者遇到模型加载失败或显存占用不均的问题,本质上是Ollama默认只调用第一张显卡导致的,通过简单的配置调整,就能让多张显卡组成一个逻辑上的“超级显存池”,这对于运行大参数模型至关重要。
Ollama多GPU环境配置基础
多GPU配置并非难事,关键在于让Ollama服务进程知道有哪些显卡可用,这通常涉及操作系统的环境变量设置和Ollama自身的配置文件修改。
Linux系统下的环境变量设置
在Linux系统中,NVIDIA显卡驱动通常会暴露设备节点给应用程序,Ollama依赖CUDA工具包来访问这些设备。
- 检查显卡状态:首先确保NVIDIA驱动已安装且正常,在终端输入
nvidia-smi,确认所有显卡状态为“就绪”且驱动版本一致。 - 设置可见设备:默认情况下,某些环境可能只暴露第一张卡,需要设置
CUDA_VISIBLE_DEVICES环境变量,若你有两张卡,ID分别为0和1,则设置变量为export CUDA_VISIBLE_DEVICES=0,1。 - 持久化配置:为避免每次重启失效,建议将上述export命令添加到
~/.bashrc或/etc/environment文件中。
Windows系统下的配置差异
Windows用户通常通过图形界面或系统高级设置来配置环境变量。
- 系统环境变量:右键“此电脑” -> 属性 -> 高级系统设置 -> 环境变量,新建变量
CUDA_VISIBLE_DEVICES,值为0,1(根据实际显卡ID调整)。 - 服务重启:修改环境变量后,必须完全退出并重启Ollama服务,新配置才能生效。
Ollama配置文件详解与修改
除了环境变量,Ollama自身的配置文件~/.ollama/config.json(Linux/Mac)或 %USERPROFILE%.ollamaconfig.json(Windows)也起着决定性作用。
核心参数解析
配置文件中的关键参数直接影响多卡调度策略。
- num_gpu:此参数决定加载到GPU上的层数,设为
-1或省略时,Ollama会尝试将所有层加载到显存中,在多卡环境下,这通常意味着模型会被拆分到所有可用显卡上。 - num_thread:设置CPU线程数,虽然主要涉及CPU,但在GPU显存溢出时,部分计算会回退到CPU,合理的线程数能减少性能瓶颈。
手动编辑配置文件
- 定位文件:找到用户目录下的
.ollama文件夹。 - 备份原文件:操作前复制一份
config.json作为备份,以防配置错误导致服务无法启动。 - 添加多卡支持:在JSON对象中添加或修改
num_gpu字段。{ "num_gpu": -1, "num_thread": 8 }注意:不同版本的Ollama对配置文件的格式要求可能略有不同,建议参考官方最新文档。
多GPU推理性能优化策略
配置完成后,如何确保多卡协同工作高效且稳定,是进阶用户关心的重点。
显存负载均衡
Ollama默认采用分层拆分策略,将模型的不同层分布到不同显卡上。
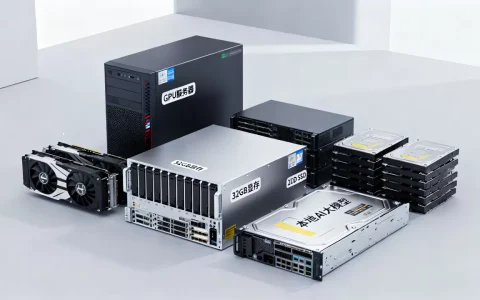
- 均匀分布:对于参数量巨大的模型,如Llama-3-70B,单张24GB显存的显卡无法容纳,多卡配置后,模型层会被均匀切分。
- 显存监控:使用
nvidia-smi实时监控各卡显存占用,若发现某张卡显存满载而其他卡空闲,可能是配置未正确生效,或模型层拆分算法存在局限。
PCIe带宽瓶颈
多GPU之间通过PCIe总线通信,带宽成为潜在瓶颈。
- NVLink优势:若显卡支持NVLink(如A100/H100),通信延迟大幅降低,推理速度显著提升。
- 普通PCIe场景:对于消费级显卡(如RTX 3090/4090),PCIe 4.0 x16带宽虽高,但在模型加载和中间结果传输时仍可能成为瓶颈,建议将显卡插入主板的高速插槽。
常见问题排查与解决方案
在实际操作中,用户常遇到各种报错,以下是高频问题的解决路径。
显存不足错误
若提示CUDA out of memory,即使配置了多卡也可能发生。
- 检查显存总和:确认所有显卡显存之和是否大于模型所需显存。
- 量化模型:使用GGUF格式的量化模型(如Q4_K_M),可大幅降低显存需求。
- 限制并发:减少同时运行的请求数量,避免显存碎片化。
多卡识别失败
若Ollama只使用了一张卡,即使配置了环境变量。
- 检查驱动版本:确保NVIDIA驱动版本支持当前CUDA版本。
- 重启服务:有时环境变量修改后,Ollama服务未重新读取,需重启服务。
- 查看日志:运行
ollama serve查看控制台输出,寻找CUDA初始化相关的错误信息。
Ollama多GPU配置对比分析
为了更直观地理解不同配置方案的效果,以下表格对比了单卡与多卡配置的关键差异。
| 配置维度 | 单卡配置 | 多卡配置 |
|---|---|---|
| 显存容量 | 单卡显存限制 | 多卡显存总和(理论上) |
| 推理速度 | 受限于单卡算力 | 并行计算,速度提升显著 |
| 配置复杂度 | 简单,即插即用 | 需配置环境变量和文件 |
| 适用场景 | 小参数模型(<13B) | 大参数模型(>30B) |
| 成本 | 低 | 较高,需多张显卡 |
业内专家指出,对于超过30B参数的模型,多卡配置几乎是必选项,否则模型根本无法加载。
Q&A:Ollama多GPU配置常见疑问
Ollama怎么配置多GPU才能生效?
生效的关键步骤是设置CUDA_VISIBLE_DEVICES环境变量,并在config.json中设置num_gpu为-1,修改后必须重启Ollama服务,若使用Docker,需在启动命令中添加--gpus all参数。
多GPU配置后推理速度一定比单卡快吗?
不一定,若模型较小,能完全放入单卡显存,单卡推理通常更快,因为避免了跨卡通信开销,仅当模型过大,必须拆分到多卡时,多卡配置才能发挥加速作用,PCIe带宽和显卡互联方式(如NVLink)也会影响最终性能。
Ollama多GPU配置支持混合显卡型号吗?
理论上支持,但强烈不建议,不同型号显卡的显存带宽、计算单元数量差异巨大,可能导致负载极度不均,甚至引发兼容性问题,最佳实践是使用相同型号、相同显存容量的显卡组成多卡集群。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/400324.html

评论列表(1条)
码住。之前试过好几次多卡,结果还是只认第一张,显存占用不均烦死人了。希望能像文章说的那样配成功,mark一下先。