

选择LM Studio的GGUF模型,核心在于平衡硬件显存容量与任务需求,优先在Hugging Face下载带有Q4_K_M或Q5_K_M量化标签的模型,并确保模型架构(如Llama-3、Qwen-2.5)与你本地的LLM引擎兼容。
在本地部署大语言模型时,面对Hugging Face上成千上万的GGUF文件,新手往往感到无从下手,这不仅仅是下载一个文件的问题,更是关于算力分配、推理速度与输出质量之间的精密博弈,业内专家指出,理解量化技术的基本原理是做出正确选择的前提,GGUF格式通过量化技术将模型参数从32位浮点数压缩至更低位数,从而大幅降低内存占用。
理解量化等级与精度的权衡
量化是GGUF模型的核心特征,不同的量化后缀代表了不同的压缩率和精度损失,对于大多数用户而言,理解这些后缀的含义能避免“买错”模型。
常见量化后缀解析
- Q4_K_M:这是目前的“黄金标准”,它在保持较高推理速度的同时,将精度损失控制在极小范围内,对于90%的日常对话、代码生成和文本摘要任务,Q4_K_M是性价比最高的选择,它通常能保留模型95%以上的原始能力。
- Q5_K_M:如果你拥有充裕的显存(如24GB以上),且对逻辑推理的准确性有更高要求,Q5_K_M是更好的选择,相比Q4,它多占用约10%-15%的内存,但能显著提升复杂指令遵循的表现。
- Q8_0:接近原始FP16精度的量化版本,仅在显存极度充裕(如48GB+)且对细节敏感度极高的场景下推荐,对于普通用户,Q8往往意味着不必要的资源浪费。
- Q2/Q3:极低精度量化,仅适用于显存极度受限(如8GB以下)的老旧设备,或作为快速原型测试,其输出质量通常会出现明显的逻辑断裂和幻觉,不建议用于生产环境。
如何根据显存选择量化等级
选择量化等级前,必须计算模型所需的显存,一个粗略的经验法则是:1B参数(十亿参数)的模型在Q4量化下约占0.7GB显存,7B模型在Q4下约需4-5GB,而70B模型在Q4下则需要约40GB显存。
显存计算实操步骤
- 确认你的GPU显存大小(如NVIDIA RTX 3090为24GB)。
- 确定目标模型的参数量(如Llama-3-8B为8B)。
- 应用公式:所需显存 ≈ 参数量 × 0.7 + 上下文窗口额外开销。
- 预留20%显存用于系统和其他应用,确保推理流畅。
模型架构与适用场景匹配
仅仅关注量化是不够的,模型的架构决定了它的“性格”和能力边界,2026年的主流模型家族各有侧重,选错架构会导致事倍功半。
主流模型家族对比
| 模型家族 | 优势场景 | 劣势场景 | 推荐量化 |
|---|---|---|---|
| Llama 3 / 3.1 | 通用对话、逻辑推理、英文为主 | 中文语境理解略逊于国产模型 | Q4_K_M |
| Qwen 2.5 | 中文理解、代码生成、长文本 | 纯英文创意写作稍弱 | Q5_K_M |
| Mistral / Mixtral | 高效推理、多语言支持 | 指令遵循需微调 | Q4_K_M |
| Gemma 2 | 创意写作、多模态预处理 | 资源消耗较大 | Q4_K_M |
中文场景下的特殊考量
对于国内用户,Qwen 2.5系列在中文语境下的表现往往优于同参量的Llama系列,这并非因为Llama不够好,而是Qwen在训练数据中包含了更高质量的中文语料,如果你主要进行中文写作、客服对话或本地知识库检索,优先选择Qwen系列的GGUF模型。
LM Studio中的实操筛选技巧
在LM Studio界面中,如何快速找到最适合你的模型?不要盲目点击“下载”,遵循以下筛选路径能节省大量时间。
搜索与过滤策略
- 使用精确关键词:在搜索栏输入“模型名称 + 量化等级 + GGUF”,Llama-3-8B-Q4_K_M”,避免只搜模型名,否则会出现大量不同量化版本。
- 查看发布者信誉:优先选择由Meta、Alibaba、Mistral AI等官方账号,或Hugging Face上高星级的知名社区用户(如bartowski, MaziyarPanahi)发布的模型,这些发布者通常会进行严格的测试和清洗。
- 检查上下文长度:在模型详情页,查看“Context Length”参数,如果你需要处理长文档,选择支持32K或128K上下文的版本,而非默认的8K。
下载前的验证清单
- 确认文件大小:7B模型Q4版本通常在4-5GB,若文件过大(如超过10GB),可能包含不必要的LoRA适配器或量化等级过高。
- 阅读README:发布者通常会在模型描述中注明最佳温度(Temperature)和采样参数,遵循这些建议能获得最佳效果。
- 测试推理速度:下载后,在LM Studio中加载模型,观察首字生成时间(TTFT),若超过5秒,考虑降低量化等级或更换更小的模型。
常见问题与避坑指南
LM Studio的GGUF模型怎么选才不踩坑
许多用户反馈模型加载失败或输出乱码,这通常源于架构不匹配,LM Studio基于llama.cpp构建,支持绝大多数主流架构,但极少数小众架构可能不被支持。
解决加载失败的方法
- 检查架构类型:在LM Studio左侧模型列表中,查看模型图标下方的架构标识,若显示“Unknown”或报错,尝试寻找同一模型的其他量化版本,有时不同量化版本由不同发布者打包,架构元数据可能不同。
- 更新LM Studio:确保使用最新版本的LM Studio,以支持最新的模型架构(如Llama-3.1的特定变体)。
- 清理缓存:若模型损坏,删除本地缓存文件夹(通常在~/.cache/huggingface或LM Studio的数据目录),重新下载。
如何判断模型是否适合我的硬件
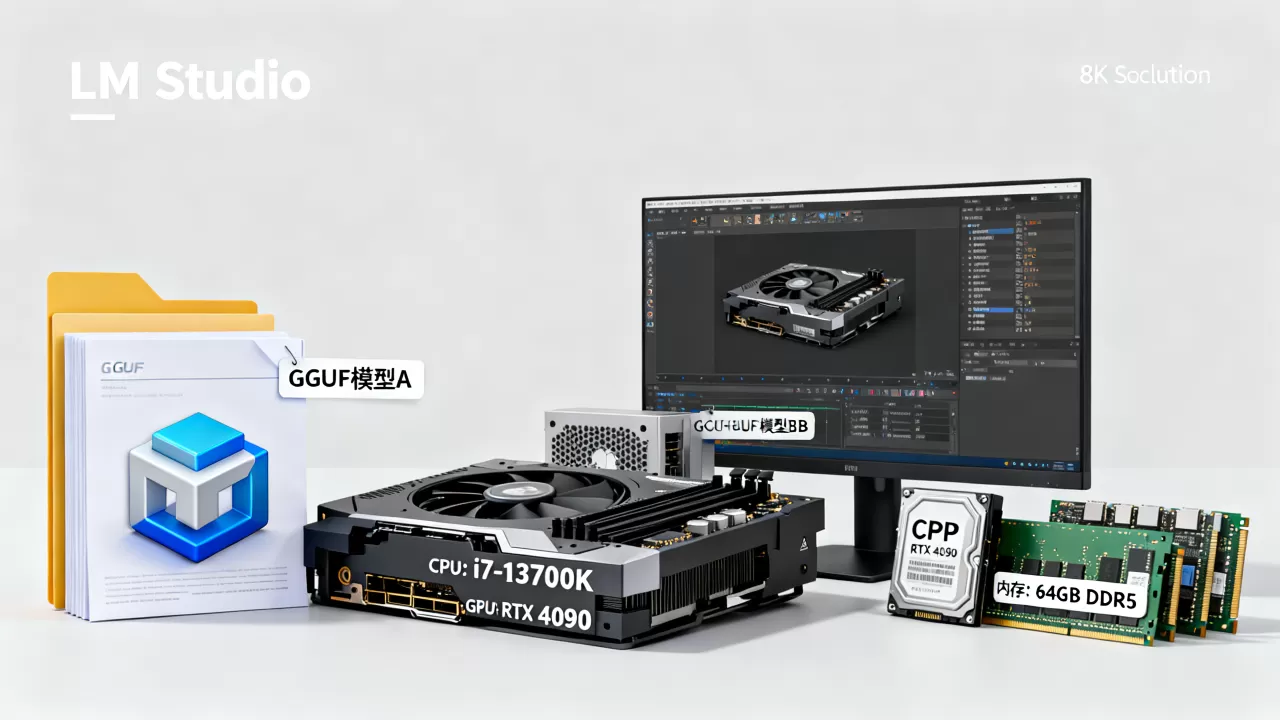
硬件适配是本地部署的最大痛点,对于集成显卡或老旧独立显卡用户,7B以下的模型是最佳选择,若显存不足,LM Studio支持CPU推理,但速度会显著下降。
CPU推理优化建议
- 启用多线程:在LM Studio设置中,增加“CPU Threads”数量,通常设置为物理核心数可获得最佳平衡。
- 使用Q4_K_M:在CPU上,Q4_K_M的压缩率与精度平衡最好,能减少内存带宽压力。
- 关闭GPU加速:若显存不足,完全禁用GPU层,让LM Studio仅使用CPU和RAM,避免显存溢出导致的崩溃。
选择LM Studio的GGUF模型并非玄学,而是一场基于硬件约束的理性计算,核心原则是:在显存允许的范围内,选择最高精度的量化版本;在模型架构上,优先选择经过社区验证的主流家族,通过理解量化等级、匹配应用场景并遵循实操筛选步骤,你可以高效构建出稳定、高效的本地AI助手,没有“最好”的模型,只有“最适合”你当前硬件和需求的模型。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/398811.html

评论列表(1条)
国外的时候直接下HuggingFace就完事了,国内这网速加载GGUF简直慢得想哭。