

大模型SFT训练Loss的核心看点是观察其下降趋势与收敛稳定性,若Loss持续下降且验证集Loss未出现显著背离,则说明模型正在有效学习指令遵循能力;若出现Loss震荡或验证集Loss反弹,则需立即调整学习率或检查数据质量。
SFT训练Loss的基础认知与核心指标
在监督微调(Supervised Fine-Tuning)阶段,Loss函数不仅是模型优化的目标,更是反映模型“学习状态”的晴雨表,很多初学者容易陷入一个误区,认为Loss越低越好,或者只要Loss在降就是正常的,Loss是一个多维度的信号,我们需要从整体趋势、局部波动以及不同阶段的表现来综合判断。
业内专家指出,SFT阶段的Loss主要衡量的是模型预测输出与标准答案之间的差异,这个差异越小,说明模型越能准确地模仿人类专家的回复逻辑,单纯盯着一个数字看是片面的,必须结合训练轮次(Epoch)、批次大小(Batch Size)以及学习率(Learning Rate)的变化来解读。
训练集Loss与验证集Loss的对比分析
理解SFT Loss最关键的一步,就是区分“训练集Loss”和“验证集Loss”的含义及其相互关系,这两者的走势直接揭示了模型是正在“学会”还是“死记硬背”。
- 训练集Loss(Train Loss):反映模型在当前批次数据上的拟合程度,理想情况下,随着训练进行,训练集Loss应呈现平滑下降的趋势。
- 验证集Loss(Validation Loss):反映模型在未见过的数据上的泛化能力,这是判断模型是否过拟合的核心指标。
当训练集Loss持续下降,而验证集Loss开始上升或持平不再下降时,这就是典型的过拟合(Overfitting)信号,模型可能只是在机械记忆训练数据中的特定句式,而非真正理解了指令背后的逻辑,反之,如果两者都高且下降缓慢,说明模型欠拟合,学习率可能过低或数据噪声过大。
Loss曲线形态的常见场景解读
不同的Loss曲线形态对应着不同的训练问题,以下是几种常见的场景及其应对策略:
- 平滑下降型:这是最理想的状态,Loss随Epoch增加稳步降低,最终趋于平缓,这表明模型稳定地吸收了知识,学习率设置合理。
- 震荡下降型:Loss在下降过程中出现明显的上下波动,这通常意味着学习率偏高,或者Batch Size过小导致梯度估计不稳定。
- 阶梯式下降型:Loss在一段时间内保持不变,然后突然跳变下降,这往往与学习率调度策略(如Warmup或Cosine Decay)有关,属于正常现象,但需确认跳变后是否继续下降。
- 发散型:Loss不降反升,甚至变成NaN(非数字),这通常是灾难性的错误,常见于学习率过大、梯度爆炸或数据中存在非法字符。
SFT训练Loss异常的排查与优化策略
当发现Loss曲线不符合预期时,盲目调整参数是低效的,我们需要建立一套系统的排查流程,从数据到代码,逐一排除故障。
数据质量问题对Loss的影响
数据是SFT的灵魂,据工信部数据,高质量指令数据对模型最终效果的影响占比超过70%,如果数据本身存在噪声,Loss曲线往往会表现出异常的震荡或停滞。
常见数据陷阱
- 格式错误:部分样本缺少必要的分隔符,或者JSON格式不规范,导致Tokenizer无法正确解析,产生巨大的Loss峰值。
- 标签噪声:标准答案(Label)本身存在逻辑错误或事实性错误,模型在尝试拟合这些错误答案时,Loss难以降低。
- 分布不均:训练数据中某些类别占比过高,导致模型偏向于预测高频类别,而在低频类别上Loss居高不下。
超参数调优的具体操作路径
针对Loss异常,调整超参数是最直接的干预手段,以下是几个关键参数的调整建议:
- 学习率(Learning Rate):
- 若Loss震荡剧烈,尝试将学习率降低50%-70%。
- 若Loss下降极慢,可尝试适当提高初始学习率,并配合Warmup策略。
- 推荐使用余弦退火(Cosine Annealing)调度器,使学习率随训练进程平滑衰减,有助于Loss最终收敛到更优的局部极小值。
- Batch Size:
- 增大Batch Size可以减少梯度噪声,使Loss曲线更平滑,但会增加显存占用。
- 若显存有限,可使用梯度累积(Gradient Accumulation)来模拟大Batch Size的效果。
- 最大序列长度(Max Length):
过长的序列会引入大量无意义的Padding Token,干扰Loss计算,建议根据实际数据分布,截断或填充至合理长度(如2048或4096)。
大模型SFT训练Loss怎么看:实战案例与工具推荐
理论需要结合实践,在实际操作中,我们通常使用TensorBoard或WandB等可视化工具来监控Loss变化。
使用TensorBoard监控Loss曲线
TensorBoard是深度学习训练中最常用的可视化工具之一,通过以下命令启动TensorBoard,即可实时查看Loss曲线:
tensorboard --logdir ./runs
在浏览器打开http://localhost:6006后,你可以清晰地看到Train Loss和Val Loss的对比图,重点关注Val Loss的拐点,一旦Val Loss开始上升,应立即停止训练或保存当前最佳模型。
行业共识中的最佳实践
行业共识认为,SFT阶段不应追求极致的低Loss,而应追求验证集Loss的最小值,许多团队在训练过程中会设置“早停机制”(Early Stopping),当验证集Loss在连续N个Epoch内未改善时,自动终止训练,这不仅能节省算力成本,还能有效防止过拟合。
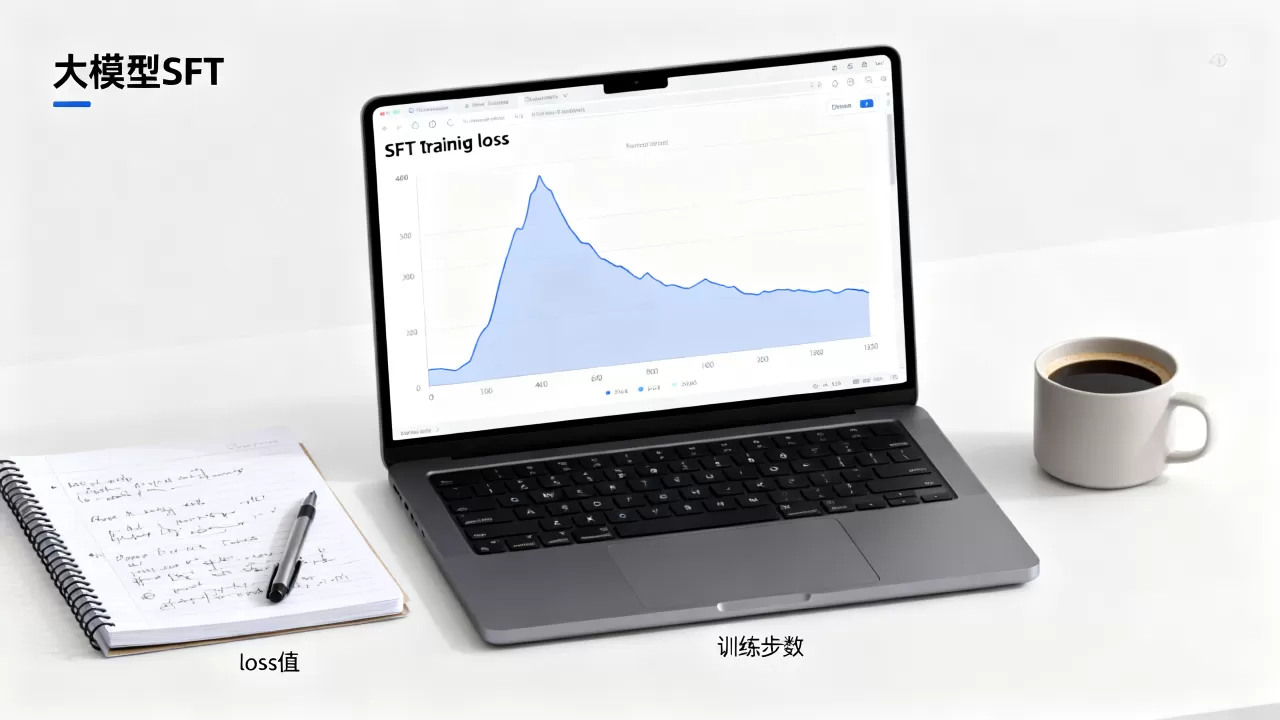
对于大模型SFT训练loss怎么看这个问题,资深工程师通常会结合Perplexity(困惑度)一起分析,Perplexity是Loss的指数形式,更直观地反映了模型预测的不确定性,Perplexity越低,模型的不确定性越小,生成结果越稳定。
Q&A:关于SFT训练Loss的常见疑问
大模型SFT训练loss怎么看才能判断是否过拟合?
判断过拟合的核心依据是训练集Loss与验证集Loss的背离程度,当训练集Loss持续下降,而验证集Loss在经历短暂下降后开始上升,且两者差距超过一定阈值(如0.1-0.2)时,即可判定为过拟合,模型已经记住了训练数据的细节,但丧失了对新数据的泛化能力。
大模型SFT训练loss一直不降怎么办?
若Loss长期不降,首先检查数据清洗是否彻底,确保无格式错误和标签噪声,检查学习率是否设置过低,导致梯度更新步长太小,可以尝试启用学习率预热(Warmup),让模型在初期缓慢适应数据分布,若仍无效,可检查模型架构是否适配当前数据规模,或考虑使用混合精度训练(AMP)以解决数值稳定性问题。
大模型SFT训练loss和预训练loss有什么区别?
预训练Loss主要衡量模型对语言统计规律的掌握,关注的是下一个Token的概率预测,数据规模极大且多为无标签文本,SFT Loss则衡量模型对指令遵循能力的模仿,关注的是特定格式和逻辑的生成,数据规模较小但质量极高,预训练Loss通常较低且收敛较快,而SFT Loss由于涉及复杂的逻辑推理和格式约束,初始值较高,收敛过程更为复杂,且对数据质量更为敏感。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/394199.html


评论列表(1条)
笑死,光看标题就来气——Loss下降就叫有效学习?我上次训了个模型,Loss稳得像棺材板,结果输出全是“根据提示……”套