

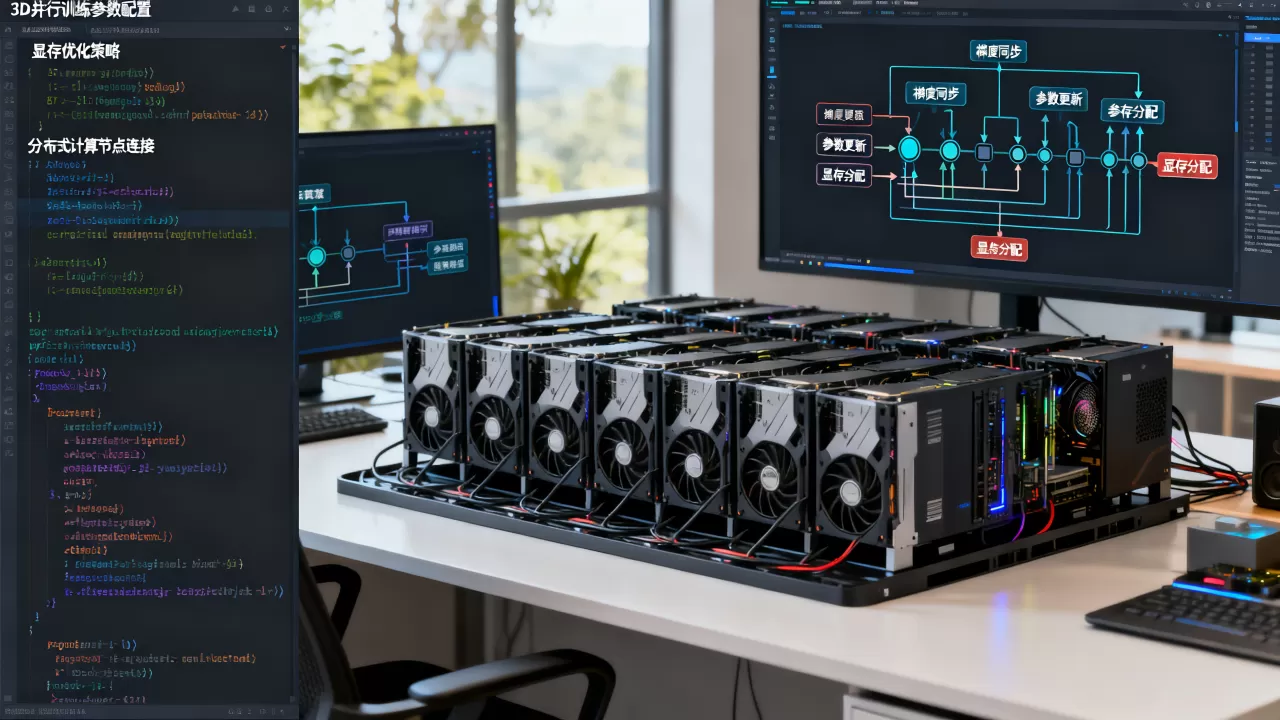
大模型分布式训练的核心在于将模型、数据和计算资源在三维空间(数据并行、张量并行、流水线并行)中进行高效切分与协同,以解决显存墙和通信瓶颈问题。
为什么传统训练方式跑不动千亿参数模型
在单机单卡时代,我们习惯了把整个模型加载到显存里,但随着模型参数量突破千亿甚至万亿级别,这种“全量加载”的思路直接撞上了显存容量的天花板,业内专家指出,当模型大小超过单卡显存极限时,不仅无法加载权重,反向传播时的激活值也会迅速耗尽资源。
这时候,分布式训练不再是“可选项”,而是“必选项”,我们需要把一个大蛋糕切成小块,分给多张显卡甚至多个节点去处理,如果切分方式不对,通信开销会瞬间吃掉计算收益,导致训练速度比单机还慢,这就是为什么理解3D并行架构至关重要。
数据并行:最基础的并行策略
数据并行(Data Parallelism, DP)是最容易理解的方式,想象一下,你有100个工人(GPU),你复制了100份完全相同的模型副本,每个工人拿一份。
工作原理
- 前向传播:每个工人用不同的数据批次进行计算,得到各自的损失值。
- 梯度聚合:所有工人计算出的梯度通过All-Reduce操作进行同步,确保模型权重保持一致。
- 权重更新:同步后的梯度用于更新本地模型参数。
这种方式扩展性较好,但瓶颈在于显存占用随模型大小线性增长,对于千亿参数模型,单卡显存根本存不下一个完整副本。
张量并行:把神经元切开
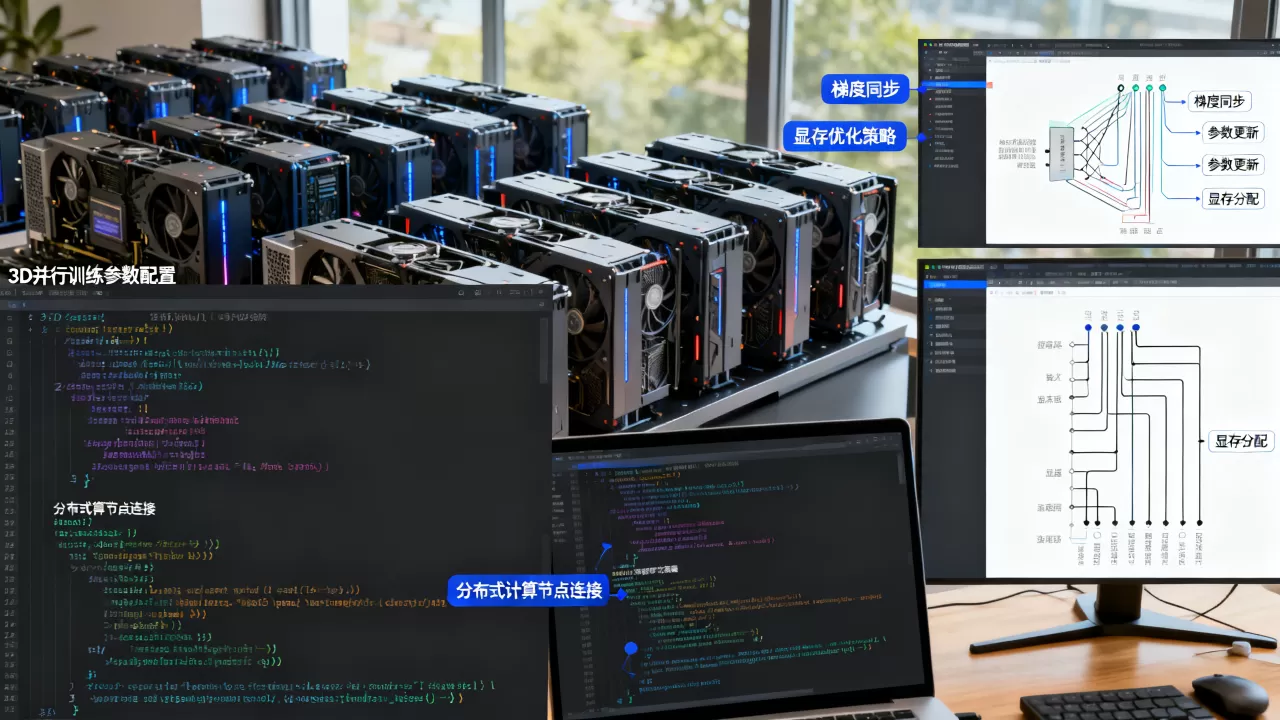
当模型太大,连一个副本都放不下时,我们需要更细粒度的切分,这就是张量并行(Tensor Parallelism, TP),它不复制模型,而是把模型内部的矩阵运算切开。
矩阵切分逻辑
以线性层为例,假设权重矩阵是 $W$,输入是 $X$,输出是 $Y = XW$,在TP中,我们将 $W$ 沿行或列切分为 $W_1, W_2$,分别由不同的GPU计算。
- 行切分:每个GPU计算部分行向量,最后通过All-Reduce求和得到完整输出。
- 列切分:每个GPU计算部分列向量,输出直接拼接,无需通信。
TP显著降低了单卡显存压力,但代价是通信频率急剧增加,每计算一层,GPU之间都需要频繁交换数据,TP通常适用于同一节点内通过高速互联(如NVLink)连接的GPU。
流水线并行:解决通信瓶颈的关键
如果模型大到连一个节点内的GPU都无法通过TP完全容纳,或者为了进一步利用多节点资源,我们就需要引入流水线并行(Pipeline Parallelism, PP)。
传统流水线的问题
早期的流水线并行存在严重的“气泡”(Bubble)问题,就像工厂流水线,如果第一道工序很慢,第二道工序就得等着;如果第一道很快,第二道做完也得等着第一道送过来,这种空闲时间极大地浪费了算力。
微批次与重计算
为了解决这个问题,现代框架引入了微批次(Micro-batching)和激活重计算(Activation Recomputation)技术。
- 微批次:将一个大的Batch拆分成多个小的Micro-batch,在流水线上交错执行,填满气泡。
- 激活重计算:前向传播时不保存中间激活值,反向传播时重新计算,这用计算换显存,虽然增加了计算量,但大幅降低了显存峰值。
3D并行组合策略:1D+2D+3D
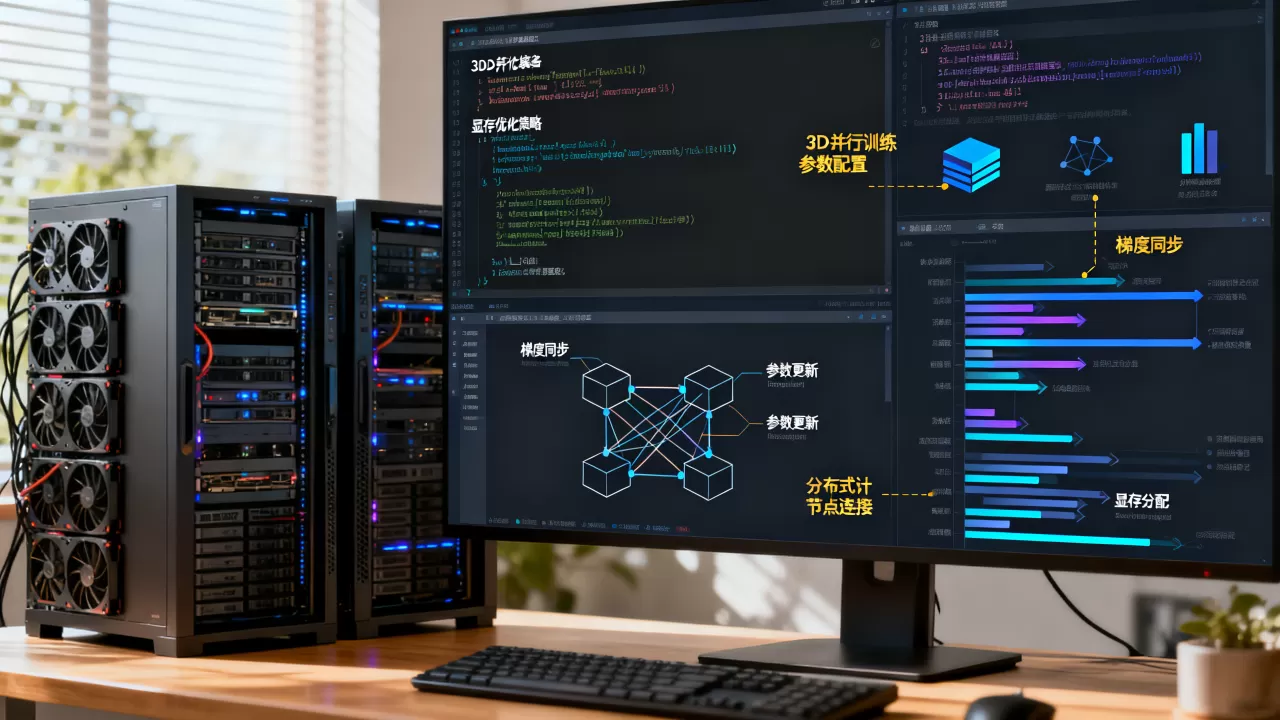
在实际工程中,单独使用任何一种并行策略都难以达到最优,业界共识认为,最佳实践是将数据并行、张量并行和流水线并行组合使用,形成3D并行。
如何分配并行维度
假设你有8个节点,每个节点8张GPU,共64张卡。
确定张量并行度
首先根据模型层宽度和单卡显存,确定TP度,如果模型很大,设置TP=4,即每张卡负责模型宽度的1/4。
确定流水线并行度
接着根据模型深度和节点数,确定PP度,如果剩余节点数为2,设置PP=2,即模型深度被切分为2段,分别跑在两个节点组上。
数据并行填充
利用剩余的并行度作为DP,在这个例子中,DP = 64 / (4 2) = 8,这意味着有8组完全相同的模型副本,每组内部通过TP和PP协同工作。
通信优化技巧
3D并行中,通信开销是性能杀手,以下措施必不可少:
- 重叠通信与计算:在GPU计算当前层时,后台线程异步执行下一层的梯度同步。
- 选择高效集合通信原语:优先使用NCCL库,并针对GPU拓扑优化Rank映射。
- 梯度压缩:在带宽受限的场景下,可使用FP16或INT8量化梯度,减少传输数据量。
实战部署中的常见陷阱
理论懂了,落地时却容易踩坑,以下是几个高频问题及解决方案。
显存泄漏排查
在分布式训练中,显存泄漏往往难以察觉,建议使用工具监控每张卡的显存使用曲线,如果发现显存随时间线性增长,通常是未正确释放中间变量或梯度累积逻辑有误。
负载均衡不均
在PP中,如果模型层计算量差异大,会导致某些阶段GPU等待,解决方法是进行模型结构重排,将计算密集的层均匀分布到不同阶段,或采用自动流水线分割工具(如PipeDream)进行优化。
断点续训配置
大模型训练耗时极长,断点续训是刚需,务必定期保存优化器状态、学习率状态和模型权重,注意,保存路径应指向高速存储(如NVMe SSD),否则I/O将成为瓶颈。
大模型分布式训练3D并行教程常见问题解答
大模型分布式训练3D并行教程中如何选择TP和PP的比例?
选择TP和PP比例主要取决于模型架构和硬件拓扑,TP受限于单节点内GPU间的通信带宽(如NVLink),因此TP度通常不超过单节点GPU数量(如8或16),PP受限于节点间通信(如InfiniBand)和模型深度,PP度通常等于节点数或节点数的因子,建议先固定TP度为单节点满配,剩余并行度尽可能分配给PP,最后用DP填充,如果模型层数较少,应优先增加TP以减少PP带来的气泡开销。
大模型分布式训练3D并行教程中显存不足怎么办?
当遇到显存不足时,可按优先级尝试以下方案:首先启用激活重计算(Recompute),用计算换显存,通常可节省50%以上的激活值显存;其次检查是否开启了不必要的梯度检查点或日志记录;尝试减小Micro-batch size,虽然这会降低吞吐量,但能缓解峰值显存;如果仍不足,考虑增加PP度或TP度,但这需要重新调整通信策略,使用混合精度训练(BF16/FP16)也是标准操作,可将显存占用减半。
大模型分布式训练3D并行教程中通信瓶颈如何优化?
通信优化是提升3D并行效率的关键,确保网络拓扑与并行策略匹配,TP应在高速互联的节点内,PP应在高速节点间,使用梯度累积技术,减少同步频率,第三,启用通信重叠(Overlap),让计算和通信并行执行,第四,对于PP,采用Gpipe或1F1B等调度策略以减少气泡,监控网络利用率,如果带宽未打满,可尝试增加DP度或优化数据加载管道,确保GPU不会因等待数据而空闲。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/391489.html

评论列表(1条)
失眠到三点硬啃这个……显存优化太香了,可惜我们这穷学生连单卡4090都凑不齐😭